skills_collection
本项目是个人开发的 Claude Code Skills 集合,提供实用的技能工具,助力提升开发效率和内容创作。 分享一些好用的 Claude Code Skills,自用、学习两相宜,适用于 Claude Code v2.0 及以上版本。
Safety scan
A static text scan, not a guarantee. Select the badge to see what was scanned and every finding.
Check it deeper on your machine
It has changed since its scan on 11 Nov 2026.
As a Claude Code plugin, install it and then ask Claude Code:
/plugin marketplace add keithmackay/mackayi/plugin install scanskillsafety@mackayiDo a deep scan of https://github.com/wwwzhouhui/skills_collection with scanskillsafety
Or from a terminal, clone it and run it:
git clone https://github.com/keithmackay/scanskillsafety-skill ~/.claude/skills/scanskillsafetynode ~/.claude/skills/scanskillsafety/cli.cjs --deep 'https://github.com/wwwzhouhui/skills_collection'
It checks the exact commit: every file, its packages against OSV (api.osv.dev), how it compares with this page's scan (findsafeskills.com receives the repository's address), and, if you agree, Claude reading every file with your own Claude subscription. It never runs the code.
Badge for your README

Markdown
[](/listings/wwwzhouhui--skills-collection)HTML
<a href="/listings/wwwzhouhui--skills-collection"><img src="/api/listings/wwwzhouhui--skills-collection/badge.svg" alt="findsafeskills safety rating" /></a>Install
What was scanned
The files the safety scan read, as written by the repository's author and shown as plain text. Lines with a finding are marked.
README.md · README · 3,277 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
This file has changed since it was scanned, so this is not exactly the text that was scanned, and no line is marked. The findings are listed with the safety scan above.
- # Claude Code Skills Collection
- 个人开发的 Claude Code Skills 集合,提供实用的技能工具,助力提升开发效率和内容创作。
- 
- 
- 
- > 分享一些好用的 Claude Code Skills,自用、学习两相宜,适用于 Claude Code v2.0 及以上版本。
- ## 项目介绍
- 本项目是个人开发的 Claude Code Skills 集合,提供实用的技能工具,助力提升开发效率和内容创作。分享一些好用的 Claude Code Skills,自用、学习两相宜,适用于 Claude Code v2.0 及以上版本。
- Claude Skills 是 Claude Code 的扩展能力,通过编写技能文档(Skill.md),可以让 Claude 在特定场景下自动激活相应的专业知识和能力。
- ### 核心功能
- - **自动化工具**: Excel 报表生成、PPT 生成、GitHub Trending 追踪
- - **内容生成**: 技术文章、公众号封面、README 文档生成
- - **公众号排版**: Markdown 一键排成公众号可粘贴 HTML(hailaobao-gzh-design)——7 套排版风格、AI 按规则改写、页面上一键复制、粘进编辑器样式全保留,零 npm 依赖
- - **AI 多模态**: 即梦 AI 图像和视频生成、Seedance 2.0 分镜视频创作、AI 教学媒体一体化(插图/信息图/教学视频/封面/解说视频)、Grok Imagine 文生图
- - **视频剪辑**: 自动化视频剪辑与解说(video-agent-kit)——通用剪辑、电影解说、足球/篮球/电竞集锦、口播配音成片(Edge TTS 免费配音)
- - **视频生成**: 口播文字稿一键成片(voice-to-video)——TTS 词级时间戳 + HTML 动画引擎 + 确定性逐帧渲染,画面/字幕/语音逐词对应,13 套画面风格
- - **动画视频**: 声明式分镜动画(hyperframes-10s-video)——一段文字 → 横屏动画视频 + 同名 SRT 字幕,时长(任意秒)/配色(10 套皮肤)/画幅(横竖屏)/配音(AI 口播)全部参数化,无头 Chromium 逐帧确定性渲染
- - **白板讲解**: 手绘白板「边画边讲」讲解视频工厂(whiteboard-video-factory)——Excalidraw 逐笔动画 + 火山/小米/edge-tts 三通道配音 + 烧录字幕(含逐段跟读高亮) + 手绘品牌层 + 三画幅封面(4:3 / 3:4 / 9:16 抖音)+ 五平台发布文案,**时长不限(2 分钟短片到 30 分钟长片同一套流水线,按场景数伸缩)**,自带查证/合规/成片验收公共工序,画面上每一笔都是代码画的,不开剪辑软件
- - **数字人口播**: IP 卡通数字人口播动画课件视频工厂(ip-talking-head-lecture)——一段逐字稿 + 一张 IP 形象图 → Remotion 成片:右下角圆形数字人常驻讲课(待机浮动 + 口型开合 + 说话光环)、主画面六套动画课件版式、字幕烧录跟读高亮,三通道配音(小米 MiMo / 火山 / edge-tts)时长由实际音频反推、音画字幕天然对齐,一条命令同出 16:9 + 9:16,自动产出各平台发布文案(YouTube 中英双语 + 章节时间轴)与中英双语 SRT/VTT,含右上角博主角标与片尾品牌卡
- - **数据采集**: 微信公众号文章获取(单篇/批量下载、元数据提取、图片下载、Markdown转换)、公众号文章聚合(按公众号名称批量采集最新文章)
- - **工作流工具**: Dify DSL/YML 文件生成器
- - **API 文档**: 硅基流动云服务平台完整文档
- - **合规审查**: 微信公众号文章合规审查(违规风险识别、修改建议)
- - **系统维护**: WorkBuddy 用户数据安全迁移(workbuddy-data-migrator)——只读预检、确认退出、完整复制与 SHA-256 校验、目录联接、备份保留及回滚
- ### 适用场景
- - Claude Code 用户扩展能力
- - 自动化办公和内容创作
- - 开源项目文档规范化
- - 技术学习和实践
- ## Skills 清单
- | Skill 名称 | 功能说明 | 技术栈 | 更新时间 | 作者 | 版本 |
- | ----------------------- | ------------------------------------------------------------ | ------------------------------------ | -------------- | ---------- | ----- |
- | workbuddy-data-migrator | WorkBuddy 数据安全迁移:将当前用户 `.workbuddy` 整目录迁到非系统盘,默认目标为 `D:\aiwork\WorkBuddy_C`;先只读检查,确认退出后复制并校验 SHA-256,保留旧备份、建立 NTFS junction,支持按本轮状态文件回滚;旧备份清理须另行确认,不把会话、数据库或身份材料当作可删除缓存 | Windows PowerShell 5.1、robocopy、NTFS junction | 2026年11月5日 | hailaobao2026 | 未标注 |
- | article-cover-generator | 文章封面 AI 生成:输入文章标题+内容(或文章文件路径),自动提炼主题视觉符号并撰写中文提示词;默认使用第三方中转站 gpt-image-2.5,也可选择魔搭社区 ModelScope 的 MiniMax/MiniMax-H3-Image,一个脚本分别适配两套异步协议并走完创建任务→轮询→下载→格式/尺寸检测;支持 16:9 / 9:16 / 3:4 / 4:3 / 1:1 五种构图比例,密钥按服务分别存技能根目录 .env,零 npm 依赖 | Node.js(≥18,内置 fetch)、gpt-image-2.5 中转站 API、ModelScope MiniMax-H3-Image API | 2026年11月17日 | wwwzhouhui | 1.1.0 |
- | wsl-disk-cleanup | WSL 磁盘一键清理:不进 WSL Linux 终端、不用管理员权限,通过 Windows 侧 `wsl.exe` 完成「枚举发行版 → 只读扫描 Docker 容器/镜像/卷/占用 → 列清单用户确认范围 → 停用 1Panel 防容器自愈重建 → Docker 全清 → ext4.vhdx 原生压缩 → 前后对比报告」。脚本经 stdin 管道送入 WSL 执行(避开命令替换与路径转换陷阱);`--compact` 前自动处理 sparse 互斥;WSL ≥ 3.0.3 即可,旧版降级 diskpart 方案内置。实测:vhdx 80G→57G、Docker 数据 24G→150M、宿主机磁盘可用 +8G | Bash、wsl.exe(WSL 3.0.3+)、Docker CLI、systemd | 2026年10月17日 | wwwzhouhui | 1.0.0 |
- | html-video | HTML→Video 元层 + 中文口播片流水线:封装上游 [nexu-io/html-video](https://github.com/nexu-io/html-video)(Hyperframes + Remotion 双引擎、23 模板、自带 studio 网页端),沉淀**让它在 Windows 跑通并稳定产出中文口播/科普讲解片**的全部增量。核心能力:① 不走模板、`writeFrameHtml()` 直接喂任意动画 HTML 的多帧出片最短路径;② **节拍驱动揭示**(画面按解说句级时间轴逐拍展开,每 3–5 秒有可见变化,杜绝「动画放完干等解说」);③ **逐词卡拉OK字幕**(纯黑底 colorkey 抠底叠加,有无字幕两版同源可独立验收);④ **品牌三件套**全走图层叠加、主片零重渲(右上角作者角标 inline-flex 贴角 / 深色片尾卡 concat+anullsrc / 右下 IP 数字人**真实响度包络驱动口型**,20Hz RMS→p15/p90→快攻慢释,`@property inherits:true` 烘 6000 停关键帧,单 IP 配置可选);⑤ **5 个质检工具**机器判据可进门禁(停滞量化 / 节拍对齐 / 口型-配音同步 / 字幕几何 / 版式描线依赖扫描);⑥ 竖屏 9:16 四件事(字幕几何实测重标 / 短行拆分 / 安全带放大 / 版式转纵向)。对上游四处未提交补丁:Windows 构建(`chmod` 跨平台)、doctor 探测(`where` + Playwright Chromium)、录制开头裁剪加开关(`HV_LEADIN_TRIM` / `HV_TRIM_WHITE_HEAD`)、跨帧复用浏览器(`HV_REUSE_BROWSER`,默认关行为与上游一致)。全部本机完成,无按次渲染费用、不开剪辑软件 | Node.js(pnpm 9 / corepack)、ffmpeg 6.x、Playwright 无头 Chromium、Hyperframes + Remotion 双引擎、TTS(小米 MiMo / 火山 / edge-tts)、colorkey 图层合成 | 2026年10月3日 | wwwzhouhui | 1.0.0 |
- | ip-talking-head-lecture | IP 卡通数字人口播动画课件视频工厂:一段逐字稿 + 一张 IP 形象图 → Remotion 成片。主讲 IP 以圆形头像常驻右下角讲课(待机浮动 + 三帧口型开合 + 说话光环 + 声波条),主画面自动排版的六套动画课件版式(封面 / 概念 / 步骤 / 对比 / 数据 / 总结),底部烧录字幕并做跟读高亮,品牌水印 + 顶部进度条 + **右上角可自定义博主角标** + **片尾自动追加品牌卡**(标识图或手写名 + 品牌色划线 + slogan + 黄色便签 CTA);配音三通道(小米 MiMo / 火山引擎逐字对齐 / edge-tts 免费备胎),**时长由 TTS 实际音频反推**——改一句旁白重新 build 整体自动重排,画面、配音、字幕天然对齐,不手写任何帧数;一条命令同时出 16:9 横屏与 9:16 竖屏(另支持 1:1);内置两套口播形象(动物卡通·海老豹 / 人物卡通·眼镜青年)一键切换、加新形象只需一个目录三帧图;自动产出各平台发布文案(视频号 / 小红书 / 抖音 / B 站 / 公众号 + YouTube 中英双语标题描述与自动合并的章节时间轴)与中英双语字幕(SRT + VTT);全链路本地(Remotion + ffmpeg + TTS),无剪辑软件、无联网渲染 | Node.js、TypeScript、React、Remotion、小米 MiMo TTS / 火山引擎 TTS / edge-tts、ffmpeg | 2026年10月3日 | wwwzhouhui | 1.2.0 |
- | whiteboard-video-factory | 手绘白板「边画边讲」讲解视频工厂:一句话选题 → 查证、写旁白、出 Logo 与贴纸、画场景、配音对字幕、逐笔渲染、混配乐、出封面、写发布文案全链路本地完成。rough.js + SVG dashoffset 逐笔手绘动画(场景可导出 Excalidraw 回灌渲染),TTS 逐字时间戳同时驱动画面排期与字幕切句(小米通道无时间戳时用静音检测估算),字幕支持**逐段跟读高亮**(卡拉OK式,念到哪一段那一段字转反白、背后套品牌色块,火山/小米/edge 三引擎通用),4 路独立 Chromium 确定性出帧(`framemd5` 可验 0 帧差),三套配音通道(火山引擎 / 小米 MiMo / edge-tts 免费备胎),**时长不限**(渲染按场景分段出片再 concat、TTS 逐场景缓存,场景数不受限,2 分钟到 30 分钟同一套流水线;长片配 `bgm.playlist` 多首轮播避免单曲循环),三画幅封面一次出(4:3 / 3:4 / 9:16 抖音),五平台发布文案(视频号 / 小红书 / 抖音 / B 站 / 公众号),自带事实核查、合规自查、成片验收与交付边界公共工序 | Node.js、Playwright(无头 Chromium)、rough.js、Excalidraw DSL、火山引擎 TTS / 小米 MiMo TTS / edge-tts、ffmpeg | 2026年9月29日 | wwwzhouhui | 1.0.0 |
- | hyperframes-10s-video | HyperFrames 声明式分镜动画视频技能:一段文字 → 横屏动画视频 + 同名 SRT 字幕。**三个维度全参数化**——① 时长任意(`--total=` 或 `duration` 字段,各幕按比例精确归一,长片靠加幕);② 配色 10 套皮肤(tech/wuding/aurora/sunset/ocean/forest/midnight/gold/candy/paper,附可视化画廊 + 预览页实时换肤);③ 音频可选(默认无声无音轨,edge-tts 配音一键混音)。含 9 种场景类型、抽帧核验、字幕自动生成(不手写)、横竖屏可切换 | Node.js、GSAP、无头 Chromium、ffmpeg、Python(edge-tts) | 2026年9月24日 | wwwzhouhui | 2.0.0 |
- | hailaobao-gzh-design | 公众号排版技能:AI 按改写规则把 Markdown 文章重排为编辑部风格(序号竖线标题、kicker 语义匹配、金句引用、摘要/信息卡片),**7 套内置风格**(玉石商务、暖色编辑部、极客单色、香槟品牌、雾霾笔记、午夜研究报告、森绿演示),一键生成带「复制到公众号」按钮的自包含 HTML,粘贴到公众号编辑器样式全保留;原始 Markdown 不改、总改动 ≤30%、代码块一字不动 | Node.js(≥16,ESM)、零 npm 依赖 | 2026年9月24日 | hailaobao2026 | 1.0.0 |
- | poetry-cinema-page | 沉浸式古诗词网页生成技能:给一首中国古典诗词,走完文学分镜 → 视觉圣经 → 双服务商逐张生图(火山方舟 Doubao Seedream 5.0 / GPT-Image 网关,四档位可混用,主视觉参考链)→ 联系表检查 → 朗诵配音(edge-tts / 豆包 seed-tts-2.0,23 个中文音色)→ 滚动页面 → 浏览器验收,可选 Remotion 口播视频成片 | Python、火山引擎方舟、GPT-Image 网关、edge-tts、Vite/TypeScript、Remotion、ffmpeg | 2026年9月22日 | wwwzhouhui | 1.0.0 |
- | remotion-video-factory | 视觉优先的程序化视频生产流水线:Remotion + React 代码渲染精确图形动画(矩阵/连线/图表/数字滚动/流程图解),edge-tts 中文配音自动测长并重建时间线,三层音频(配音/BGM/SFX 钉帧表),确定性渲染,双版本成片交付 | TypeScript、React、Remotion、edge-tts、ffmpeg | 2026年9月7日 | wwwzhouhui | 1.1.0 |
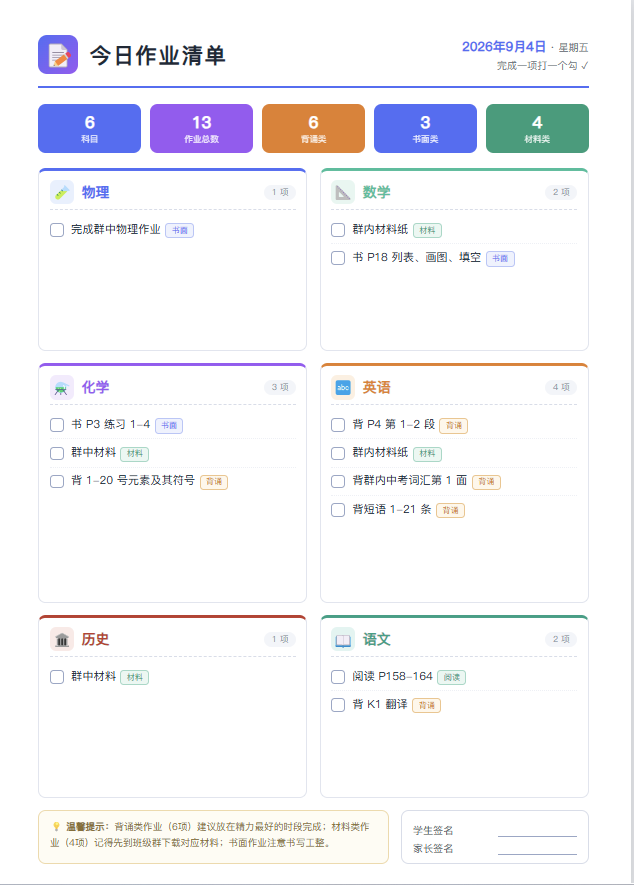
- | photo-homework-a4 | 将拍照上传的手写作业清单识别、按科目整理并分类打标,基于固定模板生成一页 A4 纸即可打印的 HTML 作业清单,包含科目卡片、统计条、温馨提示和学生/家长签名区 | HTML/CSS、模板生成、图像识别、A4 打印 | 2026年9月5日 | wwwzhouhui | 1.0.0 |
- | voice-to-video | 口播文字稿一键成片技能包:Edge TTS 配音(逐词时间戳)→ 一句口播一个场景的 HTML 动画合成 → 无头浏览器逐帧确定性渲染 MP4,文字稿/语音/画面逐词对应;13 套画面风格(每套含独立版式 DNA) | Python、edge-tts、Playwright、HTML/CSS/JS、ffmpeg | 2026年9月5日 | wwwzhouhui | 1.4.0 |
- | video-agent-kit | 自动化视频剪辑与解说视频技能包:通用剪辑、电影解说(几分钟看完)、足球/篮球集锦、LOL 电竞集锦、口播配音成片,37 个 MCP 工具(抽帧理解/时间线/渲染/QC),TTS 默认 Edge TTS 免费开箱即用 | Python、MCP、ffmpeg、OpenCV、Edge TTS | 2026年8月29日 | wwwzhouhui | 0.4.3 |
- | knowledge-absorber | 深度解析链接/文档/代码,生成导师级教学笔记 + Wan 2.7 知识海报。支持 PDF/Word/Markdown/代码/图片,自动真理锚定验证,国学内容自动水墨风格,11 种海报风格可选 | Python、DashScope API、Wan 2.7、真理锚定验证、信息图设计 | 2026年4月11日 | zlu | 0.0.1 |
- | ai-teaching-media | AI 教学媒体一体化技能包:一个目录串联 6 个子能力(生图执行层、技术长文插图、学科信息图、教学动图/视频、短视频封面、文章解说视频),支持知识点/长文全套教学生产链路 | Python、HyperFrames、Minimax TTS、Nano Banana 2 / GPT Image 2 / Agnes Image 2.1 Flash | 2026年7月19日 | wwwzhouhui | 1.0.0 |
- | grok-imagine-image | 使用 grok-imagine-image 模型,通过兼容 Grok2API / OpenAI 风格接口(`/v1/images/generations`)文生图;自带本地脚本,支持环境变量/参数覆盖、URL 改写下载、JSON 输出 | Python、Grok2API、OpenAI Images API | 2026年7月26日 | hailaobao2026 | 1.0.0 |
- | github-trending-wan | GitHub Trending Top 5 中文信息图海报生成器,抓取热门项目→翻译中文摘要→生成 Wan 2.7 海报 Prompt→可视化海报,支持 10 种视觉风格,3 步引导式工作流 | Python、DashScope API、Wan 2.7、信息图设计 | 2026年4月8日 | hailaobao2026 | 1.0.0 |
- | wan-cover-plus | 使用 Wan2.7-image 生成公众号封面图、小红书封面图、种草图和海报改版视觉稿,并支持文生视频、静态图转丝滑动态视频、参考图/参考视频转视频,以及为视频自动补 Edge TTS 配音与字幕烧录 | Bash、Python、Wan API、Edge TTS | 2026年4月5日 | hailaobao2026 | 1.0.0 |
- | wechat-compliance-reviewer | 微信公众号文章合规审查专家,根据微信公众平台运营规范审查文章内容,识别违规风险点并给出修改建议,支持诱导分享/欺诈信息/营销推广/版权侵权等 9 大类违规检测 | Markdown、模板系统、合规审查 | 2026年3月29日 | hailaobao2026 | 1.0.0 |
- | obsidian-search | Obsidian CLI 查询助手,根据自然语言检索需求生成合适的 Obsidian CLI 查询命令,支持搜索笔记、查找上下文、筛选任务、标签、属性、反链、文件列表等 | Bash、Obsidian CLI | 2026年3月13日 | hailaobao2026 | 1.0.0 |
- | xiaohuihui-tech-article | 专为技术实战教程设计的公众号文章生成器,遵循小灰灰公众号写作规范,集成Gemini-3-Pro-Image-Preview双通道(自建API+Gemai公益站)自动配图与腾讯云COS上传功能,自动生成包含公众号卡片、前言、项目介绍、部署实战、总结、往期推荐的完整技术文章 | Markdown、模板生成、Gemini API、Gemai API、腾讯云COS | 2026年2月23日 | hailaobao2026 | 2.4.0 |
- | wechat-article-aggregator | 微信公众号文章聚合器,通过 mptext.top API 批量获取指定公众号博主的最新文章,支持按名称或 fakeid 获取,预置 8 个热门 AI 技术公众号,输出 Markdown/HTML/Text/JSON 格式 | Python、requests、BeautifulSoup、html2text、mptext API | 2026年2月23日 | hailaobao2026 | 1.0.0 |
- | seedance-video-creator | Seedance 2.0 分镜视频创作工具,三阶段工作流(分镜提示词→文生图首帧→图片+提示词生成视频),默认使用 seedance-2.0-fast 模型,支持多图参考、6 套分镜模板,自动生成首帧参考图,一键生成视频并自动下载 | Bash、curl、即梦 API、Seedance 2.0 | 2026年2月22日 | hailaobao2026 | 1.2.0 |
- | wechat-article-fetcher | 微信公众号文章获取器,支持单篇和批量下载,自动提取标题、作者、公众号名称、正文、图片等元数据,支持转换为 Markdown 格式,自动下载文章图片到本地 | Python、requests、BeautifulSoup、html2text | 2026年2月22日 | hailaobao2026 | 1.0.0 |
- | github-readme-generator | 专业的 GitHub 项目 README.md 生成器,自动生成符合开源社区规范的文档结构,支持 6 种项目模板(basic/full/library/webapp/cli/api),交互式生成和自动识别项目类型 | Markdown、文档生成、模板系统 | 2026年1月23日 | hailaobao2026 | 1.0.0 |
- | github-trending | 获取 GitHub Trending 前五项目 README 与摘要,并发送企业微信消息,适用于热门项目跟踪、技术趋势简报与团队分享 | Python、GitHub Trending、企业微信机器人 | 2026年1月22日 | hailaobao2026 | 1.0.0 |
- | jimeng_mcp_skill | AI 图像和视频生成技能,升级至 jimeng-4.5 模型,支持 ratio/resolution 新参数系统,文生图、图像合成、文生视频、图生视频四大核心能力 | MCP、Python、Docker、即梦 AI | 2025年12月14日 | hailaobao2026 | 2.0.0 |
- | xiaoppt-generator-skill | 基于商务模板的专业 PPT 生成器,支持固定 25 页结构(封面→目录→4章节→结束),提供暖色调、商务简约、莫兰迪色系三种主题风格,支持 JSON 配置和代码调用 | Python、python-pptx | 2025年12月4日 | hailaobao2026 | 1.0.0 |
- | dify-dsl-generator | 专业的 Dify 工作流 DSL/YML 文件生成器,根据用户业务需求自动生成完整的 Dify 工作流配置文件,支持各种节点类型和复杂工作流逻辑 | YAML、Dify DSL、工作流设计 | 2025年11月22日 | hailaobao2026 | 1.0.0 |
- | xiaohuihui-dify-tech-article | 专为 Dify 工作流案例分享设计的公众号文章生成器,遵循小灰灰公众号写作规范,自动生成包含前言、工作流制作、总结的完整 Dify 案例文章 | Markdown、Dify、腾讯云 COS | 2025年11月22日 | hailaobao2026 | 1.0.0 |
- | siliconflow-api-skills | 硅基流动(SiliconFlow)云服务平台文档技能,提供大语言模型 API 调用、图片生成、向量模型、Chat Completions API、Stream 模式等完整文档和最佳实践 | API、Python、REST、LLM | 2025年11月19日 | hailaobao2026 | 1.0.0 |
- | mp-cover-generator | 公众号封面生成器,根据主题和标题生成现代风格的公众号封面图,支持描边卡通字体、垂直居中布局,可输出 HTML 和高清图片(PNG/JPG),使用 Playwright 实现完整页面截图 | MCP、HTML/CSS、Node.js、Playwright、即梦 AI | 2025年11月15日 | hailaobao2026 | 3.1.1 |
- | excel-report-generator | 自动化 Excel 报表生成器,支持从 CSV、DataFrame、数据库生成专业 Excel 报表,包含图表、样式、模板填充等高级功能 | Python、pandas、openpyxl、xlsxwriter | 2025年11月12日 | hailaobao2026 | 1.0.0 |
- ## Skill 功能详解
- ### 🗂️ WorkBuddy Data Migrator(WorkBuddy 数据安全迁移)
- **核心功能:**
- - ✅ **先检查、后确认**:只读检查数据体积、文件数、相关进程、目录联接状态、目标磁盘与空间;获得明确迁移授权且用户确认完全退出 WorkBuddy 后才搬迁
- - ✅ **整目录保留**:默认源为 `%USERPROFILE%\.workbuddy`,默认目标为 `D:\aiwork\WorkBuddy_C`;目标就是最终数据目录,不再追加 `.workbuddy`,用户明确指定其他路径时以本次指定为准
- - ✅ **完整性校验**:robocopy 复制前后检查源和目标的 SHA-256 清单;拒绝非空目标、目录嵌套及不支持的重解析点,不跳过异常文件继续搬迁
- - ✅ **原入口可用、旧数据可回退**:原目录改名保留为备份,以 NTFS junction 维持原入口;按本轮状态文件回滚,迁移后数据有变化时默认拒绝回滚
- - ✅ **不默认清理**:不强杀进程、不自动提权、不改登录协议、不上传数据;旧备份保留期间 C 盘对应占用仍在,删除备份必须另行确认
- **工作流程:**
- 只读预检 → 展示精确路径与备份策略 → 确认授权并退出软件 → 完整复制与 SHA-256 校验 → 保留原目录备份并建立 junction → 用户验证登录、历史会话与新内容持久化。文件校验不能替代应用验收。
- **关键命令(仅检查,不迁移):**
- ```powershell
- $tool = Join-Path $env:USERPROFILE '.agents\skills\workbuddy-data-migrator\scripts\workbuddy-migrate.ps1'
- & $tool -Action Inspect -Target 'D:\aiwork\WorkBuddy_C'
- ```
- 实际迁移与回滚必须按 [技能说明](workbuddy-data-migrator/SKILL.md) 完成确认,不把预设路径或命令示例视为授权。
- **适用场景:**
- - WorkBuddy 的 `.workbuddy` 占用系统盘,希望整目录迁到其他本地固定 NTFS 盘
- - 先了解数据体积和迁移条件,不立即搬迁
- - 迁移后需要保留历史数据并有明确回滚入口
- **安装与验证边界:**
- 在 ZCode 中使用 `%USERPROFILE%\.agents\skills\workbuddy-data-migrator` 入口;技能真实文件可由仓库维护,原入口保留目录联接。本次入库验证为技能文件完整性、语法与当前会话加载,未执行真实 WorkBuddy 数据迁移。安装、目录联接与回滚方法见 [维护说明](docs/workbuddy-data-migrator.md)。
- ### 🖼️ Article Cover Generator(文章封面 AI 生成)
- **核心功能:**
- - ✅ **文章 → 封面一条龙**:输入文章标题 + 内容(或文章文件路径),自动提炼主题与视觉符号、按模板撰写中文提示词并把图片下载到本地
- - ✅ **双模型可选**:默认第三方中转站 `gpt-image-2.5`;通过 `--model MiniMax/MiniMax-H3-Image` 选择魔搭社区 ModelScope 的 MiniMax-H3-Image,两套创建/轮询协议由同一脚本分别适配
- - ✅ **五种构图比例**:16:9(公众号头图)/ 9:16(短视频竖版)/ 3:4(小红书)/ 4:3(默认)/ 1:1;GPT 路径发送 size,ModelScope 路径把比例写入提示词,均以下载图片的实际尺寸和人工预览为准
- - ✅ **异步任务全封装**:选择模型 → 创建任务 → 轮询原任务 → 下载 → PNG/JPEG/WebP 格式与尺寸检测,末行输出机器可读 JSON(path/width/height/task_id/provider/model)
- - ✅ **密钥不进代码**:GPT 与 ModelScope 密钥分别存技能根目录 `.env` 或当前进程环境变量,推荐使用 `ARTICLE_COVER_*` 命名空间;端点与密钥必须来自同一配置来源,`.env.example` 只放空占位符,`.gitignore` 已排除真实 `.env`
- - ✅ **防重复计费**:创建请求只提交一次;发送后连接中断时不会自动再建任务,已有 task_id 的轮询网络错误只查询原任务
- - ✅ **零依赖**:只需 Node.js ≥ 18(内置 fetch),无 npm 包;附 12 项模拟接口测试(本轮在 Windows Node.js v24.21.0 通过)
- **工作流程:**
- 确认标题/内容/比例/模型(缺省 4:3 + gpt-image-2.5)→ 读文章提炼核心视觉符号(2~4 个,不堆砌)→ 按模板写中文提示词 → `gen_cover.mjs` 走所选模型的异步协议 → 本地预览核对文字、构图和比例后交付
- **关键命令:**
- ```bash
- # 默认 gpt-image-2.5
- node article-cover-generator/scripts/gen_cover.mjs --prompt-file prompt.txt --ratio 16:9 --out 封面.png
- # 魔搭社区 MiniMax-H3-Image
- node article-cover-generator/scripts/gen_cover.mjs --model MiniMax/MiniMax-H3-Image --prompt-file prompt.txt --ratio 16:9 --out 封面.png
- ```
- **适用场景:**
- - 公众号 / 博客文章封面图与题图
- - 一篇文章多比例分发(横版头图 + 竖版小红书封面)
- - 与 `hailaobao-gzh-design`(排版)、`mp-cover-generator`(卡通字封面)、`grok-imagine-image`(通用文生图)互补
- **配置说明(首次使用):**
- 复制 `.env.example` 为 `.env`。GPT 填 `ARTICLE_COVER_API_KEY`(`ARTICLE_COVER_API_BASE` 可选);MiniMax 填 `ARTICLE_COVER_MODELSCOPE_API_KEY`(对应 BASE 可选)。`--model` 优先于 `ARTICLE_COVER_MODEL`;技能目录 `.env` 兼容旧配置名,进程环境只读取 `ARTICLE_COVER_*`,并只校验当前模型的密钥。同一服务的 BASE 与 KEY 必须来自同一配置来源。`.env` 含密钥,勿提交或截图分享。详细协议、配置、验证和回滚见 [维护说明](docs/article-cover-generator.md)。
- **效果图:**
- 
- ### 🧩 HTML Video Meta(html-video —— HTML→MP4 元层 + 中文口播片流水线)
- **核心功能:**
- - ✅ **上游引擎本机化**:封装 [nexu-io/html-video](https://github.com/nexu-io/html-video)(Apache-2.0,Hyperframes + Remotion 双引擎、23 模板、自带 studio 网页端),补四处未提交补丁后 Windows 全功能可用:`pnpm -r build` 构建修复(POSIX chmod → 跨平台)、`doctor` 体检修复(`where` 探测 + 识别 Playwright 自带 Chromium)、录制开头裁剪加开关、跨帧复用浏览器(见下)
- - ✅ **口播片最短路径(不走模板)**:`bootstrap()` 复用 CLI wiring → `writeFrameHtml()` 喂**任意自定义动画 HTML** → content-graph 写 `durationSec` 硬时长(= 实测配音 + 0.6s 尾巴)→ `exportMp4()`;改口播稿 → 重跑 TTS → 重渲,音画时间轴同源
- - ✅ **节拍驱动揭示**:帧源只标 `data-beat=N` / `data-at=秒`,`animation-delay` 由构建期从配音 SRT 句级时间轴反算——画面每 3–5 秒一次可见变化、跟解说逐句走;相位提前量(实测随机器负载 0.31–0.75s 浮动)取多轮中位数并每轮复核
- - ✅ **逐词卡拉OK字幕**:字幕层单独渲染纯黑底视频,`colorkey` 抠底叠加——有字幕/无字幕两版同源,字幕像素可独立验收(胶囊三态:未读/正在读高亮/已读)
- - ✅ **品牌三件套全走图层叠加、主片零重渲**:右上角作者角标(playwright 透明 PNG + `inline-flex` 紧贴真角落);深色片尾卡(单帧项目 + `anullsrc` 静音 + concat filter,配色对齐主片 token);右下 IP 数字人(**真实响度包络驱动口型**:narration.wav → 20Hz RMS → 说话窗 p15/p90 归一 → γ0.75 → 快攻慢释,烘进 `@property --m`(必须 `inherits:true`)6000 停关键帧;words.json 说话区间门控 `--spk` 管光环/声波条/收口;`brand.json` `layer.active` 单 IP 可选)
- - ✅ **5 个质检工具,机器判据可进门禁**:measure-motion(停滞量化,双阈值并报防低对比误判)/ probe-phase(权威节拍复核)/ verify-beat-sync(交叉参考,含 3 种测量陷阱说明)/ check-mouth-sync(口型-配音同步:响/轻/间隙三组口部亮度 + 包络相关性)/ verify-subtitle(字幕几何按视频高度实测重标)
- - ✅ **录制裁剪开关(上游没有的关键补丁)**:`HV_LEADIN_TRIM=0` 跳过墙钟裁剪(防 newPage 被拖到 ~10.7s 时整段动画被静默裁光、每帧只剩 262 字节空文件);`HV_TRIM_WHITE_HEAD=1` 帧级白屏头检测消多镜头切换白闪。**默认全关,行为与上游逐字节一致**
- - ✅ **竖屏 9:16 四件事**:libass 字号按视频高度缩放要逐档实测;字幕先拆 ≤22 字短行再合;底部安全带 158→300px;版式全面转纵向堆叠
- - ✅ **12+ 条实测坑沉淀**:`<path pathLength="1">` 必写(否则描线动画变 1px 点线,墨量恰 50%)、帧内零外链(防字体 CDN 拖慢 + FOUT)、concat filter 不可用 demuxer(8s 变 35s)、`@property inherits` 坑、冻结式 QA 被 `[data-beat]` 特异性反杀(正解 Web Animations API)……全部来自 4 条成片、5 遍全量重渲
- **实践成品:** qwen38-omni-video 项目(文章链接 → 7 场 / 306.58s 中文口播片,含逐词字幕 + 品牌三件套,README 附全部验收读数:停滞 0.5s、口型 corr 0.53、五图层 PSNR 全绿、−16.1 LUFS)。
- ### 🎤 IP Talking Head Lecture(IP 数字人口播动画课件视频工厂)
- **核心功能:**
- - ✅ **一句话概括工作流**:写一个 `script.json`(每场景一段 `narration` 旁白 + `heading` 标题 + `kind` 版式 + `data` 内容槽)→ `iph all <期>` → 拿到 mp4;期目录、配音、时间轴、字幕、发布文案全部由命令生成,**唯一手写的就是 script.json**
- - ✅ **IP 数字人常驻讲课**:主讲形象以圆形头像常驻右下角(横屏)/ 底部(竖屏),待机时极缓浮动,说话时三帧口型(闭口/微张/张口)随音频开合,外圈品牌色「说话光环」+ 声波条;内置两套形象可一键切换——动物卡通(海老豹)与人物卡通(眼镜青年),加新形象 = 一个目录放三帧同名图 + config 登记一行,`iph avatars` 即可见
- - ✅ **六套动画课件版式**:封面 cover / 概念 idea / 步骤 steps / 对比 compare / 数据 numbers(数字滚动 countUp)/ 总结 recap,横屏走左右分栏多列、竖屏自动改纵向堆叠;每个场景按旁白逐条揭示要点,画面跟着声音走
- - ✅ **时长由实际音频反推**:TTS 逐场景合成后用真实音频时长重建时间轴(lead + 音频 + tail),每个词的时间戳同时驱动字幕切句与跟读高亮——改一句旁白重新 build 就整体重排,不需要手调任何帧数
- - ✅ **三通道配音**:小米 MiMo TTS(默认,小句级时间戳)/ 火山引擎(逐字对齐,支持声音复刻)/ edge-tts 免费备胎;语速、响度、音色全在 `config.json`,凭证走 `.env`
- - ✅ **品牌层可配置**:左下水印、**右上角博主角标**(`brand.corner`,text 留空自动用 `brand.name`,可关)、顶部场景进度条,以及**片尾品牌卡**(`brand.endCard`:build 时自动在末尾追加一个静音 outro 场景——标识图或手写体博主名 + 星花 + 品牌色划线逐笔画出 + slogan + 黄色便签 CTA「点赞 · 关注 · 评论区聊聊」),`brand.logo` 给图就代替手写名
- - ✅ **一条命令双画幅**:16:9(1920×1080,B 站/课程)与 9:16(1080×1920,抖音/视频号/小红书)同时出片,另支持 1:1;crf、并行度可调
- - ✅ **发布物料一并产出**:中文 SRT/VTT +(条数对齐时)英文 SRT/VTT、旁白稿表格、各平台发布文案(视频号 / 小红书 / 抖音 / B 站 / 公众号 + YouTube 中英双语标题描述与**自动合并的章节时间轴**,满足 YouTube ≥3 章、每章 ≥10s 的规则)
- - ✅ **确定性本地渲染**:Remotion + ffmpeg 全本地,无需剪辑软件、无需云端;配音与逐场景产物带缓存,只改文案时秒级重发布案
- **工作流程:**
- `iph new "<标题>"` 建期 → 写 `episodes/<期>/script.json`(口播短句、heading ≤12 字)→ `iph voice` 配音自检 → `iph build <期>`(TTS + 时间轴 + 字幕 + 发布文案)→ `iph still` 抽静帧查版式 → `iph render` 出成片 → 抽帧目视验收(角标 / outro / 字幕高亮)→ 交付
- **关键命令:**
- ```bash
- SK="~/.claude/skills/ip-talking-head-lecture"
- I="$SK/bin/iph"
- $I new "Meta Muse国内0门槛注册全攻略" # 建期目录 + script.json 模板
- $I voice # 配音自检:回显引擎/音色/端点并真跑一句
- $I build "Meta Muse国内0门槛注册全攻略" # TTS + 时间轴 + 字幕 + 发布文案
- $I still "Meta Muse国内0门槛注册全攻略" 8 # 第 8 秒静帧,看版式
- $I render "Meta Muse国内0门槛注册全攻略" --ratio=16:9,9:16
- $I all "Meta Muse国内0门槛注册全攻略" # build + render 一条龙
- $I avatars # 列出可用口播形象
- $I preset human # 切换默认形象(写进 config.json)
- $I srt "Meta Muse国内0门槛注册全攻略" # 只看字幕条时间与文本
- ```
- **参数速查:**
- | 维度 | 在哪儿改 | 默认 |
- | --- | --- | --- |
- | 配音引擎 / 音色 / 语速 | `config.json` → `tts.engine`(`mi` / `volc` / `edge`)、`tts.voice`、`tts.speed` | 小米 MiMo · 冰糖 @1.15x |
- | TTS 凭证 | `.env`(`VOLC_TTS_API_KEY` / `MI_TTS_API_KEY` 等,**勿提交**) | — |
- | 画幅集合 / 帧率 / 并行度 | `video.ratios` / `fps` / `concurrency` | 16:9 + 9:16 / 30 / 4 |
- | 节奏 | `pacing.leadPadding` / `tailPadding` / `minSceneSeconds` / `sceneGap` | 0.85 / 0.7 / 3.2 / 0.25 |
- | 品牌层 | `brand.name` / `accent` / `slogan` / `corner` / `endCard` / `logo` | 见 config |
- | 数字人形象 | `avatar.preset` 或 `iph preset <名>`;形象目录三帧 `image/mouth-mid/mouth-open` | haibao |
- | 字幕切句 | `cues.*`(每句字数上下限等) | 见 config |
- | 期目录 / 产物目录 | `dirs.projects` / `dirs.build` | `episodes/` / `build/` |
- **目录要点:** `bin/iph`(CLI:new / build / publish / render / all / still / srt / voice / kinds / avatars / preset)、`lib/build.mjs`(script.json → 配音 → timeline-16x9/9x16.json + 字幕 + 发布文案,时间轴是"整个视频的唯一真相")、`lib/tts/`(小米 / 火山 / edge 三通道)、`lib/publish.mjs`(各平台文案渲染)、`remotion/`(React 工程:`SceneShell` 品牌层与角标、`scenes/index.tsx` 六套版式 + outro、`Avatar` 口型数字人)、`references/`(script-format / avatar / voices / publish / delivery-qa 五份)、`templates/`(每期 script.json 模板)
- **适用场景:** 有固定 IP 形象(卡通头像即可)的知识口播 / 工具实测 / 热点讲解账号内容;一条稿子要同时喂 B 站横屏与抖音/视频号竖屏;需要改一句话就整体自动重排、拒绝手调时间轴;与 `whiteboard-video-factory`(手绘白板边画边讲)、`voice-to-video`(无形象口播逐词成片)、`remotion-video-factory`(纯图形动画)互补,覆盖「有 IP 真人感出镜」这一环
- **示例成片:** 《Meta Muse 爆火,国内 0 门槛注册全攻略》——8 场景 + 自动片尾卡,128.2 秒,16:9 与 9:16 双画幅一次出,含中英双语字幕与各平台发布文案(由文章稿 → `script.json` → `iph all` 全流程产出),点击下方播放器直接在线观看
- **横屏 16:9(1366×768):**
- <p align="center">
- <video src="https://github.com/user-attachments/assets/7269fb42-47e7-4b49-bba8-52acab3f5784" controls muted playsinline width="100%"></video>
- </p>
- **竖屏 9:16(768×1366):**
- <p align="center">
- <video src="https://github.com/user-attachments/assets/7d425a7d-43d1-4dd6-9fcd-9060bf56fe21" controls muted playsinline width="45%"></video>
- </p>
- ### 🖊️ Whiteboard Video Factory(手绘白板「边画边讲」讲解视频)
- **核心功能:**
- - ✅ **一句选题 → 一条成片**:查证 → 写旁白(按 `|` 切 beat)→ 出 Logo 与贴纸 → 画场景 → 配音对字幕 → 逐笔渲染 → 混配乐 → 出封面 → 写发布文案,全链路本地跑,不开剪辑软件、不露脸
- - ✅ **逐笔手绘动画**:rough.js(Excalidraw 底层同款)生成线条,SVG `stroke-dashoffset` 按子路径顺序描边、rough.js 的「每条边描两遍」拆成 A/B 两层错时浮现,笔尖跟着走;场景同时导出 Excalidraw 格式,能在 Obsidian 里改图再回灌渲染
- - ✅ **音画同步不拍时间轴**:TTS 返回的逐字时间戳同时驱动画面排期与字幕切句(6~20 字),改一句旁白只重配那一段
- - ✅ **配音双通道**:火山引擎语音合成(官方音色或自己的声音复刻,默认 1.2 倍语速)/ 没有凭证时切 edge-tts 免费出片,两者输出同格式逐字时间戳,字幕链路不用改
- - ✅ **贴纸与真实 Logo**:贴纸走本地 codex CLI 出 2×2 四宫格(一次额度同风格,自动抠白底、去杂点、去邻格残片);公司/产品 logo 走 Wikimedia Commons 官方 SVG,`--vs` 可拼 A VS B 对比封面图,出处自动记录
- - ✅ **确定性并行渲染**:4 路独立 Chromium 交错出帧,主进程按帧号顺序喂 ffmpeg;`workers=1` 与 `workers=4` 出的帧用 `framemd5` 比对必须 0 帧不同
- - ✅ **三画幅封面一次出**:同一个 `coverLayout` 出 4:3(1440×1080)/ 3:4(1080×1440)/ 9:16(1080×1920 抖音,内容压在中央安全区),标题 ≤2 行、钩子行自动马克笔高亮
- - ✅ **品牌层自动带**:右上角手写水印(第一幕逐笔画入)+ 片尾品牌卡 + 封面品牌标,名字 / 品牌色 / slogan 都在配置里
- - ✅ **自带公共工序(合并自 `video-common`)**:事实核查与来源台账、发布前合规自查、成片机器与目视验收、交付边界,全部收在 `references/`,装一个目录即可跑
- **工作流程:**
- 选题 → 查证(数字进期目录 `README.md`)→ 写旁白(`scenes.js`)→ `wb logo` / `wb image` 出素材 → 画场景 → `wb stills` 逐 beat 静帧检查 → 写 `cover` 函数出三张封面 → `wb build` 一条龙出片(TTS + 渲染 + 混音 + 封面)→ 抽帧验收 → 写 `发布.md`(五平台文案)
- **关键命令:**
- ```bash
- SK="~/.claude/skills/whiteboard-video-factory"
- W="$SK/bin/wb"
- $W new "为什么定了计划总是坚持不下去" # 建期目录(scenes.js + 发布.md 模板)
- $W logo "标题" logo-claude="Claude AI symbol.svg" # 官方 Logo → assets/
- $W image "标题" stepper="A simple side-view bicycle" # 贴纸,一次 ≤4 张
- $W stills "计划" # 每 beat 静帧,逐张查排版
- $W cover "计划" # 封面-4x3 / 封面-3x4 / 封面-9x16
- $W build "计划" # 出片 → build/<期>/outputs/final.mp4
- ```
- **参数速查:**
- | 维度 | 在哪儿改 | 默认 |
- | --- | --- | --- |
- | 语速 | `config.json` → `tts.speed` | 1.2 倍 |
- | 配音引擎 / 音色 | `tts.engine`(`volc` / `edge`)、`tts.voice`、`.env` | 见 config |
- | 配乐音量与闪避 | `bgm.gain` / `bgm.speak` / `bgm.gap` | 0.5 / 0.1 / 0.22 |
- | 笔速与每字秒数 | `render.pen.speed` / `pen.charSeconds` | 1000 px/s / 0.06~0.2s |
- | 出帧并行度 | `render.workers` | 4 路 |
- | 字幕字号 / 基线 | `captions.fontSize` / `baselineY` | 46 / 1022 |
- | 品牌层 | `brand.name` / `accent` / `slogan` / `logo` | 见 config |
- | 封面画幅与系列标签 | `cover.ratios` / `cover.seriesTag` | 4:3 / 3:4 / 9:16 |
- | 每期内容目录 | `dirs.projects` / `dirs.build`(可指到 Obsidian 仓库) | `./episodes` / `./build` |
- **目录要点:** `bin/wb`(CLI 一条龙)、`lib/scene-dsl.js`(场景 DSL,一行一个元素,导出 Excalidraw + 旁白稿 + 封面)、`lib/render.html` + `lib/render.js`(逐笔渲染器与并行出帧)、`lib/tts-volc.mjs` + `lib/tts-edge.py`(双配音通道,均带内容指纹缓存)、`lib/captions.cjs`(逐字时间戳切句、烧录并导出 SRT)、`lib/gen-image.mjs`(codex 生图 + Canvas 抠图)、`lib/fetch-logo.mjs`(Commons 官方 Logo)、`lib/mix-bgm.mjs`(手写 DSP 闪避配乐)、`references/`(dsl / scene-patterns / stickers / publish / fact-check / compliance / delivery-qa 七份)、`examples/`(一期完整示例)
- **适用场景:** 概念与机制讲解、公司/产品/财报拆解、热点背后的原理科普、需要不露脸且能批量出片的账号内容;与 `hyperframes-10s-video`(声明式分镜动画)、`remotion-video-factory`(代码级精确图形动画)、`voice-to-video`(口播逐词成片)互补,覆盖四种不同的视频生产方式
- **🎬 示例成片:** 一期完整的白板讲解片(1920×1080 / 30fps,AI 配音 + 烧录字幕 + 手绘品牌层),由本技能「选题 → 查证 → 写旁白 → 画场景 → 配音对字幕 → 逐笔渲染 → 混配乐」全流程产出,点击下方播放器直接在线观看
- <p align="center">
- <video src="https://github.com/user-attachments/assets/88c6c222-7661-4a9b-ae5e-6c555de8c69e" controls muted playsinline width="100%"></video>
- </p>
- 另有仓库内可直接播放的 [白色背景前 40 秒样片](whiteboard-video-factory/assets/sample-preview.mp4),以及 [字幕跟读高亮字幕带特写](whiteboard-video-factory/assets/sample-highlight.gif)(色块随语音跳到当前念到的字);完整示例工程在 `whiteboard-video-factory/examples/`
- ### 🎞️ HyperFrames Kinetic Video(声明式分镜动画视频)
- **核心功能:**
- - ✅ **声明式分镜**:`scenes.json` 描述「结构 + 每幕动作」,GSAP 按时间轴执行;内置 9 种场景类型(`title` / `end` / `bigword` / `quote` / `flow` / `points` / `bars` / `typewriter` / `free`)
- - ✅ **时长全参数化**:默认 10 秒,`--total=20` 或顶层 `"duration": 15` 可产任意时长——各幕 `dur` 按比例归一、末幕吸收舍入漂移,总和**精确等于目标**(0.01s 级);长片靠「加幕」而非拉长单幕,避免画面长久静止
- - ✅ **10 套配色皮肤**:`tech` / `wuding` / `aurora` / `sunset` / `ocean` / `forest` / `midnight` / `gold` / `candy` / `paper`(含浅底深字),同一分镜换肤即换风格;附可视化挑色画廊,预览页控制条下拉框可实时切换
- - ✅ **音频可选、不写死**:默认无声(无音轨);要求「带语音」即写 `script.json` → edge-tts 生成整轨配音 → `--keep-dur` 让配音贴合每幕时长 → 混音为 `<slug>-...-a.mp4`
- - ✅ **字幕自动生成(不手写)**:`make_srt.mjs` 按分镜或语音时间轴切分,时间轴与画面同源(`--eff` / `--timing`),长片也不会错位;某幕可用 `"srt"` 字段精确覆盖
- - ✅ **逐帧确定性渲染**:渲染走 `window.__KINETIC__.seek(t)`(GSAP timeline pause + seek),与机器快慢无关——不掉帧、同输入同输出
- - ✅ **画幅与帧率可切**:`--orient=portrait` 出竖屏 1080×1920,`--fps=60` 改帧数不改时长
- - ✅ **先抽帧后全量**:全量渲染前必看 `_preview` 静帧或跑 `check_overflow.mjs`,程序化拦截文字溢出与页面报错
- **工作流程:**
- 内容拆幕 → 写 `scenes.json`(定皮肤、定目标时长)→ `build_html.mjs` 生成自包含动画页(顺带产出 `*.effective.json` 生效分镜)→ 抽帧核验 → 全量逐帧渲染 → `encode.mjs` 编码 H.264 →(可选)TTS 生成配音并混音 → `make_srt.mjs` 出字幕 → ffmpeg 复核 Duration / 码流 → 交付
- **关键命令:**
- ```bash
- SK="~/.workbuddy/skills/hyperframes-10s-video"
- # 构建:20 秒 + candy 配色(同时产出 out.effective.json)
- node "$SK/scripts/build_html.mjs" scenes.json out.html --total=20 --skin=candy
- # 抽帧核验 → 全量渲染 → 编码成片
- node "$SK/scripts/render.mjs" out.html _preview --only=60,240,500
- node "$SK/scripts/render.mjs" out.html _frames
- node "$SK/scripts/encode.mjs" _frames out-1920x1080-30fps.mp4
- # 自动字幕(务必用 build 产出的生效分镜,保证与画面同源)
- node "$SK/scripts/make_srt.mjs" scenes.json out-1920x1080-30fps.srt --eff=out.effective.json
- # 带 AI 配音:先写 script.json(每幕一句口播),再 TTS + 混音
- python "$SK/scripts/tts_scenes.py" script.json scenes.json . --keep-dur --rate=+15%
- ffmpeg -y -i out-1920x1080-30fps.mp4 -i voice.mp3 -c:v copy -c:a aac -b:a 192k -shortest out-1920x1080-30fps-a.mp4
- ```
- **参数速查:**
- | 维度 | 怎么给 | 默认 |
- | --- | --- | --- |
- | 时长 | `--total=20` 或 `scenes.json` 顶层 `"duration": 15` | 10 秒 |
- | 配色 | `--skin=candy` 或 `"skin":"candy"`(10 选 1,未知值回退 `tech`) | `tech` |
- | 音频 | 说「带语音」或 `"audio":true` | 无声 |
- | 画幅 / 帧率 | `--orient=portrait` / `--fps=60` | 横屏 1920×1080 / 30fps |
- | 角标 / 页脚 | `--badge=` / `--foot=` | `海老豹666` / 空 |
- **目录要点:** `assets/template.html`(动画模板 + 10 套皮肤 + 控制条)、`scripts/`(7 个可独立运行的脚本)、`references/scenes_schema.md`(分镜字段完整定义)、`references/prompt-template.md`(对话用标准提示词模板)、`references/skin-gallery.html`(10 套配色实拍帧画廊)、`references/example-rsi/`(完整可复现范例:分镜 + 字幕)
- **适用场景:** 概念/观点的动画讲解短视频、公众号与视频号配套动画、产品与数据要点可视化、需要批量换配色出多版本的投放素材;与 `remotion-video-factory`(代码级精确图形动画)、`voice-to-video`(口播逐词成片)互补,覆盖三种不同的视频生产方式
- **🎬 演示视频(示例成片):** AI 自我进化(RSI)主题动画讲解片(1920×1080 / 30fps,含 AI 配音),即由本技能「一句话 → 分镜 → 渲染 → 混音」全流程产出,点击下方播放器直接在线观看
- <p align="center">
- <video src="https://github.com/user-attachments/assets/398430c5-7277-4382-8d2d-feff8727ff9f" controls muted playsinline width="100%"></video>
- </p>
- ### 📐 Hailaobao GZH Design(公众号排版 —— Markdown 一键变可粘贴 HTML)
- **核心功能:**
- - ✅ **Markdown → 公众号可粘贴 HTML**:产物是自包含 HTML 页面,顶栏一个 **[ 复制到公众号 ]** 按钮,点一下把带内联样式的正文写进剪贴板(`text/html`),粘进公众号后台样式全保留 —— 不经过任何第三方排版网站,不丢格式
- - ✅ **7 套排版风格**:`jade-business`(玉石商务)/ `warm-editorial`(暖色编辑部)/ `mono-tech`(极客单色)/ `champagne-brand`(香槟品牌)/ `mist-notebook`(雾霾笔记)/ `midnight-report`(午夜研究报告)/ `forest-demo`(森绿演示);每套是「主题色 + 版式 + 强调样式 + 组件皮肤」的整套预设,传未知 id 会直接报错并列出可用值
- - ✅ **AI 按规则改写,不生成新事实**:标题加「序号 | 主标题 | 小字副标题」竖线语法;kicker 语义匹配(顺序动作用 `STEP`、并列要点用纯数字 `01/02`、案例 `CASE`、章节 `PART A`、问答 `Q1`、误区 `AVOID`、数据 `FACT`…不一律甩 `STEP`);关键短语加粗、金句转引用、`---` 控制视觉呼吸、按需插 `<SummaryCard>` / `<InfoCard>` 卡片
- - ✅ **原文零损伤**:改写结果写到临时文件,原始 Markdown 一个字不动;总改动 ≤ 30%,代码块一字不改,不加原文没有的观点与事实
- - ✅ **先问风格再动手**:风格是编辑决策,默认必须让用户挑 —— 给出「首选(附理由)+ 同类型备选 + 反差款」三选一;用户点名了 scheme 或说了「你决定 / auto」才自动选
- - ✅ **零依赖、跨 agent**:只需 Node.js ≥ 16(ESM),脚本仅用内置 `fs` / `path`,无 npm 包、无需联网;Claude Code 读 `SKILL.md` 的 YAML frontmatter 自动挂载,Codex / WorkBuddy / Cursor / Cline / 手动 Prompt 走同目录 `AGENTS.md` 对等入口,产物完全一致
- **工作流程:**
- 读文章并判定体裁(方法论 / 教程 / 评测 / 心得 / 资讯)→ 问用户挑 scheme → AI 按改写规则产出临时 Markdown → `typeset.mjs` 渲染带复制按钮的 HTML → 交付(说清用了哪套风格、改了哪 3–5 处、产物绝对路径)
- **关键命令:**
- ```bash
- node ~/.workbuddy/skills/hailaobao-gzh-design/scripts/typeset.mjs \
- --input article.rewritten.md \
- --scheme forest-demo \
- --title "文章标题" \
- --out article.html
- ```
- **参数速查:**
- | 参数 | 说明 | 默认 |
- | --- | --- | --- |
- | `--input` | 改写后的 Markdown 路径 | 必填 |
- | `--scheme` | 7 选 1 的风格 id(未知值 exit 1 并列出可用 id) | `jade-business` |
- | `--title` | HTML 顶栏显示的文章名 | `公众号排版` |
- | `--out` | 产物 HTML 路径 | 与 `--input` 同目录同名 `.html` |
- **体裁 → 风格匹配(速查):** 方法论 / AI 观点 → `jade-business`;教程 / 命令行 / bug 复盘 → `mono-tech`;工具教程 / 案例演示 → `forest-demo`;心得 / 复盘 / 阅读 → `warm-editorial`;品牌 / 活动 / 产品发布 → `champagne-brand`;学习笔记 / 干货清单 → `mist-notebook`;行业分析 / 数据 / 财经 → `midnight-report`;拿不准默认 `jade-business` 兜底
- **目录要点:** `SKILL.md` + `AGENTS.md`(双入口)、`references/style-schemes.md`(7 套 scheme 目录 + 匹配决策表)、`references/formatting-rules.md`(改写方法论 + before/after)、`references/typesetting-syntax.md`(扩展 Markdown 语法)、`references/demo-article-patterns.md`(工具教程/演示型文章排版模式)、`scripts/schemes.mjs`(风格样式生成)+ `scripts/typeset.mjs`(主渲染脚本)、`examples/`(demo 与 remotion-demo 两组样例输入输出)
- **适用场景:** 公众号长文/技术文/复盘文一键排版;同一篇稿换多套风格出 A/B 版本;从 Markdown 工作流(Obsidian 等)直通公众号后台;与 `xiaohuihui-tech-article`(写稿 + 配图 + COS 图床)、`wechat-compliance-reviewer`(发布前合规审查)串成「写稿 → 排版 → 合规 → 发布」链路 —— 本 skill 只负责其中「排版」一环,不改文字内容
- **使用示例:**
- ```
- 帮我排版这篇文章,用森绿演示风格:E:\notes\remotion-article.md
- 把这篇 md 排成公众号能直接粘贴的样式,风格你决定
- ```
- ### 🏮 Poetry Cinema Page(沉浸式古诗词网页生成)
- **核心功能:**
- - ✅ **文学分镜**:按空间/时间/人物/动作/修辞/情绪转折拆 5–8 个视觉段落,不是机械地每两句配一张图
- - ✅ **统一视觉圣经 + 参考链**:主视觉文生图定调,后续每张图都以它作图生图参考,人物、地理、服饰、色彩与镜头语言整套锁死
- - ✅ **双服务商四档位**:火山引擎方舟 Doubao Seedream 5.0(`pro`/`lite`)与 GPT-Image 网关(`gpt-2`/`gpt-2.5`),可按段落混用,参考链跨服务商不断
- - ✅ **沉浸式滚动页面**:固定图片舞台、双层交叉淡入、克制视差、章节导航;桌面卡片不超半屏,移动端 contain 主图 + 模糊背景
- - ✅ **内置朗诵配音**:edge-tts(免费本地)与豆包 seed-tts-2.0 双引擎、23 个中文音色,输出音轨 + 逐行时间轴 + SRT
- - ✅ **口播视频(可选)**:Remotion 渲染 1920×1080/30fps,每段一镜的克制运镜、硬切双层级字幕、片头尾字卡、胶片颗粒与暗角,确定性渲染
- - ✅ **完整工程验收**:生产构建 + 真实浏览器 QA(桌面/移动端/音频/控制台/prefers-reduced-motion),生成图必须过联系表才允许进页面
- **工作流程:**
- 核对原文与分镜 → 建立视觉圣经 → 文生图出主视觉 → 逐段图生图(带 `ref`)→ 联系表检查 → 生成朗诵音轨 → 实现滚动页面 → 生产构建与浏览器 QA →(可选)video-plan → Remotion 成片
- **关键命令:**
- ```bash
- python scripts/ark_image.py probe # 免费验证密钥与地址
- python scripts/ark_image.py batch --plan plan.json # 整首诗一次跑完,重跑跳过已完成
- python scripts/narration.py audition # 23 个音色试听后再定音色
- python scripts/video.py run --plan video-plan.json --workspace out/video
- ```
- **适用场景:** 古典诗词电影感网页、面向学生的教学解读页、已有诗词站扩页与互链、把已生成语料再做成朗诵/讲解视频、复用「主视觉 → 参考链」一致性方法论
- **示例作品(讲解版口播视频):** 李白《将进酒》讲解版成片(1920×1080 / 30fps),点击下方播放器直接在线观看
- <p align="center">
- <video src="https://github.com/user-attachments/assets/598b5cd5-ffe9-47be-b858-0182c92a204a" controls muted playsinline width="100%"></video>
- </p>
- <p align="center">
- <a href="https://github.com/wwwzhouhui/skills_collection/releases/download/poetry-cinema-demo/jiang-jin-jiu-with-meaning.mp4"><img alt="下载 1080p 高清版(MP4)" src="https://img.shields.io/badge/%E2%AC%87%20%E4%B8%8B%E8%BD%BD%201080p%20%E9%AB%98%E6%B8%85%E7%89%88-MP4-181717?style=for-the-badge&logo=github&logoColor=white"></a>
- </p>
- ### 🎬 Remotion Video Factory(视觉优先的程序化视频工厂)
- **核心功能:**
- - ✅ **精确图形动画**:注意力矩阵、拓扑连线、数据图表、数字滚动、流程图解全部由 Remotion + React 代码绘制,文字零乱码、结构可参数化
- - ✅ **AI 配音自动对齐**:edge-tts 分段生成 + ffprobe 实测时长,build-timeline.mjs 按实测重建时间线(场景 = max(视觉最短, 配音+40f)),旁白永不被画面切走
- - ✅ **三层音频**:配音 + BGM(淡入出,可开关)+ SFX 钉帧表(相对帧表达式,时间线平移自动跟随)
- - ✅ **确定性渲染与双版本交付**:同样输入永远渲出同样的帧;带 BGM / 无 BGM 双版本 + 逐句 SRT 字幕
- **工作流程:**
- 简报与分镜 → 拷贝模板工程 → tts.py 生成配音并测长 → build-timeline.mjs 重建时间线 → 逐镜头实现场景组件(8 种动画模式词汇表)→ 声音设计 → 双版本渲染交付
- **适用场景:** 技术讲解/科普动画视频;把概念、数据、架构、算法做成动画演示(矩阵、连线、图表、公式、流程为主角的内容)
- **🎬 演示视频(示例成片):**
- <p align="center">
- <video src="https://github.com/user-attachments/assets/a9d6086a-b423-47f1-af17-d698485dc942" controls muted playsinline width="100%"></video>
- </p>
- > **▶️ 下载原片**:[备用直链](https://obsidian.duckcloud.fun/files/final-a96bf69c66dc90f4c03e5bf691d232ecb27d92d0.mp4)
- ### 📝 Photo Homework A4(拍照作业 → A4 打印清单)
- **核心功能:**
- - ✅ **手写作业识别**:读取用户上传的作业照片,逐条提取作业内容并按科目分组
- - ✅ **作业分类打标**:自动识别背诵类、书面类、阅读类和材料类作业,并使用对应颜色标签
- - ✅ **A4 单页清单**:基于内置模板生成固定版面的 HTML 文件,包含科目卡片、统计条、温馨提示和签名区
- - ✅ **打印友好**:严格遵循 A4 纵向单页约束,支持打印后手写勾选和学生/家长签名
- - ✅ **内容统计**:自动统计科目数、作业总数以及背诵类、书面类、材料类作业数量
- - ✅ **可选交互版**:用户未限定只要打印版时,可额外生成支持点击打卡和进度条的屏幕交互版
- **工作流程:**
- 1. 读取作业照片,识别手写内容和日期
- 2. 按语文、数学、英语等科目整理作业条目
- 3. 根据作业语义添加背诵、书面、阅读或材料标签
- 4. 复制 `assets/homework-a4-template.html` 并填充识别结果
- 5. 调整科目卡片、颜色和统计数据,检查总高度不超过一页
- 6. 输出 `作业清单-A4打印版.html`,并附上可核对的作业内容表格
- **版面特点:**
- - 使用双列科目卡片布局,科目数量较多或条目较长时自动收窄间距和字号
- - 内置蓝、绿、紫、橙、红、青六套主题色,科目重复时循环使用
- - 内置物理、数学、化学、英语、历史、语文、生物、地理、政治等科目图标
- - 保留卡片内分页保护,避免打印时单张科目卡片被拆分
- **使用示例:**
- ```
- 请识别这张作业照片,按科目整理成一页 A4 可打印的作业清单。
- ```
- **输出与打印:**
- - 输出 HTML 文件,使用浏览器打开后按 `Ctrl + P` 打印
- - 打印设置选择 A4、纵向,边距选择“无”或“默认”,确保完整打印在一页纸上
- - 对识别不确定的手写条目,在交付时单独提醒用户核对
- **效果图:**
- 
- ---
- ### 🎬 自动化视频剪辑与解说(video-agent-kit)
- **核心功能:**
- - ✅ **通用视频剪辑**:素材发现 → 抽帧理解 → 时间线编辑 → 预览渲染 → QC 质检
- - ✅ **电影解说**:全片抽帧 + 对白转写 → 解说词编排 → 字幕烧录 → 配音成片
- - ✅ **体育/电竞集锦**:足球、篮球、LOL 比赛自动高光编排 + 中文解说配音
- - ✅ **口播配音成片**:脚本/文档 → Edge TTS 逐段配音 → 图文画面 → ffmpeg 合成
- - ✅ **TTS 免费开箱即用**:默认 Edge TTS(晓晓/云希/云健等中文音色),无需 API Key
- - ✅ **37 个 MCP 工具**:`inspect_media`、`video_ingest`、`video_watch_segment`、`subtitle_build/render`、`validate_timeline`、`render_preview`、`qc_preview`、`synthesize_narration`、`bind_narration`、`render_narrated`、`soccer_*`、`lol_*` 等
- **5 个子技能:**
- | 子 skill | 作用 | 典型输入 | 输出 |
- |---------|------|----------|------|
- | `video-edit-agent` | 总控制器:任务分类与路由 | 任意剪辑需求 | 任务方案与执行路由 |
- | `video-edit-assembly` | 多素材组装/混剪/去重/蒙太奇 | 素材文件夹 | 组装后的时间线/成片 |
- | `video-recap-workflows` | 电影解说 + 足球/篮球/电竞集锦 | 电影/比赛视频 | 中文解说成片 final.mp4 |
- | `video-speech-workflows` | 口播浓缩/字幕修复/视频流水线 | 口播视频 | 精剪/字幕/流水线方案 |
- | `env-setup` | 环境体检与依赖安装 | 新机器 | 依赖报告/自动修复 |
- **快速使用:**
- ```text
- # 文档/文章 → 中文解说视频
- 请把这篇文档转成一段 2 分钟的中文解说视频:<贴入内容>
- # 本地视频混剪
- 把 footage/ 目录下的素材剪成一条 30 秒的混剪,突出动作镜头,配上字幕
- # 电影解说
- 几分钟看完《<电影名>》:<电影文件路径>
- # 足球集锦
- 把这场球赛剪成 3 分钟集锦,带中文解说:<比赛文件路径>
- ```
- > 详细安装与配置(MCP 注册、Python 依赖、TTS 音色)见 [video-agent-kit/README.md](video-agent-kit/README.md)。
- ### 🎬 口播文字稿一键成片(voice-to-video)
- **核心功能:**
- - ✅ **无素材出片**:输入一段口播文字稿(甚至只给一个主题),即可生成完整视频,画面全部程序化生成
- - ✅ **TTS 词级时间戳**:Edge TTS 合成配音并返回每个词的精确时间,自动产出逐句/逐词时间轴与 SRT 字幕
- - ✅ **画音逐词对应**:一句口播 = 一个动画场景,底部字幕逐词卡拉OK高亮——声音念到哪,画面切到哪
- - ✅ **确定性渲染**:无头浏览器逐帧 seek 截图后合成,同样输入永远渲出同样每一帧,可 git 管理、看 diff、断点续渲
- - ✅ **13 套画面风格**:BlockFrame 积木、暗夜 HUD、编辑杂志、终端极客、手绘白板、极简瑞士、国潮水墨、玻璃拟态、黏土软胶、蓝图工程、像素游戏等,每种风格有独立版式 DNA(布局骨架/编排/动效签名,非简单换色)
- - ✅ **外挂字幕**:自动产出 `subtitles.srt` 供视频平台上传
- - ✅ **作者水印**:`--watermark laohaibao2025` 一键右下角落款(渲染时注入、不改合成页,深浅底色均清晰)
- **🎬 视频案例:公众号文章 → 深蓝舞台解说视频(端到端实拍成片)**
- <p align="center">
- <video src="https://github.com/user-attachments/assets/5618e4fb-5acb-402e-ac87-c329cd2a6d46" controls muted playsinline width="100%"></video>
- </p>
- > **▶️ 下载 1080p 原片**:[仓库文件](https://github.com/wwwzhouhui/skills_collection/blob/main/README.assets/voice-to-video-demo-kimi.mp4) · [备用直链](https://obsidian.duckcloud.fun/files/final-fcdaf7c2dda61ee8a0d04ce89f896a8d27e28262.mp4)
- >
- > 上方案例由本技能端到端生成:输入公众号文章《Kimi 快跟上 Fable 5 了?》(约 2500 字)→ 浓缩为 600 字口播稿 → Edge TTS 配音(词级时间戳)→ 深蓝舞台风格 8 场景合成 → 无头浏览器确定性渲染成片。**成片 1 分 54 秒 · 1080p30 · 约 6MB**。
- >
- > 案例看点:画面元素逐词跟随配音出场——念到「2.5 万亿」参数卡弹入、念到「蒸馏了」渐变大字砸出、念到「封神 / 贴脸」红绿对比卡先后出现、念到「≈1%」价格大数字弹出;底部字幕逐词卡拉OK高亮,声音念到哪,高亮到哪;右下角 `laohaibao2025` 为作者水印落款。
- **目录结构:**
- ```
- voice-to-video/
- ├── SKILL.md # 技能入口:六步工作流(自检→定稿→TTS→合成→预览→渲染)
- ├── scripts/
- │ ├── tts.py # 口播稿 → voice.mp3 + timeline.json + subtitles.srt/js
- │ └── render.py # 合成页 → 逐帧截图 → ffmpeg 合成 MP4(支持断点续渲)
- ├── assets/
- │ ├── engine.js # 确定性动画引擎(HF.seek,一切画面状态是时间的纯函数)
- │ ├── kit.css + kits/(12 套) # 画面风格皮肤
- │ └── template.html # 合成页模板
- └── references/
- ├── composition-guide.md # 合成页编写规范
- └── styles.md # 风格目录 + 版式 DNA + 自动匹配规则
- ```
- **工作流程:**
- 1. 整理口播稿(纯文本,按句读分段;只给主题则先写稿确认)
- 2. `tts.py` 生成配音与逐句/逐词时间轴
- 3. 按所选风格的版式 DNA 编写 `composition.html`(时间戳驱动场景与元素出场)
- 4. 本地预览(空格播放,检查字幕高亮与场景切换)
- 5. `render.py` 逐帧渲染合成 MP4(渲染耗时约为片长 2 倍,支持 `--style-kit` 一键换风格重渲)
- **使用示例:**
- ```text
- 把这段稿子做成视频:(粘贴口播稿)
- 用国潮水墨风做一条介绍 XX 的口播视频
- 这条视频换个终端极客风重渲一版
- ```
- **与 video-agent-kit 的分工:**
- - `voice-to-video`:**无素材 → 有视频**,画面由引擎生成,适合知识口播、工具介绍、教程解说
- - `video-agent-kit`:**有素材 → 剪成片**,画面来自源文件,适合电影解说、球赛/电竞集锦、混剪
- - 两者可接力:先无素材出片,再做浓缩剪辑或字幕精修
- > 详细文档(管线原理、timeline.json 格式、脚本参数、常见问题)见 [voice-to-video/README.md](voice-to-video/README.md)。
- ### 🎨 AI 教学媒体一体化(ai-teaching-media)
- **核心功能:**
- - ✅ **6 子 skill 一体化**:一个目录覆盖生图执行层、技术长文插图、学科信息图、教学动图/视频、短视频封面、文章解说视频
- - ✅ **意图自动路由**:根据用户目标自动进入对应子 skill,并按流水线串联整套教学资产
- - ✅ **知识点全套生产**:信息图 → 教学动图/配音视频 → 3:4 短视频封面
- - ✅ **技术长文全套生产**:16:9 智能插图 → 章节解说视频 → 可选封面
- - ✅ **多通道生图执行层**:统一调用 MuleRun / APImart / AtlasCloud / Agnes 等供应商
- - ✅ **配音与成片**:支持 Minimax TTS / Edge TTS,结合 HyperFrames + ffmpeg 渲染 1080p 视频
- **6 个子 skill:**
- | 子 skill | 作用 | 典型输入 | 输出 |
- |---------|------|----------|------|
- | `ai-image-generator` | 通用生图执行层(被其它子 skill 调用) | prompt / 参考图 | PNG |
- | `tech-article-diagram` | 技术长文智能插图(多风格) | Markdown 长文 | 16:9 插图 |
- | `edu-subject-infographic` | 学科知识点竖版信息图 | 知识点名称 | 9:16 信息图 |
- | `edu-teaching-animation` | 教学动图 + 配音教学视频 | 学科概念 | 无声 MP4 / 配音 MP4 |
- | `short-video-cover` | 短视频竖版封面 | 口播文案 | 3:4 封面图 |
- | `article-explainer-video` | 长文章节解说视频 | 技术文章 | 1080p MP4 |
- **推荐串联流水线:**
- | 流水线 | 适用场景 | 路径 |
- |--------|----------|------|
- | A 知识点全套 | 勾股定理、光合作用等单点知识 | 信息图 → 教学动图/视频 → 短视频封面 |
- | B 技术长文全套 | 技术教程 / Markdown 长文 | 文章插图 → 章节解说视频 → 可选封面 |
- | C 口播发布包 | 已有口播稿/脚本 | 3:4 封面 + 教学视频/解说视频 |
- **适用场景:**
- - 给技术文章自动补流程图、架构图、对比图
- - 把学科知识点做成竖版信息图和教学短视频
- - 为视频号/抖音/小红书生成 3:4 封面
- - 把长文拆成章节解说视频一站式产出
- **使用示例:**
- ```
- 请使用 ai-teaching-media,围绕「勾股定理」生成全套教学资产:
- 信息图 + 教学动图/配音视频 + 短视频封面
- ```
- ```
- 请用 ai-teaching-media 给这篇技术长文生成插图,并做成章节解说视频
- ```
- **效果图:**
- 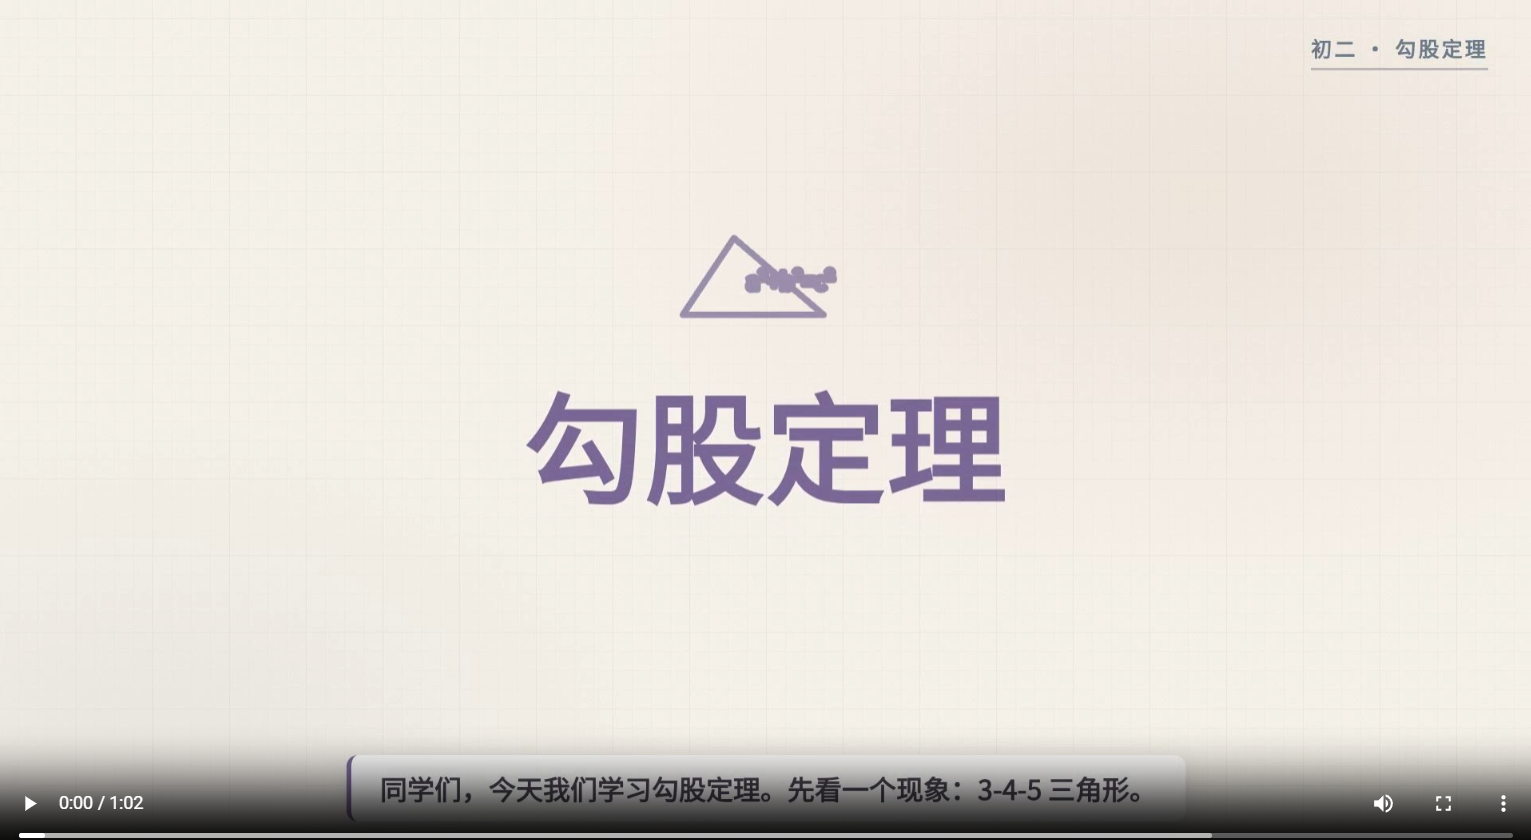
- https://cdn.jsdelivr.net/gh/hailaobao2026/ai-teaching-video-platform@main/docs/videos/math-pythagorean-theorem.mp4
- **环境要求:**
- | 变量 / 依赖 | 必需 | 说明 |
- |-------------|------|------|
- | `MULERUN_API_KEY` / `APIMART_API_KEY` / `ATLASCLOUD_API_KEY` / `AGNES_API_KEY` | 是(任选其一) | 生图供应商密钥 |
- | `MINIMAX_API_KEY` | 否 | 配音;也可用免费 `edge-tts` |
- | Node.js ≥ 22 + ffmpeg | 是(视频链路) | 渲染教学视频/解说视频 |
- **技术特点:**
- - 总入口 `SKILL.md` 负责路由,子 skill 独立约束与实现
- - 同主题内容可复用色系与术语,保证信息图/动图/视频风格一致
- - 生图统一走 `ai-image-generator`,避免多处重复对接供应商
- - 支持从单点知识点到整篇文章的完整教学生产链路
- ---
- ### 🖼️ Grok Imagine Image (grok-imagine-image)
- **核心功能:**
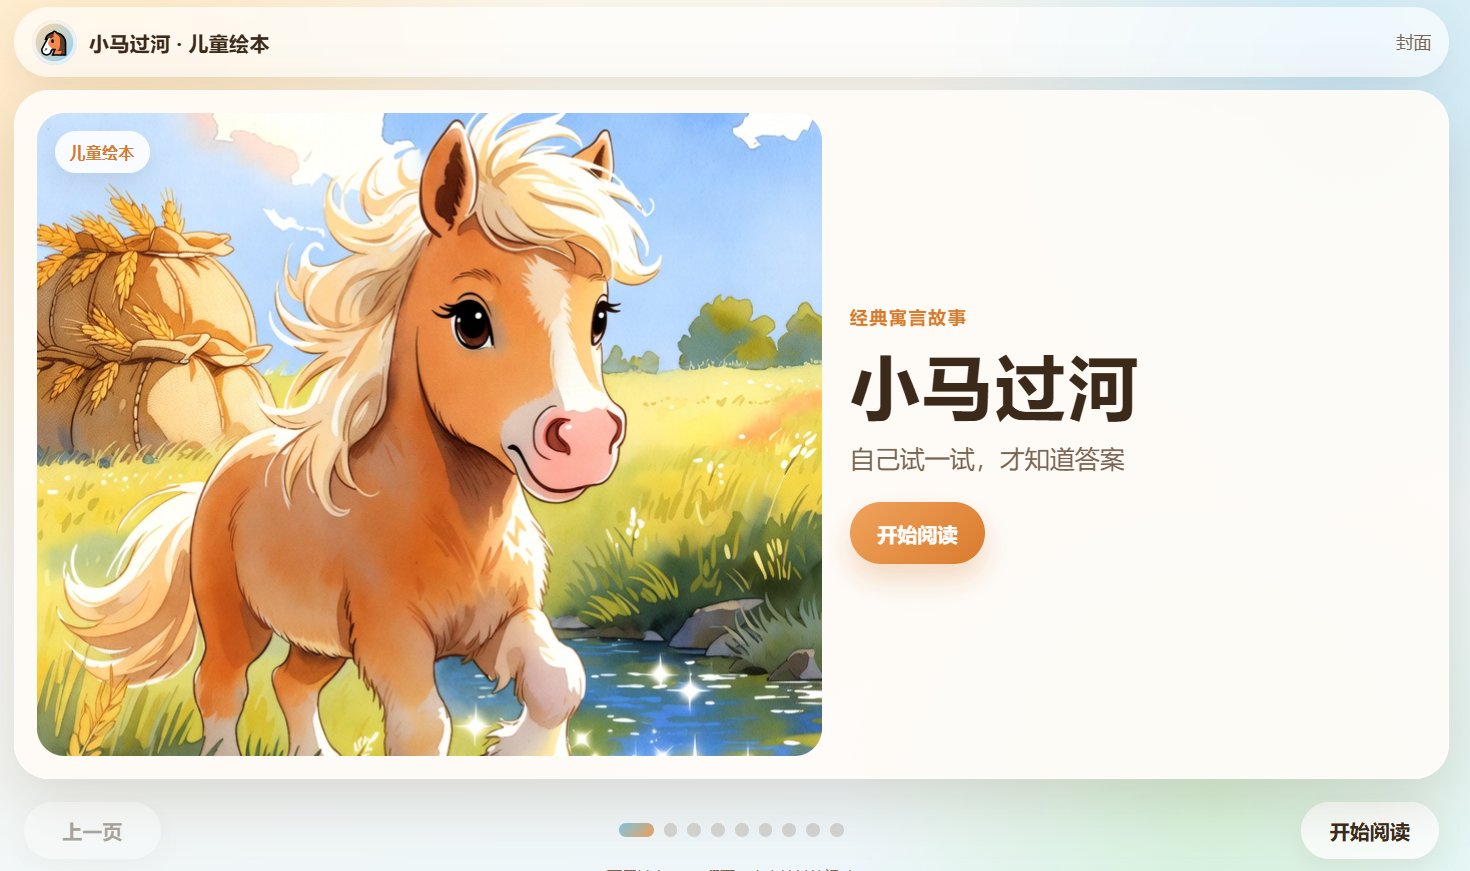
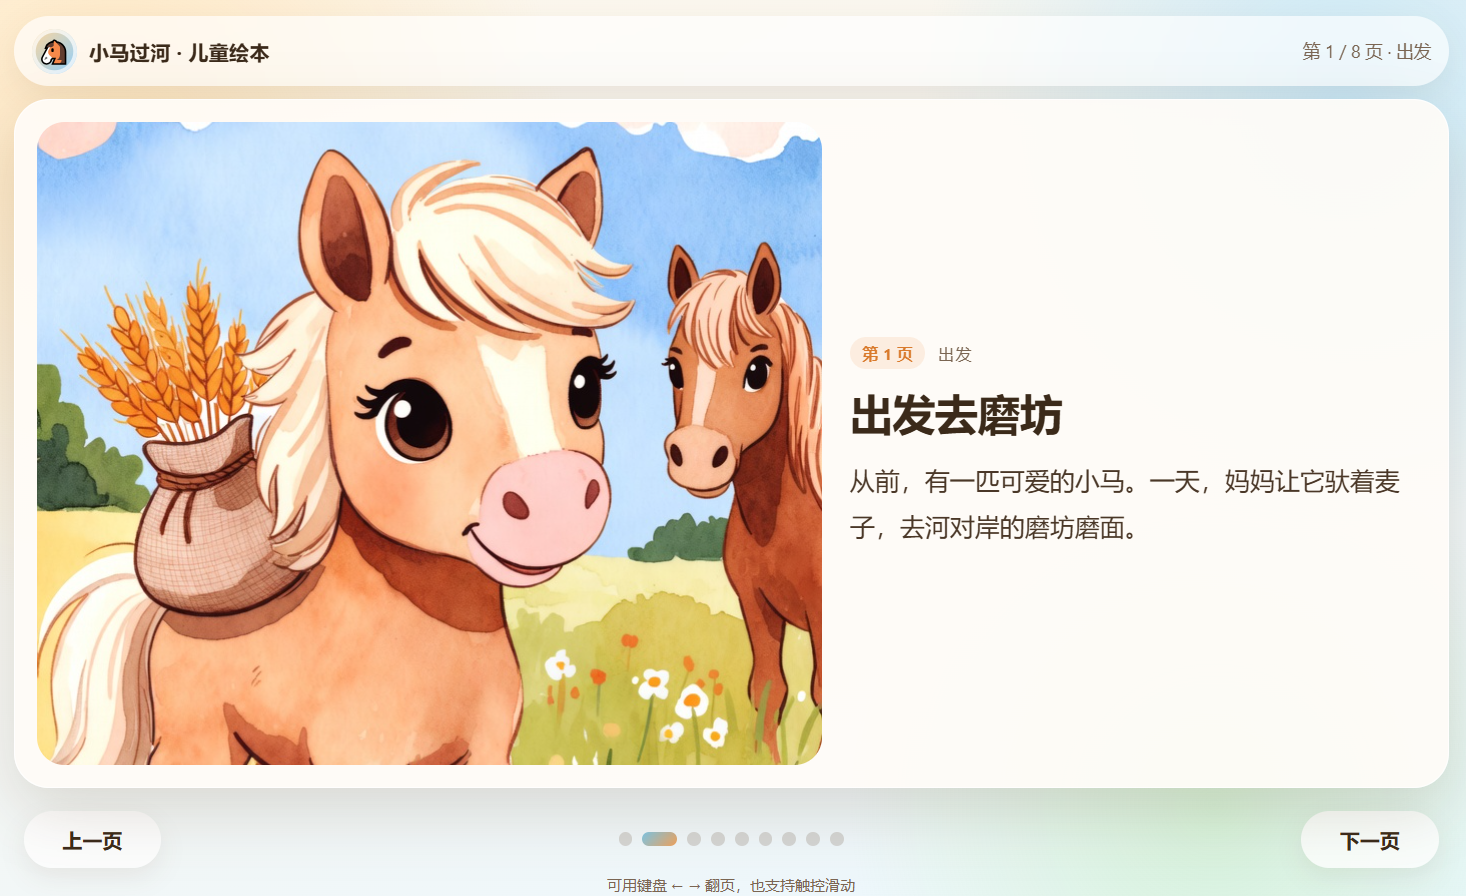
- - ✅ **Grok Imagine 文生图**:调用 `grok-imagine-image` 模型生成图片
- - ✅ **OpenAI 风格接口**:仅使用 `POST /v1/images/generations`,兼容 Grok2API
- - ✅ **本地脚本开箱即用**:`scripts/generate.py` 支持 prompt 文件、批量数量、尺寸、超时
- - ✅ **媒体 URL 自动改写**:接口返回 `127.0.0.1` 时自动替换为配置的公网主机并下载
- - ✅ **Agent 友好输出**:支持 `--json` 机器可读结果,便于后续工作流解析
- - ✅ **配置可覆盖**:支持环境变量与命令行参数覆盖 API Base / API Key / Model
- **默认配置:**
- | 项目 | 默认值 |
- |------|--------|
- | API 地址 | `http://43.163.230.83:8000/v1` |
- | 模型 | `grok-imagine-image` |
- | 尺寸 | `1024x1024` |
- | 超时 | `180` 秒 |
- | API Key | `scripts/generate.py` 中的 `DEFAULT_API_KEY`(可替换/环境变量覆盖) |
- **适用场景:**
- - 明确要求使用 Grok Imagine / grok-imagine-image 生图
- - 其他 Skill 或本地工作流需要调用该模型
- - 需要把生成结果下载到工作区 `outputs/` 再继续处理
- **使用示例:**
- ```
- 请使用 grok-imagine-image 生成一张图片:
- a cozy reading nook with soft daylight
- 保存到 ./outputs
- ```
- **命令行使用:**
- ```bash
- python scripts/generate.py --prompt "a cozy reading nook with soft daylight" --output-dir ./outputs --name-tag reading-nook --json
- ```
- ```bash
- python scripts/generate.py --prompt-file ./prompt.txt --output-dir ./outputs --size 1024x1024 --n 1 --timeout 180
- ```
- **效果图:**
- 
- 
- **环境要求:**
- | 变量 | 必需 | 说明 |
- |------|------|------|
- | `GROK_IMAGINE_API_KEY` | 建议 | API 密钥;也可通过 `--api-key` 或脚本默认值配置 |
- | `GROK_IMAGINE_API_BASE` | 否 | API 地址,默认见上表 |
- | `GROK_IMAGINE_MODEL` | 否 | 模型名,默认 `grok-imagine-image` |
- **技术特点:**
- - 严格走 Images API,不误用 Chat Completions
- - 生图成功后优先回报本地路径与可访问公网 URL
- - 支持 `--no-download` 仅返回 URL,适合调试网关
- - 适合作为独立生图技能,或被其他内容生产链路复用
- ---
- ### 📚 Knowledge Absorber (知识吸收器)
- **核心功能:**
- - ✅ **深度解析链接/文档/代码**:支持 URL 链接、本地文件(PDF/Word/Markdown/代码/图片)
- - ✅ **导师级教学笔记**:生成结构化知识卡片,包含核心概念、FAQ、认知地图(Mermaid)
- - ✅ **真理锚定验证**:自动联网验证事实性内容(数据、API 签名、版本号、历史事件),标注不确定内容
- - ✅ **Wan 2.7 知识海报**:可选生成信息图海报,11 种视觉风格自动判断
- - ✅ **国学风格自动触发**:检测国学关键词自动使用水墨风格(风格 11)
- - ✅ **交互式 HTML 输出**:生成可交互的知识卡片 HTML,支持折叠/展开、搜索、导航
- **11 种海报风格:**
- | # | 风格 | 核心特征 | 适用场景 |
- |---|------|----------|----------|
- | 1 | 🧪 坐标蓝图 | 坐标系统 + 技术网格 | 技术参数、专业评测 |
- | 2 | 📐 复古波普 | 瑞士网格 + 粗黑线 | 干货清单、对比表格 |
- | 3 | 📁 文件夹 | 3D 文具 + 剪贴板 | 系统指南、分类清单 |
- | 4 | 🧾 热敏纸 | 票据穿孔 + 3D 图标 | 步骤清单、时间线 |
- | 5 | 📓 复古手帐 | 拼贴证据板 + 图钉 | 案例研究、调查分析 |
- | 6 | ✏️ 陶土手绘 | 涂鸦粗轮廓 + 几何形 | 轻松干货、亲和科普 |
- | 7 | 💾 酸性复古 | Y2K 像素 + 镭射渐变 | 数码评测、极客内容 |
- | 8 | 🎫 剧场票据 | 票根胶片 + 五幕剧 | 故事演进、系列指南 |
- | 9 | 🖼️ 矢量插图 | 黑轮廓线稿 + 几何简化 | PPT 封面、场景插画 |
- | 10 | 🎨 孟菲斯网格 | 可见网格 + 模块色块 | 高密度信息、艺术指南 |
- | 11 | ☯️ 水墨国学 | 水墨背景 + 传统字体 | 国学经典、人文哲学 |
- **适用场景:**
- - 学习新技术/框架,生成可搜索的知识卡片
- - 分析开源项目代码,提取核心架构和设计模式
- - 整理文档/教程,形成结构化学习笔记
- - 国学经典解读,自动生成水墨风格海报
- - 技术趋势分析,生成信息图海报分享
- **工作流程(3 步引导法):**
- ```
- 步骤 1: 启动询问 → 收集用户偏好(目标读者、海报需求、分辨率)
- 步骤 2: 知识摄取与验证 → 摄取内容 → 真理锚定 → 生成知识卡片 → (可选)海报 Prompt
- 步骤 3: 确认后生图 → 用户确认后调用 Wan 2.7 → 返回图片 URL
- ```
- **真理锚定验证规则:**
- | 必须验证 | 不需要验证 |
- |---------|-----------|
- | 具体数据(如 "Python 3.12 于 2023 年发布") | 观点、建议、方法论 |
- | API 签名(如 `fetch(url, options)`) | 个人经验、主观判断 |
- | 版本号(如 "React 19 支持新特性") | 设计模式、最佳实践 |
- | 历史事件(如 "1991 年 Linux 发布") | 推理过程、逻辑分析 |
- **标注规范:**
- | 类型 | 标注 | 示例 |
- |------|------|------|
- | 过时信息 | `[已过时]` | "Python 2 是主流 [已过时]" |
- | 有争议 | `[存在争议]` | "最佳框架是 X [存在争议]" |
- | 无法确认 | `[待确认]` | "该 API 返回 Promise [待确认]" |
- **国学触发关键词:**
- | 类别 | 关键词示例 |
- |------|----------|
- | 经典文献 | 论语、庄子、道德经、史记、诗经、易经、孟子、荀子、春秋、左传 |
- | 学派思想 | 国学、古文、儒、道、佛、哲学、人文、儒家、道家、禅宗 |
- | 历史人物 | 孔子、老子、孟子、庄子、荀子、墨子、韩非子、朱熹、王阳明 |
- | 文学体裁 | 古诗、词、赋、骈文、散文、文言文 |
- | 其他 | 经史子集、四书五经、诸子百家、传统文化 |
- **效果图:**
- 
- 
- 
- **输出目录结构:**
- ```
- outputs/knowledge_YYYYMMDD_HHMMSS/
- ├── knowledge_card.md # 知识卡片 Markdown
- ├── knowledge_card.interactive.html # 交互式 HTML
- ├── wan_prompt.txt # 海报 Prompt(可选)
- └── wan_result.json # 生图结果(可选)
- ```
- **环境要求:**
- | 变量 | 必需 | 说明 |
- |------|------|------|
- | `DASHSCOPE_API_KEY` | 是 | DashScope API 密钥,用于翻译和 Wan 2.7 生图 |
- **技术特点:**
- - 智能内容摄取:支持动态页面渲染(DrissionPage)、静态页面解析
- - 真理锚定协议:联网验证事实性内容,标注不确定信息
- - 3 步引导式工作流:用户确认后再执行生图,避免资源浪费
- - 海报风格智能判断:根据内容类型自动选择最合适的视觉风格
- - 国学内容自动触发水墨风格:检测关键词自动切换风格 11
- ---
- ### 🎬 Seedance Video Creator (Seedance 2.0 分镜视频创作)
- **核心功能:**
- - ✅ **三阶段工作流**:分镜提示词 → 文生图首帧 → 图片+提示词生成视频
- - ✅ **自动首帧生成**:无用户图片时自动调用文生图 API(jimeng-4.5)生成首帧参考图
- - ✅ 分镜引导流程(理解想法→挖掘细节→构建分镜→生成双提示词→优化确认)
- - ✅ 6 套分镜模板(叙事/产品/角色/风景/延长/编辑)
- - ✅ 多模态支持:多图参考(最多9张)、角色一致性、运镜复刻
- - ✅ 一键调用即梦 Seedance 2.0 API 生成视频
- - ✅ 自动下载生成的视频到本地
- - ✅ 镜头语言/氛围关键词速查表
- **重要约束**:Seedance 2.0 **必须至少提供一张参考图片**,不支持纯文本生成视频。当用户没有提供图片时,工具会自动通过文生图 API 生成首帧参考图。
- **适用场景:**
- - 短视频创作(抖音/快手/视频号)
- - 产品宣传视频制作
- - 创意分镜脚本编写
- - AI 视频生成效果探索
- **前置条件:**
- 1. **jimeng-free-api-all** Docker 容器运行(端口 8000)— 必须是 `jimeng-free-api-all` 镜像,旧版 `jimeng-free-api` 不支持 Seedance
- 2. 即梦平台 SessionID(从网站 Cookies 获取)
- **使用示例:**
- ```
- 帮我生成一个女孩在海边跳舞的视频
- → 生成首帧图片提示词 + 视频分镜提示词
- → 文生图生成首帧参考图
- → 首帧图片 + 提示词 → Seedance 2.0 生成视频
- → 下载视频
- ```
- ```bash
- # 独立脚本使用(无图片 → 三阶段工作流)
- ./scripts/generate_video.sh \
- --session-id "your_sessionid" \
- --image-prompt "海边沙滩,女孩穿白裙站在海边,夕阳逆光" \
- --prompt "@1 作为首帧参考,女孩开始旋转起舞..." \
- --ratio 9:16 --duration 4
- # 有图片 → 直接生成视频
- ./scripts/generate_video.sh \
- --session-id "your_sessionid" \
- --prompt "@1 和 @2 两人跳舞" \
- --files dancer1.jpg dancer2.jpg \
- --ratio 4:3 --duration 10
- ```
- **视频参数:**
- | 参数 | 可选值 | 默认值 |
- |------|--------|--------|
- | model | seedance-2.0-fast, jimeng-video-seedance-2.0-fast, jimeng-video-seedance-2.0(Pro) | seedance-2.0-fast |
- | ratio | 1:1, 4:3, 3:4, 16:9, 9:16 | 9:16 |
- | resolution | 480p, 720p, 1080p | 720p |
- | duration | 4 - 15 秒(连续范围) | 4 |
- **技术特点:**
- - 融合 [elementsix-skills](https://github.com/elementsix/elementsix-skills) 分镜引导 + [jimeng-free-api-all](https://github.com/wwwzhouhui/jimeng-free-api-all) 视频生成
- - 三阶段工作流:文生图(`/v1/images/generations`)→ 下载首帧 → Seedance 视频生成(`/v1/videos/generations`)
- - Authorization 头需要 Bearer 前缀,格式为 `Bearer your_sessionid`
- - API 同步阻塞调用,自动轮询等待生成完成
- - **必须使用 `jimeng-free-api-all` 镜像**(旧版 `jimeng-free-api` 不含 Seedance 路由,会静默回退到 jimeng-video-3.0)
- - 提供独立 Bash 脚本,支持 CI/CD 集成
- ---
- ### 📰 WeChat Article Fetcher (微信公众号文章获取器)
- **核心功能:**
- - ✅ 获取微信公众号文章完整内容
- - ✅ 支持单篇和批量下载(空格或逗号分隔多个链接)
- - ✅ 自动提取元数据(标题、作者、公众号名称、发布时间、摘要、封面图)
- - ✅ 自动下载文章内所有图片到本地
- - ✅ HTML 转 Markdown 格式
- - ✅ 生成格式化的独立 HTML 文件
- - ✅ 导出文章元数据 JSON
- - ✅ 支持短链接和长链接两种格式
- - ✅ 批量下载间隔控制,避免触发反爬
- **适用场景:**
- - 公众号文章离线保存和归档
- - 文章内容素材提取
- - 批量采集公众号文章
- - 文章格式转换(HTML → Markdown)
- **使用方式:**
- ```bash
- # 单篇下载
- python scripts/fetch_wechat_article.py "https://mp.weixin.qq.com/s/xxxxx"
- # 批量下载(空格分隔)
- python scripts/fetch_wechat_article.py "url1" "url2" "url3" --output-dir ./output
- # 批量下载(逗号分隔)
- python scripts/fetch_wechat_article.py "url1,url2,url3" --output-dir ./output
- # 仅输出元数据 JSON
- python scripts/fetch_wechat_article.py "url" --json
- # 自定义下载间隔(默认3秒)
- python scripts/fetch_wechat_article.py "url1" "url2" --interval 5
- ```
- **输出结构:**
- ```
- output/<公众号名称>/<日期>_<标题>/
- ├── index.html # 格式化的独立HTML文件
- ├── article.md # Markdown版本
- ├── meta.json # 文章元数据
- └── images/ # 下载的图片
- ```
- **Python 库调用:**
- ```python
- from scripts.fetch_wechat_article import fetch_article, batch_fetch
- # 单篇获取
- result = fetch_article("https://mp.weixin.qq.com/s/xxxxx", output_dir="./output")
- # 批量获取
- urls = ["url1", "url2", "url3"]
- stats = batch_fetch(urls, output_dir="./output", interval=3.0)
- print(f"成功{stats['success']}篇, 失败{stats['fail']}篇")
- ```
- **技术要求:**
- - Python 3.7+
- - 依赖库:`pip install beautifulsoup4 html2text requests`
- **注意事项:**
- - 优先使用短链接(`/s/xxxxx`),长链接可能触发验证码
- - 批量下载时默认间隔3秒,可通过 `--interval` 调整
- - 自动使用微信移动端 User-Agent 绕过访问限制
- ---
- ### 📰 WeChat Article Aggregator (微信公众号文章聚合器)
- **核心功能:**
- - ✅ 通过 mptext.top API 批量获取指定公众号博主的最新文章列表
- - ✅ 自动下载文章内容并解析为 Markdown/HTML/纯文本/JSON 格式
- - ✅ 支持按公众号名称或 fakeid 获取,预置 8 个热门 AI 技术公众号
- - ✅ 智能 HTML 正文解析,提取 `#js_content` 区块内容
- - ✅ 生成结构化的 summary.json 元数据汇总文件
- - ✅ 可选依赖,自动降级:无 beautifulsoup4 时使用内置解析器
- **预置公众号:**
- | 公众号 | 分类 | fakeid |
- |--------|------|--------|
- | 饼干哥哥AGI | AI编程 | MjM5NDI4MTY3NA== |
- | 赛博禅心 | AI前沿 | MzkzNDQxOTU2MQ== |
- | 可怜的小互 | AI技术 | MzkzMTcyMTgxNg== |
- | 宝玉的工程技术分享 | 技术翻译 | Mzk1NzgxMjQ0OA== |
- | 苍何 | AI实战 | Mzg3MTk3NzYzNw== |
- | 老金开源 | Claude Code | MzI0NzU2MDgyNA== |
- | 玩转AI工具 | AI工具 | MzU4NTE1Mjg4MA== |
- | 袋鼠帝AI客栈 | AI实战 | MzkwMzE4NjU5NA== |
- **使用方式:**
- ```bash
- # 命令行方式:按 fakeid 获取
- python3 scripts/fetch_articles.py --api-key YOUR_KEY --fakeids "MzkzNDQxOTU2MQ==" --limit 2
- # 按公众号名称获取
- python3 scripts/fetch_articles.py --api-key YOUR_KEY --fakeids "赛博禅心,老金开源" --limit 3
- # 获取所有预置公众号的最新文章
- python3 scripts/fetch_articles.py --api-key YOUR_KEY --fakeids all --limit 1
- # 查看预置公众号列表
- python3 scripts/fetch_articles.py --list-accounts
- ```
- **Claude Code 中使用:**
- ```
- "请使用 wechat-article-aggregator 获取赛博禅心最新2篇公众号文章"
- "请帮我获取所有预置公众号的最新文章"
- ```
- **技术要求:**
- - Python 3.7+
- - 必需依赖:`pip install requests`
- - 可选依赖:`pip install beautifulsoup4 html2text`(增强 HTML 解析效果)
- - mptext.top API Key
- **注意事项:**
- - API Key 通过 `--api-key` 参数或 `MPTEXT_API_KEY` 环境变量配置
- - 默认每次请求间隔 2 秒,可通过 `--interval` 调整
- - 部分图片密集型或付费文章可能无法提取文本内容
- ---
- ### 📊 PPT Generator (PPT 生成器)
- **核心功能:**
- - ✅ 固定 25 页专业商务 PPT 结构(封面→目录→4章节→结束→字体说明→版权)
- - ✅ 三种主题风格:暖色调、商务简约(默认)、莫兰迪色系
- - ✅ 每章节 5 页(1 个过渡页 + 4 个内容页)
- - ✅ 支持 JSON 配置文件和代码调用两种方式
- - ✅ 专业设计风格:商务简约、暖色调装饰、莫兰迪色系
- - ✅ 规范化布局:统一页面布局和文本规范
- **PPT 结构(25 页):**
- 1. **第1页**:封面 - 主标题、副标题、年份
- 2. **第2页**:目录 - 4 个章节列表
- 3. **第3-7页**:第一章节(1 个过渡页 + 4 个内容页)
- 4. **第8-12页**:第二章节(1 个过渡页 + 4 个内容页)
- 5. **第13-17页**:第三章节(1 个过渡页 + 4 个内容页)
- 6. **第18-22页**:第四章节(1 个过渡页 + 4 个内容页)
- 7. **第23页**:结束页 - "谢谢观看"
- 8. **第24页**:字体说明
- 9. **第25页**:版权声明
- **适用场景:**
- - 年度工作总结
- - 项目汇报
- - 工作述职
- - 产品发布
- - 季度/月度报告
- **使用方式:**
- ```bash
- # 方法1:直接运行生成示例 PPT
- python3 ppt_generator.py
- # 方法2:使用 JSON 配置文件
- python3 ppt_generator.py my_ppt_config.json
- ```
- **JSON 配置示例:**
- ```json
- {
- "title": "2025年度工作总结",
- "subtitle": "工作总结 / 汇报",
- "year": "2025",
- "theme": "商务简约",
- "filename": "2025年度工作总结.pptx",
- "chapters": [
- {
- "title": "年度工作概况",
- "description": "介绍全年工作整体情况",
- "pages": [
- {
- "title": "工作概述",
- "content": [
- {"title": "项目数量", "description": "完成 15 个重点项目"},
- {"title": "团队规模", "description": "团队扩展至 20 人"}
- ]
- }
- ]
- }
- ]
- }
- ```
- **代码调用示例:**
- ```python
- from ppt_generator import PPTGenerator
- # 创建生成器实例
- generator = PPTGenerator(theme="商务简约")
- # 配置 PPT 内容
- config = {
- "title": "2025年度总结",
- "subtitle": "工作总结 / 汇报",
- "year": "2025",
- "chapters": [...] # 章节配置
- }
- # 生成并保存 PPT
- generator.generate_full_ppt(config)
- generator.save("output.pptx")
- ```
- **主题风格:**
- | 主题 | 特点 | 适用场景 |
- |------|------|----------|
- | 暖色调 | 活泼热情 | 创意类汇报 |
- | 商务简约 | 专业稳重(默认) | 工作总结 |
- | 莫兰迪色系 | 优雅柔和 | 品牌展示 |
- **技术要求:**
- - Python 3.7+
- - 依赖库:python-pptx (`pip install python-pptx`)
- - 推荐字体:阿里巴巴普惠体 2.0、HarmonyOS Sans SC、MiSans Heavy、思源宋体 CN
- **配置要点:**
- - 4 个章节必填:每个 PPT 必须有 4 个主要章节
- - 每章节 4 页内容:不足自动补充占位页
- - 每页最多 4 个要点:采用 2x2 布局
- - 文本简洁:描述控制在 50-100 字
- ---
- ### 📊 Excel Report Generator
- **核心功能:**
- - ✅ 从多种数据源生成 Excel(CSV、DataFrame、数据库)
- - ✅ 创建专业图表(柱状图、折线图、饼图等)
- - ✅ 应用样式和格式化
- - ✅ 模板填充和批量生成
- - ✅ 条件格式和数据验证
- - ✅ 公式和自动计算
- **适用场景:**
- - 数据分析报表
- - 业务报告自动化
- - 系统数据导出
- - 模板批量处理
- **示例用法:**
- ```
- 请基于上面的数据帮我生成图表统计,比如饼状图、柱状图、条形图等
- ```
- 
- ---
- ### 🎬 WanCover+ (Wan2.7 封面图和视频生成)
- **核心功能:**
- - ✅ **图片生成**:公众号封面图、小红书封面图、种草图、海报重排版
- - ✅ **视频生成**:文生视频、静态图转丝滑动态视频、参考图/参考视频转视频
- - ✅ **视频后处理**:自动 Edge TTS 配音、SRT 字幕生成、字幕烧录
- - ✅ **智能场景识别**:自动判断任务类型(从零出图 vs 改版重排)
- - ✅ **多平台适配**:支持微信横版封面、小红书竖版封面等多种规格
- - ✅ **Wan 2.6 / 2.7 兼容**:视频任务兼容两代模型协议
- **图片任务场景:**
- | 场景 | scene | 适用场景 |
- |------|-------|----------|
- | 公众号封面图 | `wechat_cover` | 横版文章头图、技术媒体头图 |
- | 小红书封面 | `xiaohongshu_cover` | 竖版信息流封面、种草图 |
- | 海报改版 | `relayout_poster` | 保留原主体/信息层级的改版设计 |
- **视频任务类型:**
- | 类型 | task_type | 默认模型 | 适用场景 |
- |------|-----------|----------|----------|
- | 文生视频 | `text_to_video` | `wan2.7-t2v` | 纯文字描述生成视频 |
- | 图转视频 | `image_to_video` | `wan2.7-i2v` | 静态图转动态视频 |
- | 参考转视频 | `reference_to_video` | `wan2.7-r2v` | 参考图/参考视频转视频 |
- **适用场景:**
- - 公众号文章封面图制作
- - 小红书笔记封面图生成
- - 产品种草图快速出图
- - 海报横版改竖版重排版
- - 产品演示短视频生成
- - 静态图片转动态视频
- - 视频自动配音和字幕
- **使用示例:**
- ```
- 请使用 wan-cover-plus 生成一个技术文章公众号封面图
- 标题:Claude Code Skills 集合
- 副标题:15+ 实用技能工具
- 风格:tech_media
- ```
- 
- **命令行使用:**
- ```bash
- # 图片任务
- python3 scripts/generate.py --input examples/demo_wechat_cover.json
- python3 scripts/generate.py --input examples/demo_xiaohongshu_cover.json
- python3 scripts/generate.py --input examples/demo_relayout_poster.json
- # 视频任务
- python3 scripts/generate.py --input examples/demo_text_to_video.json
- python3 scripts/generate.py --input examples/demo_image_to_video.json
- python3 scripts/generate.py --input examples/demo_reference_to_video.json
- ```
- **输入格式示例:**
- ```json
- // 图片任务最小输入
- {
- "title": "string",
- "scene": "wechat_cover | xiaohongshu_cover | relayout_poster",
- "style": "tech_media | warm_lifestyle | premium_brand | cute_note"
- }
- // 文生视频最小输入
- {
- "task_type": "text_to_video",
- "title": "string"
- }
- // 图转视频最小输入
- {
- "task_type": "image_to_video",
- "title": "string",
- "reference_images": ["/absolute/path/or/url"]
- }
- ```
- **配置说明:**
- ```yaml
- wan:
- api_key: "your_wan_api_key"
- base_url: "https://dashscope.aliyuncs.com/api/v1"
- image_model: "wan2.7-image"
- text_to_video_model: "wan2.7-t2v"
- image_to_video_model: "wan2.7-i2v"
- reference_to_video_model: "wan2.7-r2v"
- defaults:
- task_type: "image"
- scene: "wechat_cover"
- style: "tech_media"
- variants: 1
- output_dir: "output"
- video_duration_seconds: 5
- video_resolution: "720P"
- video_aspect_ratio: "16:9"
- postprocess:
- ffmpeg_bin: "ffmpeg"
- ffprobe_bin: "ffprobe"
- tts_voice: "zh-CN-XiaoxiaoNeural"
- tts_rate: "+0%"
- tts_volume: "+0%"
- subtitle_mode: "burned"
- ```
- **技术特点:**
- - 基于 Wan 2.7 系列模型的强大生成能力
- - 视频任务兼容 Wan 2.6 / 2.7 两代协议
- - 智能场景判断和任务路由
- - 支持本地路径和 URL 两种参考源
- - 自动生成 prompt sidecar 文件
- - Edge TTS 配音和多语言字幕支持
- - 字幕烧录到视频的完整后处理流程
- **前置条件:**
- 1. 配置 `config.yaml` 文件(复制 `config.example.yaml`)
- 2. 填写 `wan.api_key` 和 `wan.base_url`
- 3. 视频配音和字幕功能需要安装 `ffmpeg` 和 `ffprobe`
- **输出结果:**
- - 图片任务:PNG 图片 + `.prompt.txt` sidecar
- - 视频任务:MP4 视频 + `.prompt.txt` sidecar
- - 启用后处理:额外生成 `.narration.mp3`、`.srt`、`.narrated.mp4`、`.final.mp4`
- ---
- ### 🔥 GitHub Trending
- **核心功能:**
- - ✅ 抓取 GitHub Trending 今日前 5 热门项目
- - ✅ 获取 README 并生成中文摘要(项目是什么、解决问题、技术栈、Star 数量)
- - ✅ 企业微信机器人推送摘要
- - ✅ 支持 GITHUB_TOKEN 提升 API 额度
- **适用场景:**
- - 技术趋势日报/周报
- - 团队技术分享与学习
- - 新项目调研与选型
- **使用方式:**
- ```
- 请帮我使用github-trending-skill 这个skill获取今天最热门的github开源项目内容,并使用ui-ux-pro-max-skill
- 这个skill生成科技风格的日报信息,并输出html当前文件夹下
- ```
- 企业微信收到的消息
- 
- 使用ui-ux-pro-max-skill 生成的html效果
- 
- **配置说明:**
- - `GITHUB_TOKEN`:可选,用于提高 GitHub API 额度
- - `WEIXIN_WEBHOOK`:可选,覆盖默认企业微信机器人地址
- ---
- ### 🎨 GitHub Trending Wan (GitHub 热门开源信息图海报)
- **核心功能:**
- - ✅ 抓取 GitHub Trending **Top 5** 项目,获取 Star、语言、技术栈、README 摘要等元数据
- - ✅ 调用 DashScope 兼容 API,将英文摘要字段翻译为简体中文
- - ✅ 生成低信息密度的中文简报(Markdown)和 Wan 2.7 海报 Prompt
- - ✅ 支持 **10 种视觉风格**(坐标蓝图 / 复古波普 / 文件夹 / 热敏纸 / 复古手帐 / 陶土手绘 / 酸性复古 / 剧场票据 / 矢量插图 / 孟菲斯网格)
- - ✅ 采用 **3 步引导式工作流**:启动询问 → 信息提取 → 确认生图
- **10 种视觉风格:**
- | # | 风格 | 核心特征 | 适用场景 |
- |---|------|----------|----------|
- | 1 | 🧪 坐标蓝图 | 坐标系统 + 技术网格 | 技术参数、专业评测 |
- | 2 | 📐 复古波普 | 瑞士网格 + 粗黑线 | 干货清单、对比表格 |
- | 3 | 📁 文件夹 | 3D 文具 + 剪贴板 | 系统指南、分类清单 |
- | 4 | 🧾 热敏纸 | 票据穿孔 + 3D 图标 | 步骤清单、时间线 |
- | 5 | 📓 复古手帐 | 拼贴证据板 + 图钉 | 案例研究、调查分析 |
- | 6 | ✏️ 陶土手绘 | 涂鸦粗轮廓 + 几何形 | 轻松干货、亲和科普 |
- | 7 | 💾 酸性复古 | Y2K 像素 + 镭射渐变 | 数码评测、极客内容 |
- | 8 | 🎫 剧场票据 | 票根胶片 + 五幕剧 | 故事演进、系列指南 |
- | 9 | 🖼️ 矢量插图 | 黑轮廓线稿 + 几何简化 | PPT 封面、场景插画 |
- | 10 | 🎨 孟菲斯网格 | 可见网格 + 模块色块 | 高密度信息、艺术指南 |
- **适用场景:**
- - 开源日报/周报可视化
- - 技术趋势信息图海报
- - GitHub Trending 中文解读分享
- - 小红书/公众号技术内容配图
- **工作流程:**
- ```
- 步骤 1: 启动询问 → 收集日期、受众、风格偏好
- 步骤 2: 信息提取 → 抓取、翻译、生成简报
- 步骤 3: 确认生图 → 用户确认后调用 Wan 2.7
- ```
- **使用示例:**
- ```bash
- # 步骤 1:抓取 Trending Top 5
- python3 scripts/fetch_daily_top10.py --top 5 --date-label "2026-04-08"
- # 步骤 2:翻译为中文
- python3 scripts/translate_daily_top.py --input output/daily_top10.json
- # 步骤 3:生成简报和 Wan Prompt(孟菲斯网格风格)
- python3 scripts/build_daily_poster_assets.py --style 10 --size 2K --ratio 3:4
- # 步骤 4:调用 Wan 2.7 生图
- python3 scripts/run_wan_generation.py --prompt output/wan_prompt.txt
- ```
- **输出示例:**
- 生成海报效果:
- 
- **环境要求:**
- | 变量 | 必需 | 说明 |
- |------|------|------|
- | `DASHSCOPE_API_KEY` | 是 | DashScope API 密钥,用于翻译和 Wan 2.7 生图 |
- | `GITHUB_TOKEN` | 否 | GitHub Personal Access Token,减少 API 限流 |
- | `WAN_SKILL_DIR` | 否 | Wan 2.7 脚本目录 |
- **外部依赖:**
- 本 Skill 依赖 [Wan-skills-main](https://github.com/anthropics/wan-skills) 提供的 Wan 2.7 生图脚本。
- ---
- ### 📝 XiaoHuiHui Tech Article
- **核心功能:**
- - ✅ 公众号卡片:文章前言上方自动插入作者公众号名片卡片
- - ✅ 标准四段式结构(公众号卡片→前言→项目介绍→部署实战→总结→往期推荐)
- - ✅ 三段式开头(问题引入+解决方案+实战预告)
- - ✅ 详细部署步骤(环境→安装→配置→实现→测试)
- - ✅ 单段长句总结(300-500字)
- - ✅ 往期推荐:文章结尾自动附加最新5篇公众号文章链接
- - ✅ 口语化技术表达
- - ✅ 完整资源附加(GitHub+体验地址+网盘)
- - ✅ **Gemini-3-Pro-Image-Preview 双通道自动配图**(自建API + Gemai公益站)
- - ✅ 图片占位符自动替换为真实URL
- - ✅ 腾讯云COS图床自动上传
- **文章结构:**
- - **公众号卡片**:HTML格式名片卡片
- - **第1章**:前言(三段式,约300字)
- - **第2章**:项目介绍(约500字)
- - **第3章**:部署实战(约1500-2000字)
- - **第4章**:总结(单段300-500字)
- - **第5章**:往期推荐(最新5篇文章链接)
- **配图系统(v2.4.0 双通道):**
- - 🤖 **通道一(自建API)**:调用自建 Gemini API 生成技术配图
- - 🌐 **通道二(Gemai公益站)**:调用 api.gemai.cc 生成配图(备用通道)
- - ☁️ 自动上传至腾讯云COS图床
- - 🔗 自动替换文章中的图片占位符
- - 📸 支持多种图片类型:架构图、界面图、终端图、代码图、结果图
- - 💾 内存上传,无需本地缓存文件
- - 🔄 双通道自动切换:自建API优先,失败回退Gemai公益站
- **Gemai公益站命令行工具:**
- ```bash
- # 通过环境变量设置 API Key
- export GEMAI_API_KEY="你的API密钥"
- python3 gemai_image_generator.py --prompt "技术架构图,3D等距视角,蓝色科技风格"
- # 或通过命令行参数传入
- python3 gemai_image_generator.py --api-key "你的密钥" --prompt "描述内容" -o output.png
- # 支持风格、宽高比、批量生成
- python3 gemai_image_generator.py --prompt "架构图" --style realistic --aspect-ratio 16:9 --num-images 2
- ```
- **配置要求:**
- 1. 配置腾讯云COS环境变量:
- - `COS_SECRET_ID`:腾讯云访问密钥ID
- - `COS_SECRET_KEY`:腾讯云访问密钥Key
- - `COS_BUCKET`:COS存储桶名称
- - `COS_REGION`:COS存储桶所在地域
- 2. 配置图片生成API(二选一):
- - **自建API**:配置 Gemini API 地址和 Key
- - **Gemai公益站**:设置 `GEMAI_API_KEY` 环境变量
- **示例用法:**
- ```
- 请认真分析https://github.com/wwwzhouhui/in_animation开源项目,请帮我使用xiaohuihui-tech-article skill基于这个开源项目生成一个公众号文章。输出"20251101in_animation公众号文章.md"
- ```
- 
- 
- ---
- ### 🎨 Jimeng MCP Skill
- **核心功能:**
- - ✅ 文本生成图像(text-to-image)
- - ✅ 图像合成(image composition)
- - ✅ 文本生成视频(text-to-video)
- - ✅ 图像生成视频(image-to-video)
- - ✅ 支持多种分辨率和宽高比
- - ✅ **v2.0.0** 升级至 jimeng-4.5 模型
- - ✅ **v2.0.0** 新参数系统:ratio(宽高比)+ resolution(分辨率)
- - ✅ **v2.0.0** 替代旧参数:width/height + sample_strength
- **模型升级(v2.0.0):**
- - 🆙 **jimeng-4.0** → **jimeng-4.5**:更强大的生成能力
- - 📐 **ratio 参数**:16:9、4:3、1:1、3:4、9:16 等
- - 🎯 **resolution 参数**:360p、480p、720p、1080p 等
- - 📝 简化参数配置,提升易用性
- **适用场景:**
- - AI 内容创作(博客配图、短视频制作)
- - 产品宣传素材生成
- - UI 原型快速生成
- - 创意头脑风暴可视化
- **前置条件:**
- 1. jimeng-free-api-all Docker 容器运行
- 2. 配置 JIMENG_API_KEY 环境变量
- 3. jimeng-mcp-server 正确安装(支持 jimeng-4.5 模型)
- **技术特点:**
- - 基于 MCP(模型上下文协议)标准
- - 支持 stdio、SSE、HTTP 三种运行模式
- - 完全免费(每日 66 积分)
- - 响应时间:图像 10-20秒,视频 30-60秒
- ---
- ### 🎨 MP Cover Generator (公众号封面生成器)
- **核心功能:**
- - ✅ 根据主题自动生成 3D 插画风格封面底图
- - ✅ 智能叠加文字层(日期、标题、作者)
- - ✅ 描边卡通字体效果(鲜艳色彩 + 多层描边)
- - ✅ 垂直居中布局,视觉平衡完美
- - ✅ 双格式输出:HTML + 高清图片(PNG/JPG)
- - ✅ 完整页面截图(5120x2916,2x 像素密度)
- - ✅ 可爱圆润的卡通 3D 风格(类似皮克斯)
- - ✅ 返回 4 张不同风格供选择
- **适用场景:**
- - 公众号文章封面图制作
- - 社交媒体横幅图生成
- - 技术博客头图创作
- - 宣传海报快速设计
- **前置条件:**
- 1. jimeng-free-api-all Docker 容器运行
- 2. 配置 JIMENG_API_KEY 环境变量
- 3. jimeng-mcp-server 正确安装
- 4. Node.js 16+ 环境(图片输出功能)
- 5. Playwright 已安装(自动安装)
- **使用示例:**
- ```
- 请使用 mp-cover-generator skill 生成一个 MCP案例分享 claude调用AI生图视频教程 介绍的文章的公众号封面
- ```
- 
- 
- - ✅ 智能生成节点间的连接关系(edges)
- - ✅ 自动配置模型参数和提示词
- - ✅ 识别并配置所需的 Dify 插件依赖
- - ✅ 严格遵循 Dify 0.3.0 版本的 DSL 规范
- - ✅ 基于 86+ 真实工作流案例深度学习
- **适用场景:**
- - 快速构建 Dify 工作流配置文件
- - 批量生成工作流模板
- - 学习 Dify DSL 文件结构
- - 自动化工作流开发
- **知识库覆盖:**
- - App 配置(mode、icon、描述等)
- - Dependencies 依赖管理
- - 各类节点详解(LLM、Code、HTTP、If-Else、Tool、Variable Aggregator、Parameter Extractor)
- - Edges 连接规则
- - Position 坐标布局
- - 变量引用格式
- **示例用法:**
- ```
- 生成一个 Dify 工作流用于图片 OCR 识别:
- - 功能: 上传图片并识别文字
- - 输入: 图片文件
- - 处理: 使用 LLM 视觉能力进行 OCR
- - 输出: 识别到的文字内容
- ```
- 
- 生成的dsl导入dify 平台
- 
- **技术特点:**
- - 完整 DSL 结构生成(app + dependencies + workflow)
- - 智能节点 ID 生成(时间戳格式)
- - 合理的节点布局坐标
- - 支持复杂工作流逻辑(分支、循环、聚合)
- - 提供常用提示词模板(Text-to-SQL、数据提取、HTML 生成)
- ---
- ### 📝 XiaoHuiHui Dify Tech Article
- **核心功能:**
- - ✅ Dify 专属三段式结构(前言 → 工作流制作 → 总结)
- - ✅ 工作流节点详细配置说明
- - ✅ 插件安装和授权步骤图文教程
- - ✅ MCP Server 部署集成指南
- - ✅ 优先展示工作流效果
- - ✅ 口语化技术表达("话不多说"、"手把手搭建")
- - ✅ 魔搭社区免费模型推荐
- - ✅ 自动生成配图并上传腾讯云 COS 图床
- **文章结构:**
- - **前言**(300-400字):技术背景 + 问题引入 + 解决方案展示
- - **工作流制作**(1500-2500字):前置准备 + 节点配置 + 测试验证
- - **总结**(单段300-400字):完整流程回顾 + 核心价值 + 扩展场景
- **配图系统:**
- - 工作流全局图(1张)
- - 节点配置截图(6-10张)
- - 插件安装截图(2-3张)
- - 效果演示图(2-3张)
- - 代码配置图(1-2张)
- - 总计要求 >= 10 张实际截图
- **示例用法:**
- ```
- 用小灰灰公众号风格写一篇 Dify 文生视频工作流的案例分享:
- - 功能: 调用即梦AI实现文生视频
- - 涉及插件: Agent策略插件
- - 核心节点: LLM、Agent、代码执行
- - 技术栈: MCP、即梦API
- ```
- **质量标准:**
- - 总字数 > 1800字(优秀 > 2500字)
- - 标题格式:`dify案例分享-[功能名称]`
- - 工作流截图 >= 10个(优秀 >= 15个)
- - 节点配置说明 >= 5个
- - 代码块 >= 3个
- - 总结单段 300-400字,禁止分段
- - 固定结束语:"今天的分享就到这里结束了,我们下一篇文章见。"
- **技术特点:**
- - 遵循小灰灰公众号写作规范
- - 专注 Dify 工作流案例分享
- - 包含完整的插件安装教程
- - 支持 MCP Server 集成说明
- - 提供腾讯云 COS 图床上传脚本
- - 真实图片 URL,无占位符
- ---
- ### 🔍 Obsidian Search (Obsidian CLI 查询助手)
- **核心功能:**
- - ✅ 将自然语言检索需求转换为 Obsidian CLI 查询命令
- - ✅ 支持搜索笔记、查找上下文、筛选任务、标签、属性
- - ✅ 查询反向链接、文件列表、文档大纲
- - ✅ 自动选择最合适的 CLI 命令模式
- - ✅ 结果聚类和简洁总结
- **核心命令:**
- | 命令 | 功能说明 |
- |------|----------|
- | `obsidian search` | 文本搜索,查找包含关键词的笔记 |
- | `obsidian search:context` | 带上下文搜索,显示关键词出现的行 |
- | `obsidian read` | 读取指定笔记的完整内容 |
- | `obsidian files` | 列出指定目录下的文件 |
- | `obsidian tasks` | 查询待办事项 |
- | `obsidian tags` | 查看标签分布统计 |
- | `obsidian backlinks` | 查询反向链接 |
- | `obsidian links` | 查询出链 |
- | `obsidian outline` | 查看笔记大纲/标题层级 |
- **适用场景:**
- - 快速查找知识库中的笔记
- - 查看关键词出现的上下文
- - 整理待办事项和任务清单
- - 分析标签使用情况和知识分类
- - 查看笔记之间的引用关系
- - 浏览指定目录下的文档列表
- - 总结特定主题在知识库中的分布
- **使用示例:**
- ```
- 帮我找一下和 obsidian 相关的笔记
- → obsidian search query="obsidian" limit=5
- ```
- ```
- 看看哪些地方提到了 obsidian cli
- → obsidian search:context query="obsidian cli" limit=10
- ```
- ```
- 我的知识库里常用标签有哪些
- → obsidian tags counts format=json
- ```
- ```
- 谁引用了这篇笔记
- → obsidian backlinks file="Obsidian CLI 命令行接口" counts format=json
- ```
- ```
- 列出 work 目录下的文档
- → obsidian files folder="work"
- ```
- **查询策略:**
- - **先搜再读**:先用 `search` 缩小范围,再用 `read` 读取内容
- - **先列再筛**:先用 `files folder` 枚举目录,再筛选目标文件
- - **先看关系再读正文**:先用 `backlinks`/`links` 查看引用关系,再深入阅读
- **技术要求:**
- - 桌面版 Obsidian 正在运行
- - Obsidian CLI 已安装并配置
- **注意事项:**
- - 搜索命令默认只返回路径,不返回正文
- - 要看命中内容使用 `search:context`
- - `search` 的 `path=` 接收文件夹路径,不是文件路径
- - 若结果为空,会明确说明并尝试更宽松关键词
- ---
- ### 🛡️ Wechat Compliance Reviewer (微信公众号文章合规审查专家)
- **核心功能:**
- - ✅ 根据微信公众平台运营规范审查文章内容
- - ✅ 识别 9 大类违规风险(诱导分享、欺诈信息、营销推广、版权侵权等)
- - ✅ 提供详细修改建议和合规话术替代方案
- - ✅ 支持快速审查清单和深度审查两种模式
- - ✅ 输出结构化审查报告(风险等级 + 违规位置 + 修改建议)
- - ✅ 内置违规话术对照表和合规模板
- **审查范围:**
- | 风险等级 | 违规类型 | 检测内容 |
- |---------|---------|---------|
- | 🔴 高风险 | 诱导分享/关注 | "白嫖"、"薅羊毛"、"速转"、"分享给朋友"等 |
- | 🔴 高风险 | 营销推广/优惠码 | 优惠码、推荐链接(含 ref 参数)、购买链接 |
- | 🔴 高风险 | 欺诈/虚假信息 | "0 元"实际需绑卡、"免费"实际后续收费 |
- | 🔴 高风险 | 版权/知识产权 | 未授权转载、搬运内容、盗用图片 |
- | 🟡 中风险 | 金融/支付相关 | 指导绑卡、跨境支付、投资建议 |
- | 🟡 中风险 | 技术外挂/绕过付费 | 破解教程、绕过订阅、API 滥用 |
- | 🟡 中风险 | 夸大/虚假宣传 | 虚假参数、夸张用语、未证实数据 |
- | 🟠 低风险 | 外部链接/导流 | 外部网站链接、小程序跳转 |
- | 🟠 低风险 | 敏感话题 | 政治、色情、赌博、暴力 |
- **适用场景:**
- - 公众号文章发布前合规审查
- - 识别诱导分享、欺诈信息等违规风险
- - 获取合规修改建议和话术替代
- - 学习微信公众平台运营规范
- - 降低账号被封禁风险
- **使用方式:**
- ```
- 请帮我审查这篇公众号文章,看看有没有违规风险
- [粘贴文章内容]
- ```
- ```
- 请使用 wechat-compliance-reviewer 审查这篇文章,检查是否有诱导分享、营销推广等违规行为
- ```
- **审查报告示例:**
- ```markdown
- ## 审查结果总览
- | 风险等级 | 违规项数量 | 建议 |
- |---------|-----------|------|
- | 高风险 | 3 项 | 必须修改 |
- | 中风险 | 2 项 | 强烈建议修改 |
- | 低风险 | 1 项 | 可考虑修改 |
- **综合结论**:❌ 不建议按当前版本发布,存在较高封号风险
- ## 详细问题清单
- ### 问题 1:诱导分享行为
- - **位置**:第 3 段
- - **原文**:"赶紧分享给你的朋友们,一起薅羊毛!"
- - **违规原因**:违反《微信公众平台运营规范》,禁止诱导用户分享行为
- - **风险等级**:⭐⭐⭐⭐⭐
- - **修改建议**:直接删除该句,或改为"如果你觉得有用,欢迎分享给需要的朋友"
- ```
- **参考资料:**
- - `violation-types.md` - 违规类型详解(10 大类违规行为和处罚措施)
- - `case-studies.md` - 处罚案例库(10 个真实封号案例和分析)
- - `compliant-templates.md` - 合规话术模板(违规话术替代方案和场景模板)
- **技术特点:**
- - 基于《微信公众平台运营规范》官方条款
- - 收录真实处罚案例分析
- - 提供合规话术对照表
- - 支持快速审查清单(8 项检查)
- - 分级处理(高风险必须修改,低风险酌情处理)
- - 考虑文章整体意图和上下文
- **处罚措施参考:**
- | 违规类型 | 首次处罚 | 多次处罚 | 严重处罚 |
- |---------|---------|---------|---------|
- | 诱导分享 | 删除文章 | 限制功能 7-30 天 | 永久封号 |
- | 营销推广 | 删除文章 | 限制流量 | 封禁广告功能 |
- | 欺诈信息 | 删除文章 | 封号 | 移交司法 |
- | 版权侵权 | 删除文章 | 赔偿 | 账号降权 |
- ---
- ### 🌐 SiliconFlow API Skills
- **核心功能:**
- - ✅ 大语言模型 API 调用指南
- - ✅ Chat Completions API 完整文档
- - ✅ Stream 流式输出模式支持
- - ✅ 图片生成 API 使用说明
- - ✅ 向量模型/Embedding API 文档
- - ✅ 模型列表和参数配置
- - ✅ 最佳实践和代码示例
- **适用场景:**
- - 在 Claude Code 中调用硅基流动 API
- - 开发基于 SiliconFlow 的 AI 应用
- - 学习大语言模型 API 调用方式
- - 调试和优化 API 调用代码
- - 了解 SiliconFlow 平台功能特性
- **参考文档:**
- - `api_reference.md` - API 参考文档
- - `deployment.md` - 部署文档
- - `faqs.md` - 常见问题
- - `features.md` - 功能特性
- - `models.md` - 模型列表
- - `userguide.md` - 用户指南
- - `use_cases.md` - 使用案例
- **示例用法:**
- ```
- 请帮我使用siliconflow-api-skills 这个skill技能包生成调用硅基流动的API 实现文本生成的模型接口,使用python 代码实现,
- 使用deepseek-ai/DeepSeek-V3.2-Exp 模型
- ```
- 
- **技术特点:**
- - 基于官方文档自动生成
- - 包含完整的代码示例
- - 支持多种编程语言
- - 涵盖从入门到高级的所有内容
- ---
- ### 📖 GitHub README Generator
- **核心功能:**
- - ✅ 自动生成标准的 GitHub README.md 文档
- - ✅ 支持 6 种项目模板(basic/full/library/webapp/cli/api)
- - ✅ 交互式生成和基于现有项目自动生成
- - ✅ 自动识别项目类型和技术栈
- - ✅ 生成 Badge 和 Star History
- - ✅ 包含作者联系和打赏信息
- - ✅ 生成常见问题 FAQ
- - ✅ 支持中英文双语
- **适用场景:**
- - 新项目快速创建 README
- - 现有项目文档规范化
- - 开源项目文档优化
- - 学习标准文档结构
- **使用示例:**
- ```
- 请使用 full 模板为我的 Vue 项目生成 README
- 项目信息:
- - 名称:vue-admin
- - 简介:一个现代化的 Vue 后台管理系统
- - 技术栈:Vue 3, Vite, Element Plus, Pinia
- - 功能:权限管理、动态路由、图表统计
- ```
- **可用模板:**
- | 模板 | 说明 | 适用场景 |
- |------|------|----------|
- | basic | 基础模板 | 所有项目 |
- | full | 完整模板(包含所有章节) | 中大型项目 |
- | minimal | 极简模板 | 小型工具 |
- | library | 库/SDK 专用模板 | npm 包、Go 库等 |
- | webapp | Web 应用模板 | 前后端项目 |
- | cli | CLI 工具模板 | 命令行工具 |
- | api | API 服务模板 | REST API 服务 |
- **技术特点:**
- - 支持交互式引导生成
- - 自动分析项目结构和技术栈
- - 根据项目类型调整文档结构
- - 包含完整的最佳实践指南
- - 提供多种模板示例参考
- **版本历史:**
Lines 2,001–3,277 are not shown. The link to the file on GitHub has every line.
grok-imagine-image/scripts/generate.py · Bundled script · 364 lines · 2 findings marked
- #!/usr/bin/env python3
- """通过兼容 Grok2API 的接口,使用 grok-imagine-image 生成图片。"""
- from __future__ import annotations
- import argparse
- import json
- import os
- import re
- import sys
- import time
- import urllib.error
- import urllib.request
- from pathlib import Path
- from typing import Any
- from urllib.parse import urlparse, urlunparse
- # Placeholder credentials. Replace before production use.
- DEFAULT_API_BASE = "http://43.163.230.83:8000/v1"
- Warning: Talks to a raw IP address or throwaway host, where malware is often staged
- Warning: Defaults to an unencrypted HTTP server at a raw IP address (43.163.230.83). Your prompts and the API key you supply are sent there unless you override the base URL. Its owner is not identified.
- Line 20 on GitHub
- DEFAULT_API_KEY = "g2a_REPLACE_ME"
- DEFAULT_MODEL = "grok-imagine-image"
- DEFAULT_TIMEOUT = 180
- DEFAULT_SIZE = "1024x1024"
- def eprint(*args: Any) -> None:
- print(*args, file=sys.stderr)
- def resolve_api_base(value: str | None) -> str:
- base = (value or os.environ.get("GROK_IMAGINE_API_BASE") or DEFAULT_API_BASE).rstrip("/")
- if not base.endswith("/v1"):
- # Accept either host root or full /v1 base.
- if base.endswith("/v1/"):
- base = base.rstrip("/")
- else:
- base = f"{base}/v1"
- return base
- def resolve_api_key(value: str | None) -> str:
- key = value or os.environ.get("GROK_IMAGINE_API_KEY") or DEFAULT_API_KEY
- if not key or key == "g2a_REPLACE_ME":
- eprint(
- "错误:API Key 仍是占位符。"
- "请设置 GROK_IMAGINE_API_KEY,或传入 --api-key,"
- "或修改本脚本中的 DEFAULT_API_KEY。"
- )
- sys.exit(2)
- return key
- def rewrite_media_url(url: str, api_base: str) -> str:
- """Rewrite loopback media URLs to the configured public API host."""
- parsed = urlparse(url)
- host = (parsed.hostname or "").lower()
- if host not in {"127.0.0.1", "localhost", "0.0.0.0"}:
- return url
- base = urlparse(api_base if "://" in api_base else f"http://{api_base}")
- # Keep path from media URL; swap scheme/netloc to public host.
- return urlunparse(
- (
- base.scheme or "http",
- base.netloc,
- parsed.path,
- parsed.params,
- parsed.query,
- parsed.fragment,
- )
- )
- def http_json(
- method: str,
- url: str,
- *,
- api_key: str,
- payload: dict[str, Any] | None = None,
- timeout: int = DEFAULT_TIMEOUT,
- ) -> tuple[int, dict[str, str], Any]:
- data = None
- headers = {
- "Authorization": f"Bearer {api_key}",
- "Accept": "application/json",
- "User-Agent": "grok-imagine-image-skill/1.0",
- }
- if payload is not None:
- data = json.dumps(payload, ensure_ascii=False).encode("utf-8")
- headers["Content-Type"] = "application/json"
- req = urllib.request.Request(url, data=data, headers=headers, method=method)
- try:
- with urllib.request.urlopen(req, timeout=timeout) as resp:
- body = resp.read()
- headers_out = {k.lower(): v for k, v in resp.headers.items()}
- text = body.decode("utf-8", errors="replace")
- try:
- parsed = json.loads(text) if text else {}
- except json.JSONDecodeError:
- parsed = {"raw": text}
- return resp.status, headers_out, parsed
- except urllib.error.HTTPError as err:
- body = err.read()
- text = body.decode("utf-8", errors="replace")
- try:
- parsed = json.loads(text) if text else {"error": {"message": text}}
- except json.JSONDecodeError:
- parsed = {"error": {"message": text or str(err)}}
- headers_out = {k.lower(): v for k, v in err.headers.items()} if err.headers else {}
- return err.code, headers_out, parsed
- except urllib.error.URLError as err:
- raise RuntimeError(f"调用 {url} 时网络错误: {err}") from err
- def download_file(url: str, dest: Path, *, api_key: str, timeout: int) -> Path:
- dest.parent.mkdir(parents=True, exist_ok=True)
- req = urllib.request.Request(
- url,
- headers={
- "Authorization": f"Bearer {api_key}",
- "User-Agent": "grok-imagine-image-skill/1.0",
- },
- method="GET",
- )
- with urllib.request.urlopen(req, timeout=timeout) as resp:
- content_type = (resp.headers.get("Content-Type") or "").split(";")[0].strip().lower()
- data = resp.read()
- # Ensure extension based on content type if missing.
- if dest.suffix.lower() not in {".jpg", ".jpeg", ".png", ".webp", ".gif"}:
- ext = {
- "image/jpeg": ".jpg",
- "image/jpg": ".jpg",
- "image/png": ".png",
- "image/webp": ".webp",
- "image/gif": ".gif",
- }.get(content_type, ".jpg")
- dest = dest.with_suffix(ext)
- dest.write_bytes(data)
- return dest
- def slugify(text: str, max_len: int = 48) -> str:
- text = text.strip().lower()
- text = re.sub(r"[^a-z0-9\u4e00-\u9fff]+", "-", text, flags=re.IGNORECASE)
- text = re.sub(r"-+", "-", text).strip("-")
- if not text:
- text = "image"
- return text[:max_len].rstrip("-")
- def generate_images(
- *,
- prompt: str,
- api_base: str,
- api_key: str,
- model: str,
- n: int,
- size: str,
- timeout: int,
- response_format: str | None,
- ) -> dict[str, Any]:
- url = f"{api_base}/images/generations"
- payload: dict[str, Any] = {
- "model": model,
- "prompt": prompt,
- "n": n,
- "size": size,
- }
- if response_format:
- payload["response_format"] = response_format
- status, _headers, body = http_json(
- "POST",
- url,
- api_key=api_key,
- payload=payload,
- timeout=timeout,
- )
- if status >= 400:
- message = body
- if isinstance(body, dict):
- err = body.get("error") or body
- if isinstance(err, dict):
- message = err.get("message") or err
- raise RuntimeError(f"图片生成失败({status}): {message}")
- if not isinstance(body, dict) or "data" not in body:
- raise RuntimeError(f"响应结构异常: {body}")
- return body
- def parse_args(argv: list[str] | None = None) -> argparse.Namespace:
- parser = argparse.ArgumentParser(
- description="使用 grok-imagine-image 生成图片(兼容 Grok2API)。"
- )
- parser.add_argument("--prompt", help="图片提示词")
- parser.add_argument("--prompt-file", help="从文本文件读取提示词")
- parser.add_argument(
- "--output-dir",
- default="./outputs",
- help="图片保存目录(默认: ./outputs)",
- )
- parser.add_argument(
- "--name-tag",
- default=None,
- help="文件名前缀(默认根据提示词生成)",
- )
- parser.add_argument("--n", type=int, default=1, help="生成数量(默认: 1)")
- parser.add_argument(
- "--size",
- default=DEFAULT_SIZE,
- help=f"图片尺寸(默认: {DEFAULT_SIZE})",
- )
- parser.add_argument(
- "--model",
- default=os.environ.get("GROK_IMAGINE_MODEL", DEFAULT_MODEL),
- help=f"模型 ID(默认: {DEFAULT_MODEL})",
- )
- parser.add_argument(
- "--api-base",
- default=None,
- help=f"API 基础地址(默认: {DEFAULT_API_BASE} 或 GROK_IMAGINE_API_BASE)",
- )
- parser.add_argument(
- "--api-key",
- default=None,
- help="API Key(默认: GROK_IMAGINE_API_KEY 或脚本内占位符)",
- )
- parser.add_argument(
- "--timeout",
- type=int,
- default=DEFAULT_TIMEOUT,
- help=f"HTTP 超时秒数(默认: {DEFAULT_TIMEOUT})",
- )
- parser.add_argument(
- "--response-format",
- choices=["url", "b64_json"],
- default=None,
- help="可选的 OpenAI 风格 response_format",
- )
- parser.add_argument(
- "--no-download",
- action="store_true",
- help="只打印 API 结果,不下载图片",
- )
- parser.add_argument(
- "--json",
- action="store_true",
- help="向标准输出打印机器可读 JSON 摘要",
- )
- return parser.parse_args(argv)
- def main(argv: list[str] | None = None) -> int:
- args = parse_args(argv)
- if args.prompt_file:
- prompt = Path(args.prompt_file).read_text(encoding="utf-8").strip()
- elif args.prompt:
- prompt = args.prompt.strip()
- else:
- eprint("错误:请提供 --prompt 或 --prompt-file")
- return 2
- if not prompt:
- eprint("错误:提示词为空")
- return 2
- api_base = resolve_api_base(args.api_base)
- api_key = resolve_api_key(args.api_key)
- output_dir = Path(args.output_dir)
- name_tag = args.name_tag or slugify(prompt)
- eprint(f"API 地址 : {api_base}")
- eprint(f"模型 : {args.model}")
- eprint(f"提示词 : {prompt[:120]}{'...' if len(prompt) > 120 else ''}")
- eprint(f"输出目录 : {output_dir}")
- started = time.time()
- result = generate_images(
- prompt=prompt,
- api_base=api_base,
- api_key=api_key,
- model=args.model,
- n=max(1, args.n),
- size=args.size,
- timeout=args.timeout,
- response_format=args.response_format,
- )
- elapsed = time.time() - started
- items = result.get("data") or []
- saved: list[dict[str, Any]] = []
- for idx, item in enumerate(items):
- if not isinstance(item, dict):
- continue
- raw_url = item.get("url") or ""
- public_url = rewrite_media_url(str(raw_url), api_base) if raw_url else ""
- mime = item.get("mime_type") or "image/jpeg"
- record: dict[str, Any] = {
- "index": idx,
- "mime_type": mime,
- "url": public_url or raw_url,
- "raw_url": raw_url,
- "revised_prompt": item.get("revised_prompt") or "",
- }
- if not args.no_download and public_url:
- stamp = time.strftime("%Y%m%d-%H%M%S")
- filename = f"{name_tag}-{stamp}-{idx + 1}"
- dest = output_dir / filename
- try:
- path = download_file(
- public_url,
- dest,
- api_key=api_key,
- timeout=args.timeout,
- )
- record["path"] = str(path.resolve())
- record["bytes"] = path.stat().st_size
- eprint(f"已保存[{idx + 1}]: {path} ({record['bytes']} 字节)")
- except Exception as err: # noqa: BLE001 - surface download issues clearly
- record["download_error"] = str(err)
- eprint(f"警告:第 {idx + 1} 张图下载失败: {err}")
- saved.append(record)
- summary = {
- "ok": True,
- "model": args.model,
- "api_base": api_base,
- "prompt": prompt,
- "created": result.get("created"),
- "elapsed_sec": round(elapsed, 2),
- "count": len(saved),
- "images": saved,
- }
- if args.json:
- print(json.dumps(summary, ensure_ascii=False, indent=2))
- else:
- print("生成成功。")
- for item in saved:
- print(f"- url: {item.get('url')}")
- if item.get("path"):
- print(f" path: {item['path']}")
- if item.get("download_error"):
- print(f" download_error: {item['download_error']}")
- print(f"耗时: {summary['elapsed_sec']}s")
- return 0
- if __name__ == "__main__":
- try:
- raise SystemExit(main())
- except KeyboardInterrupt:
- eprint("已中断。")
- raise SystemExit(130)
- except Exception as err: # noqa: BLE001
- eprint(f"错误: {err}")
- raise SystemExit(1)
Ratings and comments
Sign in to rate this skill.
Sign inFree to use. If it’s helped, pass it on.