llm-wiki
个人知识库构建系统(基于 Karpathy llm-wiki 方法论)。让 AI 持续构建和维护你的知识库, 支持多种素材源(网页、推特、公众号、小红书、知乎、YouTube、PDF、本地文件), 自动整理为结构化的 wiki。 触发条件:用户明确提到"知识库"、"wiki"、"llm-wiki",或要求对已初始化的知识库执行 消化、查询、健康检查等操作。不要在用户只是要求"总结这篇文章"时触发——必须是明确的 知识库相关意图。
Safety scan
A static text scan, not a guarantee. Select the badge to see what was scanned and every finding.
Check it deeper on your machine
Its scripts were only partly scanned.
As a Claude Code plugin, install it and then ask Claude Code:
/plugin marketplace add keithmackay/mackayi/plugin install scanskillsafety@mackayiDo a deep scan of https://github.com/sdyckjq-lab/llm-wiki-skill with scanskillsafety
Or from a terminal, clone it and run it:
git clone https://github.com/keithmackay/scanskillsafety-skill ~/.claude/skills/scanskillsafetynode ~/.claude/skills/scanskillsafety/cli.cjs --deep 'https://github.com/sdyckjq-lab/llm-wiki-skill'
It checks the exact commit: every file, its packages against OSV (api.osv.dev), how it compares with this page's scan (findsafeskills.com receives the repository's address), and, if you agree, Claude reading every file with your own Claude subscription. It never runs the code.
Badge for your README

Markdown
[](/listings/sdyckjq-lab--llm-wiki-skill)HTML
<a href="/listings/sdyckjq-lab--llm-wiki-skill"><img src="/api/listings/sdyckjq-lab--llm-wiki-skill/badge.svg" alt="findsafeskills safety rating" /></a>Install
What was scanned
The files the safety scan read, as written by the repository's author and shown as plain text. Lines with a finding are marked.
SKILL.md · Manifest · 1,136 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
This file has changed since it was scanned, so this is not exactly the text that was scanned, and no line is marked. The findings are listed with the safety scan above.
- ---
- name: llm-wiki
- version: 3.6.4
- author: sdyckjq-lab
- license: MIT
- description: |
- 个人知识库构建系统(基于 Karpathy llm-wiki 方法论)。让 AI 持续构建和维护你的知识库,
- 支持多种素材源(网页、推特、公众号、小红书、知乎、YouTube、PDF、本地文件),
- 自动整理为结构化的 wiki。
- 触发条件:用户明确提到"知识库"、"wiki"、"llm-wiki",或要求对已初始化的知识库执行
- 消化、查询、健康检查等操作。不要在用户只是要求"总结这篇文章"时触发——必须是明确的
- 知识库相关意图。
- metadata:
- hermes:
- tags:
- - knowledge-base
- - wiki
- - research
- - note-taking
- ---
- # llm-wiki — 个人知识库构建系统
- > 把碎片化的信息变成持续积累、互相链接的知识库。你只需要提供素材,AI 做所有的整理工作。
- ## 这个 skill 做什么
- llm-wiki 帮你构建一个**持续增长的个人知识库**。它不是传统的笔记软件,而是一个让 AI 帮你维护的 wiki 系统:
- - 你给素材(链接、文件、文本),AI 提取核心知识并整理成互相链接的 wiki 页面
- - 知识库随着每次使用变得越来越丰富,而不是每次重新开始
- - 所有内容都是本地 markdown 文件,用 Obsidian 或任何编辑器都能查看
- ## 核心理念
- 传统方式(RAG/聊天记录)的问题:每次问问题,AI 都要从头阅读原始文件,没有积累。知识库的价值在于**知识被编译一次,然后持续维护**,而不是每次重新推导。
- ## 快速开始
- 告诉用户这两步就够了:
- 1. **初始化**:说"帮我初始化一个知识库"
- 2. **添加素材**:给一个链接或文件,说"帮我消化这篇"
- ---
- ## Script Directory
- Scripts located in `scripts/` subdirectory.
- **Path Resolution**:
- 1. `SKILL_DIR` = this SKILL.md's directory
- 2. Script path = `${SKILL_DIR}/scripts/<script-name>`
- ---
- ## 依赖检查
- 核心主线(本地文件、纯文本、已有知识库操作)默认不需要这些提取依赖。
- 只有当用户给的是 URL 类来源,并且明确要自动提取网页 / X / 微信公众号 / YouTube / 知乎内容时,才检查以下可选依赖。
- 如果缺失,提示用户运行:
- ```bash
- bash ${SKILL_DIR}/install.sh --platform <当前平台> --with-optional-adapters
- ```
- 可选依赖 skill / 工具:
- - `baoyu-url-to-markdown` — 普通网页、X/Twitter、部分知乎提取
- - `wechat-article-to-markdown` — 微信公众号提取
- - `youtube-transcript` — YouTube 字幕提取
- 即使这些依赖缺失,skill 仍可工作(用户可以直接提供本地文件、粘贴文本,或改走手动入口)。
- ## 外挂状态模型
- 外挂失败统一分成 `not_installed / env_unavailable / runtime_failed / unsupported / empty_result` 五类。
- 所有需要枚举来源、读取 `source_label`、`raw_dir`、`adapter_name`、`fallback_hint` 的地方,都先读来源总表:
- ```bash
- bash ${SKILL_DIR}/scripts/source-registry.sh list
- ```
- 需要拿单个来源的定义时,用:
- ```bash
- bash ${SKILL_DIR}/scripts/source-registry.sh get <source_id>
- ```
- 对 URL 类来源,先运行:
- ```bash
- bash ${SKILL_DIR}/scripts/adapter-state.sh check <source_id>
- ```
- `adapter-state.sh check` 返回 8 列:
- ```text
- source_id source_label state state_label detail recovery_action install_hint fallback_hint
- ```
- - `not_installed`:提示用户可补安装,同时允许改走手动入口
- - `env_unavailable`:说明缺少的环境条件,同时允许改走手动入口
- - `runtime_failed`:说明本次提取执行失败,允许重试一次,再改走手动入口
- - `unsupported`:直接给出手动入口,不尝试自动提取
- - `empty_result`:说明自动提取没拿到有效内容,请用户手动补全文本
- 当自动提取实际执行后,再运行:
- ```bash
- bash ${SKILL_DIR}/scripts/adapter-state.sh classify-run <source_id> <exit_code> <output_path>
- ```
- 用返回的 `detail`、`recovery_action`、`install_hint`、`fallback_hint` 生成提示。核心主线不因外挂失败而中断。
- ---
- ## 工作流路由
- 根据用户的意图,路由到对应的工作流:
- | 用户意图关键词 | 工作流 |
- |---|---|
- | "初始化知识库"、"新建 wiki"、"创建知识库" | → **init** |
- | URL / 文件路径 / "添加素材"、"消化"、"整理" / 直接给链接 | → **ingest** |
- | "批量消化"、"把这些都整理" / 给了文件夹路径 | → **batch-ingest** |
- | "关于 XX"、"查询"、"XX 是什么"、"总结一下" | → **query** |
- | "给我讲讲 XX"、"深度分析 XX"、"综述 XX"、"digest XX" | → **digest** |
- | "对比一下 X 和 Y"、"比较 X 和 Y"、"整理一下时间线"、"按时间排列" | → **digest**(指定格式) |
- | "检查知识库"、"健康检查"、"lint" | → **lint** |
- | "知识库状态"、"现在有什么"、"有多少素材" | → **status** |
- | "画个知识图谱"、"看看关联图"、"graph"、"知识库地图" | → **graph** |
- | "删除素材"、"remove"、"delete source"、"移除" | → **delete** |
- | "结晶化"、"crystallize"、"把这个记进知识库"、"总结这段对话" | → **crystallize** |
- **重要**:如果用户直接给了一个 URL 或文件,但没有明确说要做什么,默认走 **ingest** 工作流。如果知识库还不存在,先自动走 **init** 再走 **ingest**。
- ---
- ## 通用前置检查
- 除 `init` 外,其他工作流默认先执行这段检查:
- 1. 先检查**当前工作目录**是否包含 `.wiki-schema.md`
- - 如果包含 → 用当前目录作为知识库根路径
- - 如果不包含 → 回退到读取 `~/.llm-wiki-path`
- 2. 如果两者都没有:
- - `ingest` / `batch-ingest` → 先运行 `init`
- - `query` / `lint` / `status` / `digest` / `graph` / `delete` → 提示用户先初始化知识库
- 3. 读取知识库根目录下的 `.wiki-schema.md`
- 4. 从 `.wiki-schema.md` 的"语言"字段判断 `WIKI_LANG`
- - `语言:中文` → `WIKI_LANG=zh`
- - `语言:English` → `WIKI_LANG=en`
- - 字段缺失 → 默认 `WIKI_LANG=zh`
- ## 输出语言规则
- 所有面向用户的输出和新写入的 wiki 内容,都按 `WIKI_LANG` 生成:
- - `WIKI_LANG=zh` → 使用下文中文示例
- - `WIKI_LANG=en` → 保持与中文示例相同的结构、信息量和顺序,仅改为自然英文措辞
- - 文件路径、wiki 链接、目录名保持现有约定,不因为语言切换而改动
- **术语对照**:
- - 素材 → Source
- - 实体 → Entity
- - 主题 → Topic
- - 摘要 → Summary
- - 综合 → Synthesis
- - 消化 → Ingest
- - 对比 → Comparison
- - 深度报告 → Deep Dive Report
- - 知识图谱 → Knowledge Graph
- ---
- ## 工作流 1:init(初始化知识库)
- ### 前置检查(含多知识库 CWD 检查)
- 1. 先检查**当前工作目录**是否包含 `.wiki-schema.md`
- - 如果包含 → 当前目录已经是一个知识库,提示用户已存在并询问是否要重新初始化
- 2. 如果当前目录没有 → 读取 `~/.llm-wiki-path` 文件
- - 如果存在 → 提示用户已有一个知识库(显示路径),询问是要新建还是切换到那个
- 3. 两个都没有 → 进入初始化流程
- ### 步骤
- 1. **询问知识库主题**(先向用户提问):
- - "你的知识库要围绕什么主题?比如'AI 学习笔记'、'产品竞品分析'、'读书笔记'"
- - 如果用户没想法,默认用"我的知识库"
- 2. **询问知识库语言**(先向用户提问):
- - "知识库内容用什么语言?中文 / English(默认中文)"
- - 选项:`zh`(中文)或 `en`(English)
- - 如果用户没有明确说,默认 `zh`
- - 将选择记录为 `WIKI_LANG`(`zh` 或 `en`)
- 3. **询问保存位置**(先向用户提问):
- - 默认:`~/Documents/我的知识库/`(zh)或 `~/Documents/my-wiki/`(en)
- - 用户可以自定义路径
- 4. **运行初始化脚本**:
- ```bash
- bash ${SKILL_DIR}/scripts/init-wiki.sh "<路径>" "<主题>"
- ```
- 5. **补充初始化结果说明**:
- - `init-wiki.sh` 会同时生成 `purpose.md` 和 `.wiki-cache.json`
- - `purpose.md` 和 `.wiki-schema.md` 同级存放,用来记录研究目标、关键问题和研究范围
- - 提醒用户优先填写核心目标和关键问题;这些内容写在 `purpose.md` 里,后续 ingest 会优先参考这里的方向
- 6. **写入语言配置并本地化种子文件**:
- - 将 `.wiki-schema.md` 中的 `语言:{{LANGUAGE}}` 替换为:
- - `zh` → `语言:中文`(种子文件保持中文,无需额外处理)
- - `en` → `语言:English`,**同时**覆写以下种子文件为英文版:
- - 如果 `WIKI_LANG=en`,读取 `${SKILL_DIR}/templates/index-en-template.md`、`${SKILL_DIR}/templates/overview-en-template.md`、`${SKILL_DIR}/templates/log-en-template.md`,将 `{{DATE}}` 和 `{{TOPIC}}` 替换为实际值后,分别写入 `index.md`、`wiki/overview.md`、`log.md`
- 7. **记录路径**到 `~/.llm-wiki-path`:
- ```bash
- echo "<路径>" > ~/.llm-wiki-path
- ```
- 8. **输出引导**(根据 `WIKI_LANG` 切换语言):
- **中文(zh)**:
- ```
- 知识库已创建!路径:<路径>
- 接下来你可以:
- - 给我一个链接,我会自动提取并整理(网页、X/Twitter、公众号、知乎等)
- - 小红书内容请直接粘贴文本给我(暂不支持自动提取)
- - 给我一个本地文件路径(PDF、Markdown 等)
- - 直接粘贴文本内容
- - 批量消化:给我一个文件夹路径
- 推荐:用 Obsidian 打开这个文件夹,可以实时看到知识库的构建效果。
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ---
- ## 工作流 2:ingest(消化素材)
- 这是最核心的工作流。用户给一个素材进来,AI 做所有的整理工作。
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。
- ### 隐私自查提示(首次进入 ingest 必须执行)
- 在开始提取或分析任何内容之前,AI **必须**先对用户说下面这句话,然后等待确认:
- > 在开始分析这份素材前,请先快速确认里面**不**包含这些敏感内容:
- >
- > - 手机号码(如 138xxxxxxxx)
- > - 身份证号(18 位数字)
- > - API 密钥(`sk-...`、`AIzaSy...`、`OPENAI_API_KEY=`、`ANTHROPIC_API_KEY=`、`Bearer ...`)
- > - 明文密码(`password=`、`passwd=`)
- > - 其他你不希望进入知识库的个人信息
- >
- > 如果素材里有上面任何一项,请先用文本编辑器删除或脱敏后再继续。
- > llm-wiki **不会**自动过滤这些内容,处理后的内容会进入你的知识库。
- >
- > 确认无上述内容请回复 `y`,要中止请回复 `n`。
- **流程规则**:
- - 用户回复 `y`(或"可以"、"继续"、"没有"等明确肯定)→ 继续执行后续步骤
- - 用户回复 `n`(或"停"、"取消"等明确否定)→ 终止本次 ingest,提示用户清理后再来
- - 其他不明确的回复 → 再问一次,最多两次;两次都不是明确 y/n 则终止
- - **绕过规则**:如果用户在当前对话里已经明确说过"素材里没有敏感信息,直接开始",
- 或者用户是在 `batch-ingest` 流程中(已经在顶层确认过一次),AI 可以跳过这一步
- **为什么是自查清单而不是脚本**:
- - 正则在非结构化文本(聊天记录、笔记)里误报率很高,错过真的敏感词,误报无害的普通词
- - 把判断权还给用户,比让脚本决定更可靠
- - 对新手更友好,不会遇到看不懂的脚本报错
- ### 素材提取路由
- 根据素材类型自动路由到最佳提取方式:
- **外挂前置判断**:
- - URL 先调用 `bash ${SKILL_DIR}/scripts/source-registry.sh match-url "<url>"`
- - 本地文件先调用 `bash ${SKILL_DIR}/scripts/source-registry.sh match-file "<path>"`
- - 纯文本粘贴直接调用 `bash ${SKILL_DIR}/scripts/source-registry.sh get plain_text`
- - `source-registry.sh` 返回 10 列:`source_id`、`source_label`、`source_category`、`input_mode`、`match_rule`、`raw_dir`、`adapter_name`、`dependency_name`、`dependency_type`、`fallback_hint`
- - 调用 `bash ${SKILL_DIR}/scripts/adapter-state.sh check <source_id>`
- - 从 `adapter-state.sh check` 的 8 列结果里读取 `state`、`detail`、`recovery_action`、`install_hint`、`fallback_hint`
- - 如果 `state=not_installed` / `env_unavailable` / `unsupported` → 不调用外挂,直接按 `detail`、`recovery_action`、`install_hint`、`fallback_hint` 告诉用户下一步
- - 只有返回 `available` 时,才继续自动提取
- **URL 类素材**(统一走来源总表,不手写域名表):
- > **Chrome 提示**(仅当 `adapter_name=baoyu-url-to-markdown` 时):
- > adapter-state.sh check 会把“提取器可用”与“是否存在 9222 可复用会话”分开表达。
- > 如果 check 返回 `available`,正常调用外挂;即使 detail 提示未检测到 9222,也继续执行。baoyu-url-to-markdown 会自己处理 Chrome 启动,**继续执行,不要等待用户确认**。
- > 只有在你想复用当前已登录的 Chrome 会话时,才需要手动开启 9222。
- > 如果提取仍然失败(通常是页面需要登录态,如 X/Twitter、知乎等),可提示用户开启调试端口复用已登录会话:`open -na "Google Chrome" --args --remote-debugging-port=9222`
- - 如果 `source_category=manual_only` → 不调用外挂,直接使用 `fallback_hint`
- - 如果 `adapter_name=wechat-article-to-markdown` → 执行 `wechat-article-to-markdown "<URL>"`
- - 如果 `adapter_name=youtube-transcript` → 调用 `youtube-transcript`
- - 如果 `adapter_name=baoyu-url-to-markdown` → 调用 `baoyu-url-to-markdown`
- **本地文件**:
- - 统一走 `bash ${SKILL_DIR}/scripts/source-registry.sh match-file "<path>"`
- - 命中后直接读取,不调用外挂
- **纯文本粘贴**:
- - 统一视为 `plain_text`
- - 直接使用用户提供的文本
- **统一回退规则**:
- - 对自动提取结果,统一运行 `bash ${SKILL_DIR}/scripts/adapter-state.sh classify-run <source_id> <exit_code> <output_path>`
- - 从 `classify-run` 返回的 8 列结果里读取 `state`、`detail`、`recovery_action`、`fallback_hint`
- - 如果返回 `runtime_failed` → 按 `detail`、`recovery_action`、`fallback_hint` 告诉用户“这次自动提取失败,可以先重试一次;如果还不行,就改走手动入口”
- - 如果返回 `empty_result` → 按 `detail`、`recovery_action`、`fallback_hint` 告诉用户“自动提取没有拿到有效正文,请手动补全文本后继续”
- - 其他状态也使用同一份返回结果,不再手写第二套回退文案
- ### 内容分级处理
- 根据素材长度和信息密度自动选择处理级别:
- **判断标准**:
- - 素材内容 > 1000 字 → **完整处理**
- - 素材内容 <= 1000 字(短推文、小红书笔记等)→ **简化处理**
- ### 完整处理流程(长素材 > 1000 字)
- 1. **提取素材内容**:按上面的路由获取素材文本
- 2. **保存原始素材**到 `raw/` 对应目录:
- - 根据素材类型保存到对应目录(articles/、tweets/、wechat/、xiaohongshu/、zhihu/ 等)
- - 文件名格式:`{日期}-{短标题}.md`
- - 如果是 URL 类素材,在文件头部记录原始 URL
- **图片检测与追踪**:保存素材后,扫描内容中是否包含图片引用(`![` 或 `<img` 或 `.png`/`.jpg`/`.gif`/`.svg` URL)。如果检测到图片:
- - 告诉用户:"素材包含 {N} 张图片引用。图片链接可能失效,建议手动下载到 `raw/assets/`(Obsidian 用户可在设置中绑定快捷键一键下载附件)"
- - 在后续 source 页面的 frontmatter 中:
- - `images`:记录检测到的图片引用数量
- - `image_paths`:如果用户已将图片下载到 `raw/assets/`,用 YAML block list 格式记录路径;如果尚未下载,保持为空数组 `[]`。示例:
- ```yaml
- image_paths:
- - raw/assets/2026-01-15-fig1.png
- - raw/assets/2026-01-15-fig2.jpg
- ```
- - 不阻塞 ingest 流程,仅做提醒
- - 用户后续下载图片后,可以手动更新 source 页面的 `image_paths`,或在下次 lint 时由 AI 辅助补全
- 3. **读取上下文**:
- - 优先顺序:`purpose.md` > `.wiki-schema.md` > `index.md`
- - 如果 `purpose.md` 存在,先读取其中的核心目标、关键问题和研究范围
- - 用 `purpose.md` 指导后续实体、主题、关联的取舍和权重
- 4. **缓存检查**:
- - 在进入 LLM 处理前,先运行:
- ```bash
- bash ${SKILL_DIR}/scripts/cache.sh check “<raw 文件路径>”
- ```
- - 如果返回 `HIT` 或 `HIT(repaired)` → 跳过本次 LLM 调用,直接读取已有 wiki 页面,并告诉用户这是”无变化,直接复用已有结果”
- - `HIT(repaired)` 表示缓存自愈修复成功(上次 update 被跳过但 source 页面存在且 source_path 匹配)
- - 如果返回 `MISS:<reason>` → 继续执行下面的两步流程
- - `MISS:no_entry` — 首次处理此素材(正常情况)
- - `MISS:hash_changed` — 素材内容有变化,需要重新处理
- - `MISS:no_source` — 有缓存记录但 source 页面被删除了
- - `MISS:repaired_needs_verify` — 找到同名 source 页面但 source_path 不匹配,需要重新处理以确认关联正确
- 5. **Step 1:结构化分析**:
- - 输入:原始内容 + `purpose.md` + 现有 wiki 结构(至少读取 `index.md` 概要)
- - 输出:JSON 格式的分析结果,不持久化,只在当前 ingest 流程里临时传递
- - JSON 至少包含 `entities`、`topics`、`connections`
- - `confidence` 是必需字段,缺失就视为格式异常并触发单步回退
- ```json
- {
- "source_summary": "一句话概括",
- "entities": [{"name": "xxx", "type": "concept", "relevance": "high", "confidence": "EXTRACTED", "evidence": "原文摘录或推理依据"}],
- "topics": [{"name": "xxx", "importance": "high"}],
- "connections": [{"from": "A", "to": "B", "type": "因果", "confidence": "INFERRED", "evidence": "推理依据"}],
- "contradictions": [{"claim_a": "...", "claim_b": "...", "context": "..."}],
- "new_vs_existing": {"new_entities": [], "updates": []}
- }
- ```
- 置信度赋值规则(Claude 必须遵守):
- - EXTRACTED:信息直接出现在原文里,字面可以找到。**应在 `evidence` 字段提供原文摘录**(建议 ≤50 字);缺失时脚本会发出 WARN 但不阻塞
- - INFERRED:信息是从多处原文推断出来的,原文没有直接说。**应在 `evidence` 字段说明推理依据**;缺失时脚本会发出 WARN 但不阻塞
- - AMBIGUOUS:原文说法不清楚,或者有歧义。`evidence` 可选
- - UNVERIFIED:信息来自 Claude 的背景知识,原文没有证据。`evidence` 可选
- Step 1 完成后,必须执行验证:
- 1. mkdir -p {wiki_root}/.wiki-tmp
- 2. 将 Step 1 JSON 写入 {wiki_root}/.wiki-tmp/step1-latest.json
- 3. 调用 bash ${SKILL_DIR}/scripts/validate-step1.sh {wiki_root}/.wiki-tmp/step1-latest.json
- 4. 验证完成后删除 {wiki_root}/.wiki-tmp/step1-latest.json
- 如果脚本返回非 0,自动回退到单步 ingest(不进行 Step 2)。
- 6. **Step 2:页面生成**:
- - 输入:原始内容 + `purpose.md` + Step 1 的分析结果 + 现有相关 wiki 页面
- - **上下文加载规则**:只读取 Step 1 中 `new_vs_existing.updates` 列出的已有页面;如果某页超过 2000 字,只读取 frontmatter + 需要更新的章节
- - 输出:所有需要创建或更新的 wiki 页面内容
- - Step 2 负责完成原流程中的素材摘要、实体页、主题页、index、log 更新
- 7. **容错回退**:
- - 如果 Step 1 不是有效 JSON,或者缺少 `entities`、`topics`、`confidence` 等必需字段,自动回退到原来的单步流程
- - 回退时,所有本次新生成内容统一加上:
- ```markdown
- <!-- confidence: UNVERIFIED -->
- ```
- - 同时在页面顶部加注释说明本次处理因格式问题降级,避免出现“部分标注、部分没标注”的状态
- 8. **生成素材摘要页**(`wiki/sources/{日期}-{短标题}.md`):
- - 参考 `templates/source-template.md` 的格式
- - frontmatter 里保留 `sources: []` 字段;如果这次 ingest 有明确来源,按实际 raw/source 引用填入
- - 包含:基本信息、核心观点、关键概念、与其他素材的关联、原文精彩摘录
- - 对 Step 1 中标记为 `INFERRED` 或 `AMBIGUOUS` 的关系,用 HTML 注释保留置信度:
- ```markdown
- <!-- confidence: INFERRED -->
- <!-- confidence: AMBIGUOUS -->
- ```
- - **写入 source 页面时,必须使用 `create-source-page.sh`**(自动更新缓存):
- ```bash
- # 先把页面内容写到临时文件
- echo "<页面内容>" > /tmp/source-content.tmp
- # 调用脚本原子写入 + 缓存更新
- bash ${SKILL_DIR}/scripts/create-source-page.sh "<raw 文件路径>" "wiki/sources/{日期}-{短标题}.md" /tmp/source-content.tmp
- ```
- - 如果脚本返回 `SUCCESS` → 写入和缓存都已更新
- - 如果脚本返回 `ERROR` → 写入或缓存失败,检查报错信息后重试
- 9. **更新或创建实体页**(`wiki/entities/`):
- - 对每个关键概念,检查 `wiki/entities/` 下是否已有对应页面
- - 如果已有 → 追加新信息,更新"不同素材中的观点"部分
- - 如果没有 → 创建新实体页,参考 `templates/entity-template.md`
- - 使用 `[[实体名]]` 语法做双向链接
- 10. **更新或创建主题页**(`wiki/topics/`):
- - 识别素材涉及的主要研究主题
- - 如果已有对应主题页 → 更新素材汇总表和核心观点
- - 如果没有 → 创建新主题页,参考 `templates/topic-template.md`
- 11. **更新 index.md**:
- - 在对应分类下添加新条目
- - 更新概览统计数字
- 12. **更新 log.md**:
- - log.md 追加格式:`## {日期} ingest | {素材标题}`
- - 记录新增和更新的页面列表
- - 注意:缓存更新已在 Step 8 通过 `create-source-page.sh` 自动完成,此处无需再调用 `cache.sh update`
- 13. **向用户展示结果**(按 `WIKI_LANG` 切换语言):
- **中文(zh)**:
- ```
- 已消化:{素材标题}
- 新增页面:
- - {素材摘要页}
- - {新实体页1}
- - {新主题页1}
- 更新页面:
- - {已有实体页2}(追加了新信息)
- 发现关联:
- - 这篇素材和 [[已有素材]] 在 {某概念} 上有联系
- 别名建议:(仅当发现新的同义词关系时显示)
- - 建议添加到别名词表:{术语A} = {术语B}
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ### 简化处理流程(短素材 <= 1000 字)
- 适用于短推文、小红书笔记、简短评论等。
- 1. **保存原始素材**到对应 `raw/` 目录
- - **图片检测与追踪**:同完整处理流程,扫描图片引用并提醒用户;在 source 页面 `images` 和 `image_paths` frontmatter 字段记录数量和路径
- 2. **读取上下文并检查缓存**:
- - 仍然优先读取 `purpose.md`
- - 仍然先运行 `bash ${SKILL_DIR}/scripts/cache.sh check "<raw 文件路径>"`
- - 如果缓存命中(`HIT` 或 `HIT(repaired)`),直接复用已有结果
- 3. **生成简化摘要页**(`wiki/sources/`):
- - frontmatter 里写入 `sources: []`
- - 只包含基本信息和核心观点
- - 不写"原文精彩摘录"部分
- - **写入 source 页面时同样使用 `create-source-page.sh`**(自动更新缓存)
- 4. **提取 1-3 个关键概念**:
- - 如果对应实体页已存在 → 追加一句话说明
- - 如果不存在 → 在摘要页中用 `[待创建: [[概念名]]]` 标记
- 5. **更新 index.md 和 log.md**(缓存已由 `create-source-page.sh` 自动更新)
- 6. **跳过**:主题页创建/更新、overview 更新
- 7. **向用户展示简化结果**(按 `WIKI_LANG` 切换语言):
- **中文(zh)**:
- ```
- 已消化:{素材标题}(短内容,简化处理)
- 新增:
- - 素材摘要页
- 待完善:
- - [待创建: [[概念名]]](积累更多素材后整理)
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ---
- ## 工作流 3:batch-ingest(批量消化)
- 当用户给了一个文件夹路径,或者说"把这些都整理一下"。
- ### 步骤
- 1. **确认知识库路径**:
- - 执行**通用前置检查**(见上方定义),获取知识库根路径和 `WIKI_LANG`
- 2. **列出所有可处理文件**:
- - 支持的格式:`.md`, `.txt`, `.pdf`, `.html`
- - 忽略:隐藏文件、`.git` 目录、`node_modules` 等
- 3. **展示文件列表**,确认处理范围(按 `WIKI_LANG` 切换语言):
- **zh**:
- ```
- 发现 {N} 个文件待处理:
- 1. file1.pdf
- 2. file2.md
- 3. file3.txt
- 预计需要 {N} 轮处理。是否开始?
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- 4. **逐个处理**:对每个文件执行 ingest 工作流
- - 每个文件先 `cache check`
- - 命中缓存的文件直接跳过,不再进入 LLM 处理
- - 只有 `MISS` 的文件才继续执行完整或简化处理
- 5. **每 5 个文件后暂停**,展示进度并询问是否继续(按 `WIKI_LANG` 切换语言):
- **zh**:
- ```
- 进度:5/{N} 已完成
- 本批处理结果:
- - 新增素材摘要:5
- - 新增实体页:3
- - 更新已有页面:7
- 继续处理剩余 {M} 个文件?
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- 6. **全部完成后**:
- - 运行一次 index.md 全量更新
- - 输出总结报告(按 `WIKI_LANG` 切换语言):
- **zh**:
- ```
- 批量消化完成!
- 处理了 {N} 个文件:
- - 已跳过 N 个(无变化),处理 M 个(新增/更新)
- - 成功:{S}
- - 跳过(内容为空/格式不支持):{K}
- - 失败:{F}
- 新增页面:{total_new}
- 更新页面:{total_updated}
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ---
- ## 工作流 4:query(查询知识库)
- ### 步骤
- 1. **确认知识库路径**:
- - 执行**通用前置检查**(见上方定义),获取知识库根路径和 `WIKI_LANG`
- - 如果没有可用知识库,提示用户先初始化
- 2. **读取 index.md** 了解知识库全貌
- 3. **搜索相关页面**:
- - **别名展开**:先读取 `.wiki-schema.md` 中的"别名词表",如果用户的查询关键词命中了某一组别名,则将该组所有同义词都纳入搜索(如搜"LLM"时同时搜"大语言模型"和"大模型")
- - 展开规则:只在命中的那一组内展开,不跨组传递(A=B 和 B=C 是两组时,搜 A 只展开第一组,不合并第二组)
- - 去重:展开后的关键词列表自动去重,忽略空项和纯空格项
- - 在 index.md 中定位相关分类和条目(用展开后的全部关键词)
- - 再用 Grep 在 `wiki/` 目录下搜索所有关键词(原始 + 别名展开)
- - 按相关性排序:文件名精确命中 > index.md 条目命中 > 正文关键词命中次数(同一别名组的多个词命中同一页面时只计一次,避免别名密集的页面分数虚高)
- - **段落上限**:展开后每个关键词最多取 3 个命中段落,总段落数不超过 15 个
- - 读取最相关的 3-5 个页面
- - **单页长度上限**:如果某页超过 2000 字,只读取 frontmatter + 前 500 字 + Grep 命中段落(前后各 3 行),避免长页面消耗过多上下文
- 4. **综合回答**:
- - 按 `WIKI_LANG` 用对应语言回答用户的问题
- - 标注信息来源(引用 wiki 页面,用 `[[页面名]]` 格式)
- - 如果多个素材有不同观点,分别列出并标注来源
- 5. **判断是否值得持久化**:
- - 如果回答引用了 3 个及以上来源的综合分析,提示用户:"是否保存此回答到知识库?"
- - 少于 3 个来源时,默认只做即时回答,不主动建议持久化
- 6. **重复检测**:
- - 持久化前,先在 `wiki/queries/` 下搜索同主题页面
- - 通过 frontmatter tags 和 title 匹配,判断是否已有同主题 query 页面
- - 如果已有,提示用户是“更新现有页面”还是“新建一页”
- - 如果用户选择更新旧页面,旧版页面增加 `superseded-by` 标记
- 7. **保存 query 页面**:
- - 用 `templates/query-template.md` 生成页面
- - 保存路径使用 `wiki/queries/{date}-{short-hash}.md`,避免同主题命名冲突
- - frontmatter 必须包含 `type: query` 和 `derived: true`
- - `derived: true` 表示这是衍生内容,不是一手素材
- 8. **自引用防护**:
- - query 页面在后续 ingest 分析里视为二级来源,不作为主要知识来源
- - 如果后续页面引用 query 页面里的信息,相关关系统一按 `INFERRED` 处理
- - ingest 不主动扫描 `wiki/queries/`;只有当前问题确实需要时,才把 query 页面作为补充材料读取
- 9. **更新索引和日志**:
- - 保存成功后,在 index.md 中加入 query 条目
- - 同时在 log.md 中追加一条 query 保存记录
- ---
- ## 工作流 5:lint(健康检查)
- ### 触发时机
- - 用户主动说"检查知识库"
- - 每次 ingest 后,如果素材总数是 10 的倍数,主动建议运行 lint
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。如果没有可用知识库,提示用户先初始化。
- 1. **确定检查范围**:
- - 最近更新的 10 个页面(按文件修改时间排序)
- - 随机抽查的 10 个页面(避免遗漏旧页面的问题)
- - 如果页面总数 <= 20,检查全部
- 2. **Step 0:调用脚本做机械检查**(必须先做,不要跳过):
- ```bash
- bash ${SKILL_DIR}/scripts/lint-runner.sh <wiki_root>
- ```
- 脚本一次读取后统一检查孤立页、index、图片、来源信息和全部 wikilink。明确路径和唯一裸名会按实际页面路径解析;同名页面不会被合并。歧义链接不猜目标、不计入关系,并列出全部候选;“待创建”和真正断链分开报告,代码示例不会被当成链接。
- 普通检查只读并完整报告数据问题,退出码为 `0`;路径、参数、解析或读取失败返回 `1`。需要让 CI 因歧义、真正断链或路径冲突而阻断时,显式运行:
- ```bash
- bash ${SKILL_DIR}/scripts/lint-runner.sh <wiki_root> --strict
- ```
- 严格模式完成报告后,有 `error` 返回 `2`,只有“待创建”等提示仍返回 `0`。可在末尾加 `--json` 获取同一份结构化完整报告。所有这些检查都不会修改知识库 Markdown。
- 3. **逐项检查**(AI 判断类,脚本做不了):
- **矛盾信息**(阅读相关页面,检查是否有互相矛盾的说法):
- - 列出发现的矛盾
- - 标注每处矛盾的来源页面
- **交叉引用缺失**(检查相关主题的页面之间是否应该互相链接但没链):
- - 建议添加的交叉引用
- **置信度报告**(统计 `EXTRACTED` / `INFERRED` / `AMBIGUOUS` / `UNVERIFIED`):
- - 高亮 `AMBIGUOUS` 条目,提醒用户优先验证
- - 抽查标注为 EXTRACTED 的条目,检查是否能在原始素材里找到对应原文
- - 如果发现 EXTRACTED 无法回溯到原文,提示用户回退为更低置信度或重新整理
- **补充建议**:基于 Step 0 脚本的孤立页/断链输出,给出修复建议(脚本只列问题,不给方案)
- - 孤立页面 → 建议从哪些相关页面添加 `[[链接]]`
- - 断链 → 建议为哪些概念创建新页面,或改写引用为已有页面
- 4. **输出报告**(按 `WIKI_LANG` 切换语言,整合 Step 0 脚本输出 + Step 3 AI 判断结果):
- **zh**:
- ```
- 知识库健康检查报告
- 检查范围:最近更新 10 页 + 随机抽查 10 页(共 {N} 页)
- 孤立页面(没有其他页面链接到它):
- - [[某页面]] → 建议从 [[相关页面]] 添加链接
- 断链(被链接但不存在):
- - [[某概念]] → 建议创建新页面
- 矛盾信息:
- - 关于"XX",[[页面A]] 说是 Y,但 [[页面B]] 说是 Z
- 缺失索引:
- - {文件名} 存在但未记录在 index.md 中
- 置信度报告:
- - EXTRACTED:{N}
- - INFERRED:{N}
- - AMBIGUOUS:{N}
- - UNVERIFIED:{N}
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- 5. **询问用户**:要自动修复哪些问题?(按 `WIKI_LANG` 用对应语言提问)
- ---
- ## 工作流 6:status(查看状态)
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。如果没有可用知识库,提示用户先初始化。
- ### 步骤
- 1. 先运行 `bash ${SKILL_DIR}/scripts/source-registry.sh list` 读取来源总表
- 2. 获取知识库路径(按上面的 CWD 检查逻辑)
- 3. 统计:
- - 按来源总表中的 `source_label` 和 `raw_dir` 逐项统计 `raw/` 文件数
- - `wiki/entities/` 下的页面数
- - `wiki/topics/` 下的页面数
- - `wiki/sources/` 下的页面数
- - `wiki/comparisons/` 和 `wiki/synthesis/` 下的页面数
- - `purpose.md 是否存在`
- 4. 读取 `log.md` 最后 5 条记录
- 5. 读取 `index.md` 获取主题概览
- 6. 运行 `bash ${SKILL_DIR}/scripts/adapter-state.sh summary-human` 获取外挂状态
- 7. 运行 `node ${SKILL_DIR}/scripts/source-signal-coverage.js <wiki_root>` 获取来源信号覆盖数据,从返回 JSON 的 `summary` 中读取:
- - `ok`(已参与)、`missing_sources`(缺少 sources)、`empty_sources`(sources 为空)、`invalid_sources`(格式无效)、`not_applicable`(当前不参与)
- 8. **输出报告**(按 `WIKI_LANG` 切换语言):
- **zh**:
- ```
- 知识库状态:{主题}
- 素材分布(按来源总表):
- - {source_label}:{N}
- - {source_label}:{N}
- ...
- Wiki 页面:{总数} 页
- - 实体页:{N}
- - 主题页:{N}
- - 素材摘要:{N}
- - 对比分析:{N}
- - 综合分析:{N}
- 图谱来源信号覆盖:
- - 已参与:{ok}
- - 缺少 sources:{missing_sources}
- - sources 为空:{empty_sources}
- - 格式无效:{invalid_sources}
- - 当前不参与:{not_applicable}
- 研究方向:
- - purpose.md 是否存在:{是/否}
- 最近活动:
- - {日期} ingest | {素材标题}
- - {日期} ingest | {素材标题}
- ...
- 外挂状态:
- {summary-human 原文}
- 建议:
- - 你可能想深入了解 {某主题},已有 {N} 篇相关素材
- - {某实体} 被 {N} 篇素材提到,值得整理成独立页面
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- 外挂状态直接使用 `bash ${SKILL_DIR}/scripts/adapter-state.sh summary-human` 的输出,不要自己再重写一套来源清单。
- ---
- ## 工作流 7:digest(深度综合报告)
- **区别于 query**:query 是快速问答,不生成新页面;digest 是跨素材深度综合,生成持久化报告。
- ### 触发关键词
- - 默认深度报告格式:`"给我讲讲 XX"、"深度分析 XX"、"综述 XX"、"digest XX"、"全面总结一下 XX"`
- - 对比表格式:`"对比一下 X 和 Y"、"比较 X 和 Y"、"X 和 Y 有什么区别"`
- - 时间线格式:`"整理一下时间线"、"按时间排列"、"时间顺序"`
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。如果没有可用知识库,提示用户先初始化。
- 1. **搜索相关页面**:
- - **别名展开**:同 query 工作流,先读取 `.wiki-schema.md` 中的"别名词表"展开同义词(不跨组传递,自动去重)
- - 用 Grep 在 `wiki/` 下搜索所有关键词(原始 + 别名展开),同一别名组命中同一页面只计一次
- - 列出将要综合的页面(让用户了解报告覆盖范围)
- 2. **深度阅读所有相关页面 + 选择输出格式**:
- - 读取找到的所有相关 wiki 页面(sources/、entities/、topics/)
- - **单页长度上限**:如果某页超过 3000 字,优先读取 frontmatter + 核心观点章节 + 与主题直接相关的段落,跳过"原文精彩摘录"等冗长引用部分
- - 归纳每个页面的核心观点和来源信息
- - **根据触发关键词决定输出格式**:
- - 用户说"对比"/"比较"类 → 使用**对比表格式**(见下方模板 B)
- - 用户说"时间线"/"按时间"类 → 使用**时间线格式**(见下方模板 C)
- - 其他默认 → 使用**深度报告格式**(见下方模板 A)
- 3. **生成结构化深度报告**,保存到 `wiki/synthesis/{主题}-{格式}.md`(按 `WIKI_LANG` 切换语言):
- > 文件名规则:默认格式用 `{主题}-深度报告.md`,对比表用 `{主题}-对比.md`,时间线用 `{主题}-时间线.md`
- **模板 A:深度报告格式(默认)**
- **zh**:
- ```markdown
- # {主题} 深度报告
- > 综合自 {N} 篇素材 | 生成日期:{日期}
- ## 背景概述
- (简要说明这个主题的背景和重要性)
- ## 核心观点
- (按重要性排列,每个观点标注来源)
- - 观点一(来源:[[素材A]]、[[素材B]])
- - 观点二(来源:[[素材C]])
- ## 不同视角对比
- (如有多个素材观点不同,在此对比)
- | 维度 | 来源A的观点 | 来源B的观点 |
- |------|------------|------------|
- ## 知识脉络
- (按时间或逻辑顺序梳理该主题的发展)
- ## 尚待解决的问题
- (现有素材中尚未回答的问题,可作为下次搜集素材的方向)
- ## 相关页面
- (列出所有综合来源的链接)
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- **模板 B:对比表格式**(触发词:对比 / 比较)
- ```markdown
- # {对比主题} 对比分析
- > 对比 {N} 个对象 | 生成日期:{日期}
- ## 对比对象
- - [[对象 A]]
- - [[对象 B]]
- - [[对象 C]](如有)
- ## 对比表
- | 维度 | [[对象 A]] | [[对象 B]] | [[对象 C]] |
- |-----------|-----------|-----------|-----------|
- | 核心观点 | ... | ... | ... |
- | 适用场景 | ... | ... | ... |
- | 优点 | ... | ... | ... |
- | 缺点 / 限制 | ... | ... | ... |
- | 来源素材 | [[素材1]] | [[素材2]] | [[素材3]] |
- ## 关键差异
- (用 1-2 句话说清最重要的差异点)
- ## 相关页面
- ```
- **模板 C:时间线格式**(触发词:时间线 / 按时间)
- ```markdown
- # {主题} 时间线
- > 时间跨度:{起始年} ~ {结束年} | 生成日期:{日期}
- ```mermaid
- gantt
- title {主题} 时间线
- dateFormat YYYY-MM-DD
- section 主要事件
- 事件 A : 2023-01-01, 1d
- 事件 B : 2024-03-15, 1d
- 事件 C : 2025-06-20, 1d
- ```
- ## 事件说明
- - **2023-01-01 — 事件 A**:简要说明(来源:[[素材A]])
- - **2024-03-15 — 事件 B**:简要说明(来源:[[素材B]])
- - **2025-06-20 — 事件 C**:简要说明(来源:[[素材C]])
- ## 相关页面
- ```
- > **时间线格式注意事项**:
- > - `gantt` 要求 `YYYY-MM-DD` 精度
- > - 如果素材只有年份(如 "2023 年"),把日期补为该年第一天(`2023-01-01`)
- > - 如果连年份都不确定,改用**纯文字时间线**(无序列表按时间排序),不用 Mermaid gantt
- > - 如果事件超过 15 个,建议按 section 分组,避免图太长
- 4. **更新 index.md 和 log.md**:
- - index.md 的"综合分析"分类下添加新报告条目
- - log.md 追加:`## {日期} digest | {主题}`
- 5. **向用户展示结果**(按 `WIKI_LANG` 切换语言):
- **zh**:
- ```
- 已生成深度报告:{主题}
- 综合了 {N} 篇素材:
- - [[素材1]]、[[素材2]]...
- 报告已保存:wiki/synthesis/{主题}-深度报告.md
- 发现这些待解决问题,可以继续搜集素材:
- - {问题1}
- - {问题2}
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ---
- ## 工作流 8:graph(知识图谱 · Mermaid + 交互式 HTML)
- ### 触发关键词
- "画个知识图谱"、"看看关联图"、"graph"、"知识库地图"、"展示知识关联"
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。如果没有可用知识库,提示用户先初始化。
- 1. **扫描双向链接**:
- - 遍历 `wiki/` 下所有 `.md` 文件
- - 提取每个文件中的 `[[链接]]` 语法,建立关系列表:`页面A → 页面B`
- 2. **生成 Mermaid 图表文件** `wiki/knowledge-graph.md`:
- ````markdown
- # 知识图谱
- > 自动生成 | {日期} | 共 {N} 个节点,{M} 条关联
- ```mermaid
- graph LR
- A[概念1] --> B[概念2]
- A --> C[素材1]
- D[主题1] --> A
- D --> E[概念3]
- ```
- 查看方式:用 Typora、VS Code(Markdown Preview Enhanced)、或直接在 GitHub 上查看。
- ````
- **生成规则**:
- - 节点名用中括号 `[名称]`,名称太长则截断到 10 字
- - 只展示有双向链接关系的节点(孤立节点不纳入图谱)
- - 如果关系超过 50 条,只保留被引用次数最多的 30 个节点,避免图谱过于密集
- - **默认全部使用 `A --> B` 无标注箭头**,不自动判断关系类型
- **可选:手动美化图谱**(生成后由用户自己做,AI 不自动处理):
- 生成的 `wiki/knowledge-graph.md` 默认只有 `-->` 箭头。如果用户希望图谱更清楚地
- 表达关系类型,可以:
- 1. 用编辑器打开 `wiki/knowledge-graph.md`
- 2. 参考 `.wiki-schema.md` 里的"关系类型词汇表"(实现 / 依赖 / 对比 / 矛盾 / 衍生)
- 3. 把最重要的 3-5 条箭头改写成 `A -->|实现| B` 之类的带标注写法
- 4. 保存后用 Obsidian / VS Code / Typora 重新渲染
- AI 在 graph 工作流里**不自动打标**——因为自动判断关系类型需要额外阅读整段上下文,
- 成本高且准确率难保证。人类对"哪些关系最值得打标"的判断更可靠。
- 用户如果明确要求 AI 给某几条边打标,可以单独说"把 A 和 B 之间的关系标成'实现'",
- AI 再手动修改 `wiki/knowledge-graph.md` 对应的那一行。
- 2b. **生成交互式图谱数据**(`wiki/graph-data.json`):
- ```bash
- bash scripts/build-graph-data.sh "$WIKI_ROOT"
- ```
- 脚本会递归扫描 `wiki/{entities,topics,sources,comparisons,synthesis,queries}/**/*.md`,
- 解析 wikilink 与 `<!-- confidence: EXTRACTED|INFERRED|AMBIGUOUS -->` 注释,
- 调用本地 Node helper 计算 3 信号边权重(共引强度 / 来源重叠 / 类型亲和度)、Louvain 社区和规则 insights,
- 并把 `wiki/graph-data.json` 与同目录唯一的 `wiki/graph-warnings.json` 成对写入(内容 >2MB 自动降级,单节点只留 500 行;图规模超预算时 insights 自动降级)。节点身份使用实际知识库相对路径,因此六类正式目录中的同名页面都会保留。明确路径和唯一裸名正常建边;歧义链接不建边并报告候选;“待创建”和真正断链分别报告。
- 正常构建即使发现数据问题也返回 `0`,只有工具、输入或写入失败返回 `1`,并且绝不修改 Markdown。CI 要阻断数据错误时,另运行 `node scripts/wiki-link-cli.js check "$WIKI_ROOT" --strict`;严格检查有 `error` 返回 `2`。自定义输出必须仍在知识库内、文件名保持 `graph-data.json`,并使用自己的目录;该目录中的 `graph-warnings.json` 是它唯一的配对详情文件,两个自定义输出要放在两个不同目录。
- 依赖 `jq` + `node`(如缺失可运行 `brew install jq node`)。
- 2c. **图谱运行时说明**:
- - 图谱基础构建现在依赖 `jq` + `node`
- - 不需要额外 `npm install`
- - `node` 只用于运行随仓库分发的本地预构建 helper
- 2d. **生成交互式图谱 HTML**(东方编辑部 × 数字山水风):
- ```bash
- bash scripts/build-graph-html.sh "$WIKI_ROOT"
- ```
- 生成 `wiki/knowledge-graph.html`。脚本会先验证成对告警,再安全内嵌图谱和最多 2 MiB(gzip level 9)的告警详情,离线双击即可打开。详情超过上限时会稳定精简并保留全部总数;详情缺失或与图谱不是同一代时仍显示图谱,并提示重新构建。
- 页面保持三栏国风布局:左侧文献索引,中间数字山水图谱,右侧常驻节点详情。
- 包含搜索、社区筛选、节点视觉分层、首屏推荐预览、摘要、正文、相邻节点、洞察、小地图和关系置信度图例。
- 离线页只负责解释告警,不提供改名、解决或其他写入操作。
- 3. **读取 insights 并向用户展示结果**(按 `WIKI_LANG` 切换语言):
- 先读取 insights:
- ```bash
- jq '.insights' "$WIKI_ROOT/wiki/graph-data.json"
- ```
- **zh**:
- ```
- 知识图谱已生成!
- 共 {N} 个节点,{M} 条关联
- 图谱洞察:
- - 惊人连接:{from} ↔ {to}(跨社区,权重 {weight}){如有}
- - 桥节点:{node}(连接 {count} 个社区){如有}
- - 知识缺口:{node}(度数 {degree},建议补充素材){如有}
- - 稀疏社区:{community}(密度 {density}){如有}
- 查看方式:
- - 交互式(推荐):双击 wiki/knowledge-graph.html
- (建议 Chrome / Firefox;Safari 若提示"已阻止脚本",
- 可在 wiki/ 下跑 `python3 -m http.server 8000` 再访问)
- - Mermaid 静态图:wiki/knowledge-graph.md
- (Obsidian / VS Code Markdown Preview Enhanced / GitHub / Typora 均可渲染)
- 孤立页面(未纳入图谱):
- - [[某页面]](建议添加到相关实体页或主题页)
- ```
- (英文版按「输出语言规则」生成,结构相同。各洞察类别为空时省略该行。)
- ---
- ## 工作流 9:delete(删除素材)
- ### 触发关键词
- "删除素材"、"remove"、"delete source"、"移除"
- ### 前置检查
- 执行**通用前置检查**(见上方定义)。如果没有可用知识库,提示用户先初始化。
- ### 步骤
- 1. **识别目标素材**:
- - 在 `raw/` 下搜索用户提到的素材名
- - 如果匹配到多个候选,先列出候选文件让用户确认
- 2. **扫描影响范围**:
- - 先运行:
- ```bash
- bash ${SKILL_DIR}/scripts/delete-helper.sh scan-refs "<wiki 根目录>" "<素材文件名>"
- ```
- - 用脚本返回的页面列表作为引用扫描结果
- - 逐页判断是“删除整页”还是“保留页面但移除该素材引用”
- 3. **安全确认**:
- - 如果影响超过 5 个页面时,先把受影响页面完整列给用户,再做二次确认
- - 如果某个实体或主题只被这个素材引用,提示用户是否连同页面一起删除
- 4. **执行级联清理**:
- - 删除 `raw/` 下对应原始文件
- - 删除 `wiki/sources/` 下对应素材摘要页
- - 对 `wiki/entities/`、`wiki/topics/`、`wiki/comparisons/`、`wiki/synthesis/` 中仍需保留的页面,只移除该素材相关的引用段落
- - 更新 `index.md`
- - 在 `log.md` 追加删除记录
- - 标记 `wiki/overview.md` 需要重新生成
- 5. **清理缓存**:
- - 删除完成后,对对应 raw 文件运行:
- ```bash
- bash ${SKILL_DIR}/scripts/cache.sh invalidate "<raw 文件路径>"
- ```
- 6. **断链检查**:
- - 用 grep 或 `delete-helper.sh` 再扫一遍指向已删除页面的链接
- - 清理明确可判定的断链;如果归属不清,保留原文并提示用户后续人工确认
- 7. **向用户报告结果**:
- **zh**:
- ```
- 已删除:
- - raw/articles/2024-01-15-ai-article.md
- - wiki/sources/2024-01-15-ai-article.md
- 已更新(移除引用):
- - wiki/entities/AI-Agent.md
- - wiki/topics/大语言模型.md
- 需要重新生成:
- - wiki/overview.md
- ```
- (英文版按「输出语言规则」生成,结构相同。)
- ---
- ## 工作流 10:crystallize(结晶化)
- **触发条件**:
- 用户说"结晶化"、"crystallize"、"把这个记进知识库"、"这段对话很有价值"
- **输入**:
- 用户主动提供的内容(文字粘贴进对话,或明确引用某段上下文)。
- 用户必须主动提供内容,Claude 不自动提取当前会话。
- **处理步骤(MVP)**:
- 1. 用户提供内容(文字粘贴进对话)
- 2. Claude 从内容中提取:
- - 核心洞见(3-5 条)
- - 关键决策和原因
- - 值得记录的结论
- 3. 生成 `wiki/synthesis/sessions/{主题}-{日期}.md`,格式参考 `templates/synthesis-template.md`
- - 本轮不要求 crystallize 页面补 `sources`,默认不参与 graph source overlap
- 4. 更新 `log.md`(记录本次结晶化操作)
- > MVP 版本不自动创建 entity 页面,不自动更新 index.md。
- **confidence 规则**:
- 结晶化来源的内容默认标记为 `INFERRED`(来自推断/对话,非原始文档)。
- **输出示例**:
- 已创建 wiki/synthesis/sessions/AI-agent-设计决策-20260413.md
- 已更新 log.md
README.md · README · 336 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
This file has changed since it was scanned, so this is not exactly the text that was scanned, and no line is marked. The findings are listed with the safety scan above.
- [English](README.en.md) | 中文
- <div align="center">
- # llm-wiki
- 基于 [Andrej Karpathy](https://karpathy.ai/) 的 [llm-wiki 方法论](https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f)
- **更适合国内宝宝体质的 K 神知识库**
- 把碎片化的信息变成持续积累、互相链接的知识库
- [](https://github.com/sdyckjq-lab/llm-wiki-skill/releases)
- [](LICENSE)
- []
- </div>
- ---
- ## 效果预览
- <div align="center">
- <img src="assets/graph-demo.gif?v=20260428" width="100%" alt="知识图谱演示">
- </div>
- 东方编辑部 × 数字山水风交互式知识图谱 — 双击 HTML 文件即可在浏览器中探索。搜索、社区图例、聚焦筛选、节点视觉分层、社区轻量地图、统一社区抽屉、悬停预览、轻量摘要、明确进入阅读、Shift 多选、画布缩放拖拽和小地图定位,全部离线运行,不依赖服务器。
- ---
- ## 两种入口
- 本仓库是 llm-wiki 的 monorepo,包含两种使用形态,读写同一份知识库格式:
- - **Skill 形态**(成熟稳定):把仓库链接丢给 Claude Code / Codex / OpenClaw / Hermes 一键安装,在你的 AI CLI 里维护知识库。
- - **agent 工作台**(`workbench/`,开发中):本地运行的知识库工作台,以对话为中心、内置交互式数字山水知识图谱。当前面向开发者(`npm run dev`),成熟后提供桌面应用。
- 交互式图谱引擎(`packages/graph-engine/`)由两种形态共享:Skill 的离线 HTML 和工作台的图谱视图,是同一个引擎的两个出口。
- **隐私边界**:知识库文件和离线图谱产物保存在本机;当你让 agent 回答、消化或生成内容时,prompt、选中的引用、检索片段、工具输出和生成产物可能会发送给你配置的模型提供商。API key 不写入 llm-wiki 自己的配置;第三方 Skill 只有显式安装并启用后才作为受信任本地代码运行。
- ---
- ## 30 秒上手
- 把仓库链接扔给你正在用的 agent,让它自己完成安装。
- ```bash
- # Claude Code
- bash install.sh --platform claude
- # Codex
- bash install.sh --platform codex
- # OpenClaw
- bash install.sh --platform openclaw
- # Hermes
- bash install.sh --platform hermes
- ```
- 然后说:
- > "帮我初始化一个知识库"
- > "帮我消化这篇:<链接>"
- 核心区别:知识被**编译一次,持续维护**,而不是每次查询都从原始文档重新推导。
- ---
- ## 核心亮点
- ### Skill 稳定主线
- | | 功能 | 说明 |
- |---|---|---|
- | 🗺️ | **数字山水知识图谱** | 自包含 HTML,双击即可浏览;三栏国风布局、山水底图、可拖拽缩放画布、小地图定位和左右阅读区全部离线运行 |
- | ✨ | **图谱阅读体验打磨** | 节点按地名、索引签条、朱砂批注分层;默认画面更轻,悬停可预览,点击先看摘要,再通过明确动作进入阅读 |
- | 🎓 | **本地阅读动线** | 社区图例、聚焦筛选、图谱搜索、右侧摘要/阅读抽屉和选区抽屉保持联动;社区阅读内搜索和类型筛选只作用于当前社区 |
- | 📦 | **零配置初始化** | 一句话创建完整知识库,自动生成目录结构、模板和研究方向页 |
- | 🔗 | **结构化 Wiki** | 自动生成实体页、主题页、素材摘要,用 `[[双向链接]]` 互相关联 |
- | 🏷️ | **置信度标注** | EXTRACTED / INFERRED / AMBIGUOUS / UNVERIFIED,一眼看出哪些需要核实 |
- | 🔄 | **智能缓存** | SHA256 去重 + 写入即更新 + 自愈安全网,弱模型也不会漏缓存 |
- | 🧠 | **对话结晶** | 把有价值的对话内容直接沉淀为知识库页面 |
- | 📡 | **自动上下文注入** | SessionStart hook 让 agent 每次会话自动感知知识库 |
- | 📊 | **多格式分析** | 深度报告、对比表、时间线三种综合分析格式 |
- ### 工作台开发预览
- | | 功能 | 说明 |
- |---|---|---|
- | 🧮 | **共享绘制策略** | 密度、节点显示、标签与关系预算、稳定骨架和社区层级由一份规则产出;旧工具箱与早期 wash 模板已退休,Sigma 主路线与 DOM/SVG 故障回退使用同一份准备结果,每次更新只计算一次 |
- | 🧯 | **图谱故障恢复** | 共享结果失败时,工作台和离线图谱都会清掉旧内容并显示明确提示;只有 Sigma 自身故障才进入 DOM/SVG 回退,不会留下可操作的半成品 |
- | ⚠️ | **图谱身份与告警** | 同名页面按知识库内相对路径分别保留;歧义、断链、待创建和路径冲突会集中提示,图谱仍可阅读,详情只读并按页加载;无效详情也不会把本机绝对路径带入离线文件;只有迁移提示的刷新不会卡在待播放状态 |
- | 📝 | **图谱安全改名与恢复** | 可从可处理的告警或页面阅读区选择同目录安全改名;提交前查看完整影响并确认全部歧义,外部编辑、意外中断或图谱更新失败后都有明确恢复和重试入口,排队中的图谱更新完成后会自动显示最终结果 |
- | 🗺️ | **图谱位置与视野连续** | 初始布局、Pin 和实时拖动共同维护同一张地图;远端节点仍在完整内容范围内,社区取景、缩放、平移、重置、窗口变化和小地图保持一致 |
- | 🧭 | **社区近景地图** | 进入社区后像从全局图靠近刚才那片区域;节点位置、层级和标签更稳定,社区内可多选节点并带入对话,返回全图时高亮会跟随视野稳定后再淡出 |
- | 🧩 | **全局意图反馈** | 全局图谱悬停节点可轻量看一阶关系,单击节点固定关系强调并打开摘要;选中社区只预览少量内部结构和跨社区通道,不直接变成完整社区阅读 |
- | 🖱️ | **图谱全区域缩放** | 在桌面上,鼠标停在节点、社区色块、关系或空白处时,滚轮和触摸板都只缩放图谱,不会误缩放浏览器;地图内控件和图谱外页面保持各自应有的行为 |
- | 🪶 | **图谱增强显示** | 工作台图谱默认已分清主次;需要时可打开语义强调和聚焦点亮,让关键关系更容易看清 |
- | 🎨 | **工作台 Paper 视觉** | 工作台沿用暖纸配色,按钮、消息、侧栏和图谱控件保持统一,长标题不会撑开页面 |
- | 💬 | **工作台对话自动跟随** | 发送和流式回复时自动停在最新内容,用户上翻时暂停,并用向下箭头一键回到底部 |
- | 🧰 | **工作台动态工具状态** | agent 执行工具时显示当前动作;完成后折叠成摘要,避免主对话被工具流水账刷屏 |
- | 🛡️ | **工作台安全流式状态** | prompt、工具状态、产物和终态使用统一流式契约;检索内容只进入发起它的运行和对话,切换、取消或重复发送不会串用旧内容;模型失败不会显示为完成,图谱断线后会重新取得当前错误或当前图谱,异常流会安全结束并恢复操作 |
- | / | **工作台检索日志隐私** | 默认检索日志只保留排障所需的会话、知识库、触发状态、结果信息和稳定失败状态,不保存用户提问或可恢复的派生内容 |
- | 🔒 | **工作台本地访问保护** | 本地配置、对话、页面、图谱事件、文件和状态操作都只对同时通过来源与启动凭证检查的工作台开放 |
- | 🧷 | **工作台请求边界** | 前台只会发送已登记的请求方式与入口组合;产出物清单和下载统一拒绝不合规编号,文件下载和事件流保持各自独立处理 |
- | / | **工作台命令清单** | 对话里的 `/` 菜单和设置里的能力统计使用同一套受保护读取;列表不会显示本机能力路径 |
- | 🔑 | **工作台认证设置** | 保存 API key 和测试连接使用同一套保护与提示;失败不会暴露本机信息、密钥或底层错误 |
- | 📚 | **工作台知识库创建** | 侧栏可以分别在默认目录新建知识库或添加已有目录;初始化已有目录和批量消化保持独立,取消、重复名称、同名请求正在处理和异常不会暴露本机路径或内部信息 |
- | ✅ | **工作台可靠启动** | 后台只监听本机,失败启动不会替换现有凭证,重启会换新并恢复上次知识库;退出时会有序结束持续连接和图谱重建进程,必要时再启用兜底清理 |
- | 🧪 | **工作台真实浏览器检查** | 自动启动真实前台和后台,检查知识库、对话、页面、图谱、消息、产出物、设置与模型的主要流程,以及隔离、取消、断线和失败恢复;线上准备、正式检查、清理和诊断各有明确时限,冷启动不会静默挤掉正式检查;Paper 视觉检查会从页面搜索进入右侧阅读区并确认正文已经显示,也会实际读取产出物、设置和模型,旧结果形状会被明确拒绝;平板打开阅读区时输入区仍保持可用,文字和发送按钮不会重叠 |
- | 🔎 | **工作台统一质量检查** | 本机与 GitHub 使用同一入口,顺序检查公开内容隐私、前后台、共享规则、图谱、边界、类型、规范和构建,并在隔离环境验证启动与入口反例;图谱交互结束按实际视图提交时点确认,不会因短暂繁忙被提前判定完成 |
- ---
- ## 素材来源
- | 分类 | 来源 | 处理方式 |
- |---|---|---|
- | 核心 | PDF、Markdown、文本、HTML、纯文本粘贴 | 直接消化,不依赖外挂 |
- | 可选 | 网页文章、X/Twitter、微信公众号、YouTube、知乎 | 自动提取;失败时按回退提示改走手动 |
- | 手动 | 小红书 | 当前只支持手动粘贴 |
- 可选提取器需要在安装时显式开启:
- ```bash
- bash install.sh --platform claude --with-optional-adapters
- ```
- ---
- ## 平台入口
- 每个平台有专属入口说明:
- - [Claude Code](platforms/claude/CLAUDE.md)
- - [Codex](platforms/codex/AGENTS.md)
- - [OpenClaw](platforms/openclaw/README.md)
- - [Hermes](platforms/hermes/README.md)
- ---
- <details>
- <summary><strong>完整功能列表</strong></summary>
- - **研究方向引导** — `purpose.md` 让 agent 在整理和查询时有明确方向
- - **两步式整理** — 先分析后生成,长内容走两步链式思考,短内容简化处理
- - **ingest 格式验证** — 脚本自动校验分析结果,模型再笨也不会写出残缺数据
- - **智能素材路由** — 根据 URL 域名自动选择最佳提取方式
- - **核心优先安装** — 默认只准备知识库主线,网页/X/公众号/YouTube/知乎按需显式开启
- - **伴随升级命令** — Claude Code 安装后自带 `/llm-wiki-upgrade`
- - **素材删除** — 级联删除时自动清理关联页面、断链和缓存
- - **图谱坏数据安全兼容** — 未知、残缺或畸形图谱会先整理成可安全使用的结果,节点、关系、社区和起点再由同一份稳定模型交给绘制;重复编号稳定保留第一项并明确提示,自动编号避开已有值,常规搜索仍对应正确页面
- - **图谱路径身份与告警** — 同名页面按知识库内相对路径分别进入图谱;歧义链接不猜目标,重复编号、断链、待创建、不规范路径和可移植冲突集中显示;告警详情只读、按页读取,首次刷新和 Pin 继续对应正确页面
- - **图谱安全改名与恢复** — 从可处理的告警或页面阅读区发起可选的同目录改名;完整预览会列出自动更新、只读引用、固定位置和全部歧义,确认后才写入;外部编辑、崩溃和图谱待更新状态可恢复或单独重试,排队中的更新完成后会自动显示最终结果
- - **图谱搜索与筛选更稳** — 工作台、离线图谱和两种显示路线使用同一份结果;常规搜索保留原有 500 字符范围,Atlas 全文搜索继续覆盖完整正文,类型筛选、社区聚焦和临时显示的节点与关系保持一致;中文、组合字符和 emoji 长标题在旧浏览器环境下也能安全省略并保留完整标题
- - **图谱共享绘制策略** — 密度、节点显示、标签与关系预算、稳定骨架、社区层级和标签方向由同一份规则产出;模型、布局、可见结果和绘制规则在一次更新中各计算一次,旧工具箱与早期 wash 模板已退休,Sigma 主路线与 DOM/SVG 故障回退使用同一份准备结果,工作台和离线图谱保持一致
- - **图谱故障恢复** — 工作台首次打开或更新失败时会清空旧图、选择、筛选、Pin 和失败实例;离线创建失败会显示恢复提示并撤掉半成品,存储不可用时仍可阅读,社区选区可继续进入近景阅读;只有共享结果成功后的 Sigma 专属故障才进入 DOM/SVG 回退
- - **Sigma 图谱主路线** — 全局视角和社区阅读都以 Sigma/Graphology 承接;DOM/SVG 只保留为回退、对照和异常兜底,不再作为社区阅读主路径扩展
- - **Sigma 迁移前性能基线** — 生产 1k 与隔离 1k/5k/10k 图谱都连续测量三次悬停预览并保存中位数;后续迁移使用固定公式自动比较,其他渲染试验不承担 Sigma 专属门禁
- - **图谱全区域缩放** — 在桌面上,鼠标停在节点、社区色块、关系或空白处时,滚轮和触摸板都只缩放图谱,不会误缩放浏览器;地图内控件和图谱外页面保持各自应有的行为
- - **统一社区抽屉** — 普通社区和"未分组"使用同一套概览、固定动作、可展开核心节点和对话入口;"进入社区"放在顶部,未分组默认推荐探索潜在关系
- - **图谱增强显示** — 工作台图谱默认已分清主次;增强显示面板支持语义强调和聚焦点亮,社区图谱保留原有关系显示和图例
- - **全局图谱意图反馈** — 在全局视图悬停节点会轻量点亮一阶真实关系,移开恢复且不打开抽屉、不移动镜头;单击节点固定关系强调并打开摘要;选中社区只露出少量内部结构和跨社区桥接上下文,不进入完整社区阅读
- - **图谱位置与视野连续** — 初始布局不再污染节点内容,实时拖动位置优先于 Pin 和初始位置;类型筛选、临时显示与远端其他社区节点共同决定完整内容范围,社区取景继续按窗口比例扩展,缩放、平移、重置、窗口变化和小地图结果保持一致
- - **社区近景地图** — 进入社区是一段连续过渡:摘要抽屉退场、画布平滑扩展,镜头从全局社区高亮近景继续推进到社区阅读近景,过渡后落在 Sigma 社区阅读主路径且不重开摘要(减少动态效果下抽屉直接关闭、不做大幅推进);进入社区后沿用 Sigma 主图,只显示当前社区内部节点和关系;节点位置、身份色、边层级和标签预算保持连续,搜索、类型筛选和 Shift 多选只影响当前社区,返回全图时社区高亮会跟随视野稳定后再淡出;社区阅读点“回全图”是一段更短的连续退出过渡,镜头拉回全局构图、保留来源社区高亮,不重开摘要抽屉、不清钉扎位置和全局筛选偏好
- - **社区阅读关系视觉分层** — 进入社区默认第一眼就能区分结构关系和背景关系:结构跨度选择器只从真实关系里按社区规模分档挑出少量骨架关系,优先串起核心节点和小团块,而不是堆在权重最强的关系上;Sigma 社区阅读主路径让结构关系比背景关系更清楚,关系颜色仍只表达关系类型。沿用明亮、直向的视觉语言,不引入弯曲关系呈现或粗重主干视觉
- - **社区节点阅读让位** — 社区内单击节点打开右侧阅读抽屉时,画布变窄和镜头让位保持连续;宽屏下节点留在剩余画布的舒适位置,窄屏覆盖或全屏阅读时不强行移动镜头
- - **选区抽屉查看全部 / 收起** — Shift 多选攒下的选区抽屉默认只显示前 3 个选中页面,超过 3 个可"查看全部",展开后可"收起";继续 Shift 多选保持展开 / 收起状态,抽屉静默实时更新(不重开、不抢焦点、不清补充说明),多选全程不移动镜头
- - **图谱视野稳定** — 点击社区摘要或重复点击同一位置时,图谱保持原视角,不会被右侧抽屉挤动
- - **工作台 Paper 视觉** — Paper v2 暖纸配色覆盖工作台默认主题、新对话按钮、消息气泡、侧栏和图谱控件,长标题和长消息保持在页面内部
- - **查询结果持久化** — 有价值的综合回答可保存回知识库,越用越完整
- - **批量消化** — 给一个文件夹路径,批量处理所有文件
- - **工作台事件流更稳** — 批量消化进度和活地图更新都有明确顺序与结束规则;单文件失败可继续,整体失败或取消会明确收口,图谱断线后会确认进入新的连接并重新取得当前错误或当前图谱,异常事件会安全停止或重连
- - **工作台对话自动跟随** — 发送消息和接收长回复时默认跟随最新内容,用户上翻阅读历史时暂停,并提供图标按钮回到底部
- - **工作台工具摘要** — `workbench/` 对话区采用 `omp` 风格动态工具状态,停止时显示取消状态,历史工具调用默认折叠为分组摘要
- - **工作台本地访问保护** — 本地内容和状态操作都要同时通过来源与启动凭证检查,陌生网页不能读取内容或改变工作台状态
- - **工作台请求边界** — 前台只会发送已登记的请求方式与入口组合;产出物清单和下载统一拒绝不合规编号,文件下载和事件流继续使用各自独立的处理通道
- - **工作台命令清单** — 对话里的 `/` 菜单和设置里的能力统计使用同一套受保护读取,列表不会显示本机能力路径
- - **工作台认证设置** — 保存 API key 和测试连接使用同一套保护与提示;失败不会暴露本机信息、密钥或底层错误
- - **工作台可靠启动** — 正式启动和自动检查走同一套恢复与关闭流程;失败启动不改现有凭证,退出会有序结束持续连接和图谱重建进程并在必要时兜底清理,macOS 与 Linux 检查都会主动阻止真实用户资料读取、临时目录外写入和外网访问
- - **工作台真实浏览器检查** — 使用一次性用户环境、真实前后台、真实端口、HTTP 和事件流验证七类主要流程,并覆盖隔离、取消、断线、繁忙和失败恢复;线上准备、正式检查、清理和诊断各有明确时限,冷启动不会静默挤掉正式检查;外部模型和系统文件夹选择器由测试边界替代,普通启动和正式构建不包含这些替身
- - **工作台统一质量检查** — 本机与 GitHub 运行同一套完整检查;前台不会复用过期结果,失败会清理进程并只短期保留经过清理的虚构测试材料
- - **知识库健康检查** — 脚本检测孤立页面、断链、index 一致性;AI 层面检查矛盾和交叉引用
- - **ingest 隐私自查** — 首次消化素材时提醒检查手机号、API key 等敏感信息
- - **图谱关系词汇表** — 可选的手动标注词汇,让图谱表达更精确
- - **Obsidian 兼容** — 所有内容都是本地 markdown,直接用 Obsidian 打开
- </details>
- <details>
- <summary><strong>安装详情</strong></summary>
- ### 默认安装位置
- | 平台 | 路径 |
- |---|---|
- | Claude Code | `~/.claude/skills/llm-wiki` |
- | Codex | `~/.codex/skills/llm-wiki` |
- | OpenClaw | `~/.openclaw/skills/llm-wiki` |
- | Hermes | `~/.hermes/skills/llm-wiki` |
- ### 更新
- 已安装?进入仓库目录执行:
- ```bash
- bash install.sh --upgrade
- ```
- 自动完成:`git pull` → 检测已安装平台 → 重新复制核心文件 → 已有 hook 不受影响。
- Claude Code 默认安装的,可以直接用 `/llm-wiki-upgrade`。
- 自定义目录:
- ```bash
- bash install.sh --upgrade --platform openclaw --target-dir <你的技能目录>/llm-wiki
- ```
- ```bash
- bash install.sh --upgrade --platform hermes --target-dir <你的技能目录>/llm-wiki
- ```
- ### 前置条件
- - 核心:agent 能执行 shell 命令、读写本地文件即可;图谱构建和来源信号覆盖检查需要 `jq` + `node`
- - 可选:微信公众号提取需要 `uv`;网页提取需要 `bun` 或 `npm`;需要登录态的内容可开启 Chrome 调试端口 9222
- </details>
- <details>
- <summary><strong>目录结构</strong></summary>
- ```
- 你的知识库/
- ├── raw/ # 原始素材(不可变)
- │ ├── articles/ # 网页文章
- │ ├── tweets/ # X/Twitter
- │ ├── wechat/ # 微信公众号
- │ ├── xiaohongshu/ # 小红书
- │ ├── zhihu/ # 知乎
- │ ├── pdfs/ # PDF
- │ ├── notes/ # 笔记
- │ └── assets/ # 图片等附件
- ├── wiki/ # AI 生成的知识库
- │ ├── entities/ # 实体页(人物、概念、工具)
- │ ├── topics/ # 主题页
- │ ├── sources/ # 素材摘要
- │ ├── comparisons/ # 对比分析
- │ ├── synthesis/ # 综合分析
- │ │ └── sessions/ # 对话结晶页面
- │ └── queries/ # 保存的查询结果
- ├── purpose.md # 研究方向与目标
- ├── index.md # 索引
- ├── log.md # 操作日志
- ├── .wiki-schema.md # 配置
- └── .wiki-cache.json # 素材去重缓存
- ```
- </details>
- <details>
- <summary><strong>常见问题</strong></summary>
- **这个仓库还是只给 Claude 用吗?**
- 不是。Claude 只是其中一个入口。同一个链接能被 Claude Code、Codex、OpenClaw、Hermes 安装和使用。
- **为什么 Hermes 要看 `HERMES.md`?**
- Hermes 会优先加载仓库根的 `HERMES.md` 作为项目上下文。这个文件只负责 Hermes 的入口与安装说明,核心能力和工作流仍以 `SKILL.md` 为准。
- **Claude Code 里可以直接用命令更新吗?**
- 可以。默认安装后自带 `/llm-wiki-upgrade`,更新核心主线。需要网页/X/公众号/YouTube/知乎提取能力时,再加 `--with-optional-adapters`。
- **X/Twitter 提取失败?**
- 确保已安装可选提取器(`--with-optional-adapters`)。需要登录态的内容请开启 Chrome 调试端口 9222,或者直接粘贴内容给 agent。
- **公众号提取失败?**
- 需要 `uv`。安装后重新运行 `bash install.sh --platform <你的平台> --with-optional-adapters`。
- </details>
- ## Windows 用户
- Windows PowerShell 5.1(Win10 / Win11 系统自带)默认 console 编码为 GB2312、`$OutputEncoding` 为 ASCII,Python 子进程 `sys.stdout.encoding` 默认为 `gbk`。直接在 PS 5.1 下运行 `bash install.sh` 会导致中文输出和 hook JSON 出现乱码([#16](https://github.com/sdyckjq-lab/llm-wiki-skill/issues/16))。
- **方案 A — 使用 `install.ps1`(推荐)**
- 在仓库根目录下:
- ```powershell
- powershell -ExecutionPolicy Bypass -File install.ps1 --platform claude
- powershell -ExecutionPolicy Bypass -File install.ps1 --platform codex --dry-run
- ```
- `install.ps1` 会自动把 console / `$OutputEncoding` / `PYTHONIOENCODING` 全部设为 UTF-8,再转发到 `bash install.sh`。
- **方案 B — 手动设置 PowerShell 编码**
- ```powershell
- chcp 65001
- [Console]::OutputEncoding = [System.Text.Encoding]::UTF8
- $OutputEncoding = [System.Text.Encoding]::UTF8
- $env:PYTHONIOENCODING = 'utf-8'
- bash install.sh --platform claude
- ```
- **方案 C — 升级到 PowerShell 7+**
- PowerShell 7 默认 UTF-8。安装:`winget install Microsoft.PowerShell`,然后 `pwsh` 下直接 `bash install.sh --platform claude`。
- ### Python 命令
- Windows 上 Python 通常安装为 `python.exe` 而非 `python3.exe`(Microsoft Store 的 `python3` 是安装提示 stub,调用会失败)。本项目 `scripts/shared-config.sh` 已加入自动检测:**先尝试 `python3`,失败回退到 `python`**。所以只要 Python 3.8+ 在 PATH 中(任一命名即可),脚本能正常工作。
- ---
- ## 致谢
- 本项目复用和集成了以下开源项目:
- - **[Andrej Karpathy](https://karpathy.ai/)** — [llm-wiki gist](https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f),核心方法论来源
- - **[baoyu-url-to-markdown](https://github.com/JimLiu/baoyu-skills#baoyu-url-to-markdown)** by [JimLiu](https://github.com/JimLiu) — 网页、X/Twitter 内容提取
- - **youtube-transcript** — YouTube 字幕提取
- - **[wechat-article-to-markdown](https://github.com/jackwener/wechat-article-to-markdown)** — 微信公众号文章提取
- ## License
- MIT
- ---
- ## Star History
- [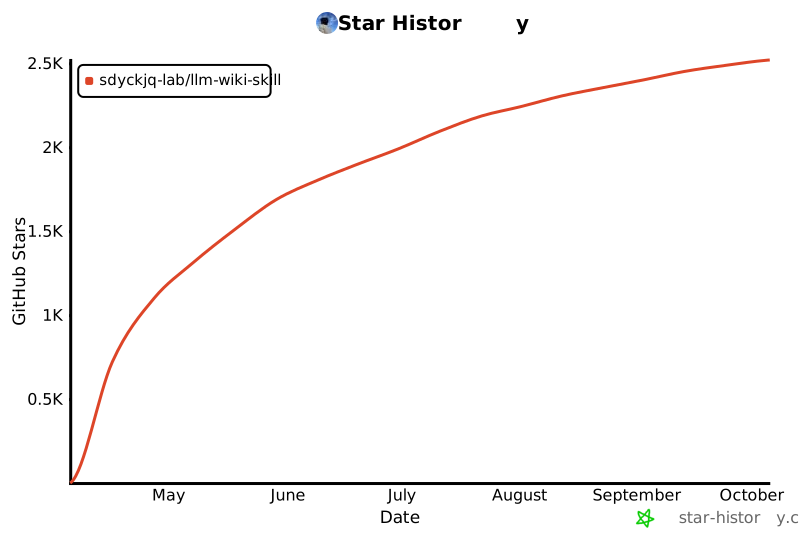](https://www.star-history.com/?repos=sdyckjq-lab%2Fllm-wiki-skill&type=date)
Ratings and comments
Sign in to rate this skill.
Sign inFree to use. If it’s helped, pass it on.