feedgrab
Universal content grabber — fetch, normalize, and digest content from 7+ platforms (WeChat, XHS, X/Twitter, YouTube, Bilibili, Telegram, RSS)
Safety scan
A static text scan, not a guarantee. Select the badge to see what was scanned and every finding.
Badge for your README

Markdown
[](/listings/ibigqiang--feedgrab)HTML
<a href="/listings/ibigqiang--feedgrab"><img src="/api/listings/ibigqiang--feedgrab/badge.svg" alt="findsafeskills safety rating" /></a>Install
Install instructions from the README
As written by the repo's author. findsafeskills has not verified these steps.
# 从 GitHub 安装(推荐)
pip install git+https://github.com/iBigQiang/feedgrab.git

# 带隐身浏览器 + TLS 指纹(patchright + browserforge + curl_cffi — 推荐,反检测能力最强)
pip install "feedgrab[stealth] @ git+https://github.com/iBigQiang/feedgrab.git"
patchright install chromium

# Twitter 搜索增强(x-client-transaction-id 反检测签名,x-so 命令必需)
pip install "feedgrab[twitter] @ git+https://github.com/iBigQiang/feedgrab.git"

# 小红书 API 增强(xhshow API 抓取,xhs-so 命令必需)
pip install "feedgrab[xhs] @ git+https://github.com/iBigQiang/feedgrab.git"

# 或使用 Playwright 兜底
pip install "feedgrab[browser] @ git+https://github.com/iBigQiang/feedgrab.git"

# 安装所有可选依赖
pip install "feedgrab[all] @ git+https://github.com/iBigQiang/feedgrab.git"
快速开始
安装完成后,运行一键部署引导:
feedgrab setup
按提示完成 5 个步骤:环境检查 → 配置文件 → UA 检测 → 平台登录 → 功能启用,即可开始使用。每步可跳过,重复运行自动跳过已完成项。
或克隆后本地安装:
```bash
git clone https://github.com/iBigQiang/feedgrab.git
cd feedgrab
pip install -e ".[all]"
patchright install chromium   # 推荐(反检测更强)
# 或: playwright install chromium
视频/音频依赖(可选)
# macOS
brew install yt-dlp ffmpeg

# Linux
pip install yt-dlp
apt install ffmpeg
Whisper 转录需要从 [Groq](https://console.groq.com/keys) 免费获取 API 密钥并设置:
export GROQ_API_KEY=your_key_here
What was scanned
The files the safety scan read, as written by the repository's author and shown as plain text. Lines with a finding are marked.
README.md · README · 965 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
This file has changed since it was scanned, so this is not exactly the text that was scanned, and no line is marked. The findings are listed with the safety scan above.
- <div align="center">
- <h1>feedgrab</h1>
- <h3>18+ 主流自媒体与内容平台的一站式抓取、批量采集与 Obsidian Markdown 输出工具</h3>
- <p>
- <a href="DEVLOG.md"><img src="https://img.shields.io/badge/version-v0.25.0-0A84FF.svg" alt="feedgrab v0.25.0"></a>
- <a href="#安装"><img src="https://img.shields.io/badge/platform-Windows%20%7C%20macOS%20%7C%20Linux-6B7280.svg" alt="Windows, macOS and Linux"></a>
- <a href="https://www.python.org/"><img src="https://img.shields.io/badge/built%20with-Python%203.10%2B-3776AB.svg?logo=python&logoColor=white" alt="Built with Python 3.10+"></a>
- <a href="LICENSE"><img src="https://img.shields.io/badge/license-MIT-22C55E.svg?logo=opensourceinitiative&logoColor=white" alt="MIT License"></a>
- <a href="https://github.com/iBigQiang/feedgrab/stargazers"><img src="https://img.shields.io/github/stars/iBigQiang/feedgrab?style=flat&logo=github&label=stars" alt="GitHub Stars"></a>
- </p>
- <p>
- <a href="https://playwright.dev/"><img src="https://img.shields.io/badge/browser-Playwright-2EAD33.svg?logo=playwright&logoColor=white" alt="Playwright browser automation"></a>
- <a href="https://modelcontextprotocol.io/"><img src="https://img.shields.io/badge/protocol-MCP-7C3AED.svg" alt="Model Context Protocol server"></a>
- <a href="https://code.claude.com/docs/en/features-overview"><img src="https://img.shields.io/badge/skills-Claude%20Code-D97757.svg?logo=anthropic&logoColor=white" alt="Claude Code skills"></a>
- <a href="https://obsidian.md/"><img src="https://img.shields.io/badge/output-Obsidian%20Markdown-7C3AED.svg?logo=obsidian&logoColor=white" alt="Obsidian-compatible Markdown"></a>
- </p>
- <p><strong>feedgrab</strong> 是一个面向主流自媒体与内容平台的 <strong>vibe coding</strong> 开源抓取工具。输入已支持平台的 URL 或关键词,它会自动识别平台、批量抓取内容,并统一输出为带完整元数据、兼容 Obsidian 的 Markdown 文档。目前支持 18+ 主流平台,核心抓取链路优先使用免费接口,通常无需购买付费 API,使用成本接近 0。</p>
- <h3>🌐 官方仓库与使用文档:<a href="https://github.com/iBigQiang/feedgrab">github.com/iBigQiang/feedgrab</a></h3>
- <p><strong><a href="README_en.md">English</a></strong> | <strong>中文</strong> | <a href="#安装">安装</a> | <a href="https://github.com/iBigQiang/feedgrab/tree/feedgrab-desktop">Windows桌面版</a> | <a href="DEVLOG.md">更新日志</a></p>
- </div>
- ## ❤️ 赞助商
- > [想出现在这里?](mailto:ibigqiang@gmail.com)
- <details open>
- <summary>点击展开或收起赞助商内容</summary>
- **👑 冠名赞助商**
- [](https://hitu.me/zh/)
- 感谢「嗨图象」冠名赞助 feedgrab!嗨图象是一站式 ChatGPT 图像生成工具,支持文生图、图像编辑、风格迁移、背景移除、老照片修复和高清放大。注册即享免费额度,无需信用卡,无水印限制,适合内容创作者、电商和所有需要高效制作图片的用户。 **[开启「嗨图象」AI 生图体验](https://hitu.me/zh/generate)** 或通过 **[活动链接](https://hitu.me/zh/notices/order-and-get-20-off-in-points)** 注册并充值套餐,获得 20% 额外积分。
- ---
- **赞助商**
- <table>
- <tr>
- <td width="180"><a href="https://huangqiang.me/"><img src="https://huangqiang.me/og.png" alt="强子手记 · iBigQiang" width="150"></a></td>
- <td>感谢<strong><a href="https://huangqiang.me/?utm_source=github&utm_medium=link&utm_campaign=feedgrab">强子手记</a></strong>支持 feedgrab!强子手记是 BigQiang / iBigQiang 的个人 IP 品牌网站,汇集独立开发、开源项目、产品、文章与合作入口,访问<strong><a href="https://huangqiang.me/">huangqiang.me</a></strong></td>
- </tr>
- <tr>
- <td width="180"><a href="https://www.ipwo.net/?ref=githubfeedgrab"><img src="docs/Sponsor/IPWO_LOGO.png" alt="IPWO" width="150"></a></td>
- <td><strong><a href="https://www.ipwo.net/?ref=githubfeedgrab">IPWO</a></strong> 提供动态住宅代理、静态住宅代理及不限量住宅代理,覆盖 195+ 地区,支持 HTTP(S) 与 SOCKS5 协议。<br><br>对于使用 feedgrab 采集的用户,IPWO 可作为可选的住宅代理资源,支持地区选择与网络连接配置,为跨地区内容获取、数据整理和信息研究提供更多选择。<br><br>支持<a href="https://www.ipwo.net/?ref=githubfeedgrab">免费测试</a>,优惠折扣码:0200。</td>
- </tr>
- <tr>
- <td width="180"><a href="https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=feedgrab"><img src="docs/Sponsor/ATLAS_CLOUD_LOGO_BLACK.svg" alt="Atlas Cloud" width="150"></a></td>
- <td><strong><a href="https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=feedgrab">Atlas Cloud</a></strong> 是一个全模态 AI 推理平台,为开发者提供统一的 AI API,可调用视频生成、图像生成和大语言模型 API。无需分别对接多个供应商,只需接入一次,即可统一访问覆盖所有模态的 300+ 精选模型。
- Atlas Cloud 新推出 Coding Plan 优惠方案,以更实惠的价格提供 API 访问:<a href="https://www.atlascloud.ai/console/coding-plan/?utm_source=github&utm_medium=link&utm_campaign=feedgrab">https://www.atlascloud.ai/console/coding-plan</a></td>
- </tr>
- </table>
- </details>
- ## 它能做什么
- ```
- 任意 URL → 平台检测 → 抓取内容 → 统一输出
- ↓ ↓ ↓
- 自动识别 文本:Jina Reader → output/X/作者_日期:标题.md
- 18+ 平台 视频:InnerTube API → yt-dlp 字幕 → output/YouTube/作者_日期:标题.md
- 音频:Whisper 转录
- API:Bilibili / RSS / Telegram / YouTube Data API v3 / GitHub REST API / 飞书 Open API / Discourse Topic JSON
- X/Twitter:GraphQL → FxTwitter → Syndication → oEmbed → Jina → Playwright
- ```
- Python 层负责文本抓取和 YouTube 字幕提取。**Claude Code 技能**(可选)提供完整的 Whisper 视频/播客转录和 AI 内容分析功能。
- ## 三个层级
- feedgrab 可自由组合,按需使用:
- | 层级 | 功能 | 格式 | 安装方式 |
- |------|------|------|----------|
- | **Python CLI/库** | 基础内容抓取 + 统一数据结构 | 见 [安装](#安装) | 必需 |
- | **Claude Code 技能** | 视频转录 + AI 分析 + 内容抓取 | `npx skills add iBigQiang/feedgrab` | 可选 |
- | **MCP 服务器** | 将阅读能力暴露为 MCP 工具 | `python mcp_server.py` | 可选 |
- ### 第一层:Python CLI
- ```bash
- # 抓取任意 URL
- feedgrab https://mp.weixin.qq.com/s/abc123
- # 从剪贴板读取 URL 并抓取(解决 PowerShell 中 & 符号报错问题)
- feedgrab clip
- # 抓取推文(配置好 Cookie 后自动走 GraphQL 深度抓取)
- feedgrab https://x.com/elonmusk/status/123456
- # 批量抓取书签(需要 X_BOOKMARKS_ENABLED=true;仅主账号登录态可读)
- feedgrab https://x.com/i/history # 书签总览(X 现行 URL)
- feedgrab https://x.com/i/history/bookmarks/2015311287715340624 # 指定书签文件夹
- feedgrab https://x.com/i/bookmarks # legacy URL,仍然识别
- # 批量抓取用户推文(需要 X_USER_TWEETS_ENABLED=true)
- feedgrab https://x.com/iBigQiang # 抓取全部推文
- X_USER_TWEETS_SINCE=2026-02-01 feedgrab https://x.com/iBigQiang # 指定日期之后
- # ↑ 超过 ~800 条时自动启动浏览器搜索补充(需 feedgrab login twitter)
- # 批量抓取 Twitter 列表推文(需要 X_LIST_TWEETS_ENABLED=true)
- feedgrab https://x.com/i/lists/2002743803959300263 # 抓取最近 1 天
- X_LIST_TWEETS_DAYS=3 feedgrab https://x.com/i/lists/2002743803959300263 # 抓取最近 3 天
- X_LIST_TWEETS_SUMMARY=true feedgrab https://x.com/i/lists/... # 生成汇总表格(MD + CSV)
- # v0.22.0: 批量抓取 Twitter 用户列表(粉丝/关注/列表成员,输出 MD + CSV)
- feedgrab https://x.com/ai_xiaomu/followers # 粉丝列表
- feedgrab https://x.com/ai_xiaomu/following # 关注列表
- feedgrab https://x.com/ai_xiaomu/verified_followers # 蓝V 粉丝
- feedgrab https://x.com/i/lists/2002743803959300263/members # 列表成员
- feedgrab https://x.com/i/lists/2002743803959300263/subscribers # 列表订阅者
- # v0.22.0: 批量抓取用户的回复推文 & 喜欢推文
- feedgrab https://x.com/ai_xiaomu/with_replies # 用户回复 tab(含自回复)
- feedgrab https://x.com/iBigQiang/likes # 只能抓自己的喜欢 —— 需要主账号登录态
- # v0.23.0: 抓取推文的转推者 / 点赞者列表(输出 MD + CSV,按粉丝倒序)
- feedgrab x-retweeters https://x.com/ai_xiaomu/status/2051099012288356592
- feedgrab x-favoriters 2051099012288356592 # 也支持直接传 tweet_id
- feedgrab https://x.com/ai_xiaomu/status/2051099012288356592/retweets # 等价 URL 路由
- feedgrab https://x.com/iBigQiang/status/2051099012288356592/likes # 点赞者:仅推文作者本人可读 —— 需要主账号登录态
- # v0.23.0: Twitter 人物搜索(SearchTimeline product=People)
- feedgrab x-so "AI Agent" --people # 关键词搜索人物,按粉丝倒序
- # v0.23.0: 抓取被作者隐藏的回复(ModeratedTimeline,仅作者本人 Cookie 可见)
- X_FETCH_MODERATED_REPLIES=true feedgrab https://x.com/me/status/... # 自动追加 thread Phase 8
- # v0.23.0: 自定义媒体文件名(X-only,默认沿用 CDN 原 stem)
- X_DOWNLOAD_MEDIA=true X_MEDIA_FILENAME_PATTERN="{date}_{screen_name}_{tweet_id}_{num}.{ext}" \
- feedgrab https://x.com/ai_xiaomu/status/...
- # 输出文件:20260518_ai_xiaomu_2056173124073525356_1.jpg
- # 支持 token:{date} {datetime} {screen_name} {user_id} {tweet_id} {num} {type} {ext} {name}
- # 批量抓取小红书作者笔记(需要 XHS_USER_NOTES_ENABLED=true + feedgrab login xhs)
- feedgrab https://www.xiaohongshu.com/user/profile/5eb416f...
- XHS_USER_NOTES_SINCE=2026-02-01 feedgrab https://www.xiaohongshu.com/user/profile/5eb416f... # 指定日期之后
- # 批量抓取小红书搜索结果(需要 XHS_SEARCH_ENABLED=true + feedgrab login xhs)
- feedgrab "https://www.xiaohongshu.com/search_result?keyword=开学第一课&source=web_explore_feed"
- # 搜索小红书笔记(通过 xhshow API,无需登录)
- feedgrab xhs-so "AI Agent" # 综合搜索
- feedgrab xhs-so "AI Agent" --sort popular # 按热门排序
- feedgrab xhs-so "AI Agent" --type video # 只搜视频
- feedgrab xhs-so "AI Agent" --sort latest --limit 50 # 最新 50 条
- feedgrab xhs-so "AI Agent" --save # 同时保存单篇 .md
- feedgrab xhs-so "claude code,openclaw,养龙虾" --merge # 多关键词合并到一个表格
- feedgrab xhs-so "claude code,openclaw" # 多关键词分别生成表格
- # 搜索微信公众号文章(通过搜狗微信搜索)
- feedgrab mpweixin-so "AI Agent"
- feedgrab mpweixin-so "AI Agent" --limit 5 # 限制结果数量
- # 搜索 YouTube 视频
- feedgrab ytb-so "AI Agent"
- feedgrab ytb-so "教程" --channel @AndrewNg --order viewCount
- feedgrab ytb-so "ML" --after 2025-01-01 --limit 5
- # 搜索 Twitter 推文(按互动量排序的汇总表格)
- feedgrab x-so openclaw # 默认:最近1天 + 中文 + 最新tab
- feedgrab x-so "AI Agent" --days 7 --min-faves 50 --sort top # 自定义参数
- feedgrab x-so WorkBuddy --lang zh+zxx --sort all # 中文普通推文 + Article 长文,合并 Latest/Top
- feedgrab x-so '"openclaw" lang:zh since:2026-03-01' --raw # 原始查询模式
- feedgrab x-so openclaw --save # 同时保存单篇推文 .md
- feedgrab x-so "梯子,VPN,v2ray,小火箭" --merge # 多关键词合并到一个表格
- feedgrab x-so "claude code,openclaw" # 多关键词分别生成表格
- # 下载 YouTube 视频/音频/字幕(输出到 OUTPUT_DIR/YouTube/ 目录)
- feedgrab ytb-dlv https://www.youtube.com/watch?v=xxx # 下载视频 (MP4)
- feedgrab ytb-dla https://www.youtube.com/watch?v=xxx # 下载音频 (MP3)
- feedgrab ytb-dlz https://www.youtube.com/watch?v=xxx # 下载字幕 (SRT)
- feedgrab ytb-dla https://youtu.be/xxx?si=xxx # 支持短分享链接
- # 按公众号账号批量抓取全部历史文章(需要 feedgrab login wechat)
- feedgrab mpweixin-id "饼干哥哥AGI"
- MPWEIXIN_ID_SINCE=2025-01-01 feedgrab mpweixin-id "饼干哥哥AGI" # 指定日期之后
- # 按专辑批量抓取公众号文章(公开专辑,无需登录)
- feedgrab mpweixin-zhuanji "https://mp.weixin.qq.com/mp/appmsgalbum?__biz=xxx&album_id=xxx"
- MPWEIXIN_ZHUANJI_SINCE=2026-01-01 feedgrab mpweixin-zhuanji "..." # 指定日期之后
- # 抓取 GitHub 仓库 README(自动检测中文 README 优先)
- feedgrab https://github.com/nicepkg/aide # 仓库首页
- feedgrab https://github.com/nicepkg/aide/blob/main/README.md # README 文件页
- feedgrab https://github.com/nicepkg/aide/tree/main/src # 内页(自动回退到仓库级别)
- # 抓取 LinuxDo / Discourse 论坛帖子
- feedgrab https://linux.do/t/topic/2032344
- feedgrab login linuxdo # 私有帖或 Cloudflare 严格校验时先登录
- LINUXDO_REPLY_MODE=all feedgrab https://linux.do/t/topic/2032344 # 抓完整楼层
- # 抓取 IDCFlare / Discourse 论坛帖子
- feedgrab https://idcflare.com/t/topic/44294
- feedgrab login idcflare # 私有帖或 Cloudflare 严格校验时先登录
- IDCFLARE_REPLY_MODE=none feedgrab https://idcflare.com/t/topic/44294 # 仅抓主贴
- # 抓取飞书文档(需要 feedgrab login feishu 或配置 Open API 凭据)
- feedgrab https://xxx.feishu.cn/wiki/ABC123 # wiki 文档
- feedgrab https://xxx.feishu.cn/docx/ABC123 # docx 文档
- FEISHU_DOWNLOAD_IMAGES=true feedgrab https://xxx.feishu.cn/wiki/ABC123 # 同时下载图片
- # 批量抓取飞书知识库
- feedgrab feishu-wiki https://xxx.feishu.cn/wiki/ABC123 # 递归抓取知识库所有文档
- # 抓取金山文档(默认 CDP 模式,复用 Chrome 登录态,Chrome 未运行时自动降级)
- feedgrab https://www.kdocs.cn/l/xxxxx # 自动 CDP → Launch 降级
- KDOCS_CDP_ENABLED=false feedgrab https://www.kdocs.cn/l/xxxxx # 强制 Launch 模式
- KDOCS_DOWNLOAD_IMAGES=true feedgrab https://www.kdocs.cn/l/xxxxx # 同时下载图片到本地
- # 批量抓取多个 URL
- feedgrab https://url1.com https://url2.com
- # 登录某个平台(一次性操作,用于浏览器兜底)
- feedgrab login xhs
- feedgrab login linuxdo
- # Chrome CDP 自动提取 Cookie(Chrome 已登录状态下,免去手动登录流程)
- # 前提:Chrome 开启 Remote Debugging(chrome://inspect/#remote-debugging)
- CHROME_CDP_LOGIN=true feedgrab login twitter
- CHROME_CDP_LOGIN=true feedgrab login xhs
- CHROME_CDP_LOGIN=true feedgrab login kdocs
- # 下载推文图片/视频到本地(保存到 attachments/{item_id}/ 子目录)
- X_DOWNLOAD_MEDIA=true feedgrab https://x.com/user/status/123
- XHS_DOWNLOAD_MEDIA=true feedgrab https://www.xiaohongshu.com/explore/xxx
- MPWEIXIN_DOWNLOAD_MEDIA=true feedgrab https://mp.weixin.qq.com/s/xxx
- # === HackerNews / Medium / Reddit / Weibo / Douyin(v0.20.0 新增)===
- feedgrab https://news.ycombinator.com/item?id=44627001 # HN 单条 + 评论
- feedgrab hn top --limit 30 # HN top stories 批量
- feedgrab hn ask --limit 20 # HN Ask HN 批量
- feedgrab https://medium.com/@dotey/some-article-abc123 # Medium 单篇
- feedgrab medium-user @dotey --limit 20 # Medium 用户主页(RSS + 单篇 Tier 链)
- feedgrab medium-pub better-programming --limit 20 # Medium 出版物主页
- feedgrab https://www.reddit.com/r/MachineLearning/comments/<id>/foo/ # Reddit 单帖 + Top 50 评论
- feedgrab reddit-sub MachineLearning --sort hot --limit 25 # Reddit 子版块批量
- feedgrab reddit-so codex --sort comments --time all --limit 10 # Reddit 关键词搜索
- REDDIT_REPLY_MODE=tree feedgrab https://www.reddit.com/r/... # 保留初始响应里的嵌套回复
- feedgrab https://m.weibo.cn/status/4857881961438732 # 微博单条
- feedgrab weibo-user 1234567890 --limit 20 # 微博用户主页
- feedgrab https://www.douyin.com/video/7234567890123456789 # 抖音单视频
- feedgrab https://v.douyin.com/iL3xpDe/ # 抖音短链(自动 302 解析)
- # === Zsxq 知识星球(v0.21.0 新增)===
- # 首次需要登录(CDP 自动提取或可视化扫码二选一):
- feedgrab login zsxq # 弹 Chrome 扫码登录
- CHROME_CDP_LOGIN=true feedgrab login zsxq # 复用已运行 Chrome 的登录态(推荐)
- feedgrab https://articles.zsxq.com/id_sz9kew31q6we.html # 长文章
- feedgrab https://wx.zsxq.com/group/<gid>/topic/<tid> # 单条 topic 短帖
- feedgrab https://t.zsxq.com/yUX3P # 邀请短链(自动 302 解析)
- ZSXQ_COMMENT_MODE=author feedgrab https://wx.zsxq.com/... # 仅渲染作者本人评论
- ZSXQ_COMMENT_MODE=all feedgrab https://wx.zsxq.com/... # 全部评论
- # === FlowUs 息流(v0.24.0 新增)===
- # 公开分享链接:零 cookie 直接抓取
- feedgrab https://flowus.cn/baochang/share/1e8b026a-cb5a-41bb-8f2c-61fed1d3cc54
- feedgrab https://flowus.cn/share/<uuid>?code=<share_code>
- # 付费/私有文档:需要复用本机 Chrome 登录态
- CHROME_CDP_LOGIN=true feedgrab login flowus # CDP 直提本机 Cookie(推荐)
- feedgrab login flowus # 或弹 Playwright 浏览器手动登录
- feedgrab https://flowus.cn/share/<uuid>?code=<paid_code> # 后续抓取直接复用 sessions/flowus.json
- # 图片模式:默认在线签名 URL 可预览;开启后下载为本地 attachments/
- FLOWUS_DOWNLOAD_IMAGES=true feedgrab https://flowus.cn/share/<uuid>?code=<code>
- # 自动检测本机 Chrome UA 并写入 .env(推荐首次部署时运行)
- feedgrab detect-ua
- # 一键诊断(Cookie、依赖、queryId、网络)
- feedgrab doctor # 全平台检查
- feedgrab doctor x # Twitter/X 专项
- feedgrab doctor xhs # 小红书专项
- feedgrab doctor mpweixin # 微信公众号专项
- feedgrab doctor feishu # 飞书专项
- # 查看内容统计
- feedgrab list
- # 重置子目录(删除 .md 文件 + 清理去重索引,方便重新抓取)
- feedgrab reset bookmarks/OpenClaw # 重置书签文件夹
- feedgrab reset status_author/向阳乔木 # 重置账号推文目录
- feedgrab reset bookmarks/all # 重置全部书签
- # 清理索引目录中的批量记录和缓存文件(保留去重索引)
- feedgrab clean-index # 交互确认后清理
- feedgrab clean-index --yes # 跳过确认直接清理
- ```
- > `feedgrab reset` 会扫描目标目录下所有 `.md` 文件的 YAML front matter,提取 `item_id` 并从去重索引中移除,然后删除文件。执行前会显示待删除数量并要求确认。找不到目录时会自动列出所有可用的子目录。
- > `feedgrab clean-index` 清理索引目录中除 `item_id_url.json`(全局去重索引)以外的所有文件,包括批量记录(`status_*.json`、`list_*.json` 等)和 API 断点缓存(`.api_discovery_*.jsonl`)。这些文件在采集完成后不再需要,定期清理可释放磁盘空间。
- ### 第二层:Claude Code 技能
- 一键安装所有技能:
- ```bash
- npx skills add iBigQiang/feedgrab
- ```
- 包含 5 个技能:
- | 技能 | 命令 | 说明 |
- |------|------|------|
- | `feedgrab` | `/feedgrab <URL>` | 核心抓取 — 给 URL 返回结构化 Markdown |
- | `feedgrab-batch` | `/feedgrab-batch` | 批量抓取 — 书签、用户推文、搜索、微信批量等 |
- | `feedgrab-setup` | `/feedgrab-setup` | 安装引导 — pip install + 配置 + 诊断 |
- | `analyzer` | `/analyze <URL>` | 内容分析 — 多维度结构化分析报告 |
- | `video` | 自动触发 | 视频转录 — yt-dlp 字幕 + Whisper 转录 |
- 安装后在 Claude Code 中直接发送 URL,对应技能会自动触发。
- ### 第三层:MCP 服务器
- > 需要克隆仓库(mcp_server.py 不包含在 pip install 中)。
- ```bash
- git clone https://github.com/iBigQiang/feedgrab.git
- cd feedgrab
- pip install -e ".[mcp]"
- python mcp_server.py
- ```
- 暴露的工具:
- - `read_url(url)` — 抓取任意 URL
- - `read_batch(urls)` — 批量并发抓取多个 URL
- - `list_inbox()` — 查看已抓取的内容
- - `detect_platform(url)` — 从 URL 识别平台
- Claude Code 配置(`~/.claude/claude_desktop_config.json`):
- ```json
- {
- "mcpServers": {
- "feedgrab": {
- "command": "python",
- "args": ["/你的路径/feedgrab/mcp_server.py"]
- }
- }
- }
- ```
- ## 支持的平台
- | 平台 | 文本抓取 | 视频/音频转录 |
- |------|---------|-------------|
- | YouTube | **InnerTube API**(零依赖零 quota)+ YouTube Data API v3 搜索 | InnerTube → yt-dlp 字幕 → Groq Whisper 兜底 + 智能断句 + 章节解析 |
- | B 站 (Bilibili) | API 元数据 | **字幕 3 级兜底**(`/x/player/v2` → `/x/player/wbi/v2` WBI 签名 → Whisper 可选) + 共享 Whisper 管线 |
- | **小宇宙(Xiaoyuzhou)** | `__NEXT_DATA__` SSR(title/shownotes/podcast/m4a URL) | **Groq Whisper 自动转录** + 智能断句 + 章节解析 |
- | **喜马拉雅(Ximalaya)** | Web Revision API(audio + simple,免费节目直链 m4a) | **Groq Whisper 自动转录**(付费节目 `canPlay=false` 降级元数据) |
- | X / Twitter | **GraphQL** → **FxTwitter** → **Syndication** → oEmbed → Jina → Playwright | — |
- | 微信公众号 | Jina → Playwright WeChat JS 提取(单篇 + markdownify 富文本 + 图片防盗链)/ 搜狗搜索(`mpweixin-so`)/ MP 后台 API 按账号批量(`mpweixin-id`)/ 专辑批量(`mpweixin-zhuanji`) | — |
- | GitHub | **REST API**(仓库元数据 + 中文 README 优先(含子目录语言链接搜索)+ 相对图片链接补全 + 摘要提取) | — |
- | LinuxDo / Discourse 论坛 | **Discourse Topic JSON API** → **CDP 复用 Chrome** → **Playwright 页面内 fetch** → Jina(最后兜底;默认保存主贴 + 楼主自回,可切换为完整楼层) | — |
- | IDCFlare / Discourse 论坛 | **Discourse Topic JSON API** → **CDP 复用 Chrome** → **Playwright 页面内 fetch** → Jina(最后兜底;默认保存主贴 + 楼主自回,可切换为完整楼层) | — |
- | 小红书 | **API (xhshow)** → **Pinia Store 注入** → Jina → **Playwright 深度抓取** (单篇 + **作者批量** + **搜索批量** + **关键词搜索 `xhs-so`**) | — |
- | 飞书/Lark | **Open API** → **CDP 直连** → **Playwright PageMain** → Jina(单篇 + **知识库批量 `feishu-wiki`** + 嵌入表格 + 图片下载;支持虚拟目录树抓取、懒加载 Sheet 预热、`/sheet/block` 合并、重复单元格不再错列) | — |
- | 金山文档/KDocs | **Playwright ProseMirror DOM** 提取(虚拟滚动 + 代码块 + 图片 shapes API + CDP 直连) | — |
- | 有道云笔记 | **JSON API**(零依赖)→ Playwright iframe DOM → Jina(单篇 + 图片下载) | — |
- | 知乎 | **API v4** → **Playwright CDP/DOM** → Jina(单篇问答前 3 楼 + 专栏文章 + **关键词搜索 `zhihu-so`**) | — |
- | Telegram | Telethon | — |
- | RSS | feedparser | — |
- | 小宇宙播客 | 见上方「小宇宙」行 | Groq Whisper 自动转录 |
- | Apple Podcasts | — | 通过 Claude Code 技能 |
- | **HackerNews** | **Hacker News Firebase API v0**(0 Cookie / 0 反爬,单条 item + 一层评论 + `hn top/new/best/ask/show/jobs` 列表批量) | — |
- | **Medium** | **Jina Reader** → JSON-LD articleBody → Stealth Browser;用户/出版物批量走 RSS feed (`medium-user @<handle>` / `medium-pub <slug>`) | — |
- | **Reddit** | **old.reddit.com .json + 自报 UA** → CDP 复用 Chrome → Stealth Playwright + saved session → Jina(单帖支持 `REDDIT_REPLY_MODE=top/tree/all`,`reddit-sub` 子版块批量,`reddit-so` 关键词搜索 + 汇总表) | — |
- | **Weibo** | m.weibo.cn 移动端 API(show + container/getIndex)+ SSR `$render_data` 兜底(单条 + `weibo-user` 用户主页批量;SUB Cookie 可选) | — |
- | **Douyin** | **CDP 复用 Chrome** → Stealth Playwright + saved session → SSR `RENDER_DATA` 解析 → Jina(不破解签名,依赖浏览器内执行;短链自动 302 解析 aweme_id) | — |
- | **知识星球**(Zsxq) | Tier 0 HTTP cookie(articles.zsxq.com SSR HTML / api.zsxq.com `/topics/{id}/info` JSON)→ CDP 复用 Chrome → Stealth Playwright → Jina;topic 五形态全覆盖(talk / question+answer / article / **solution**);短链 `t.zsxq.com/<code>` 302 解析;评论三态 `none/all/author` | `feedgrab login zsxq` |
- | **FlowUs 息流**(v0.24.0) | Tier 0 纯 HTTP `/api/docs/{uuid}`(公开链接零 cookie 直出;付费/私有需 `next_auth`+`next_auth.sig` 双 cookie,CDP 复用本机 Chrome)→ Tier 1 CDP → Tier 2 Launch+saved session(浏览器内 fetch)→ Jina;Notion 风格 block-tree 渲染(8 类 block + 5 种 enhancer + 链接片段);图片本地化时 headless 浏览器渲染抓 `cdn2.flowus.cn` 签名 URL 后直拉 | `feedgrab login flowus` |
- | **付费新闻网站**(NYT/WSJ/FT/Economist/Bloomberg/SCMP 等 300+ 站) | **7 级 Tier 付费墙绕过**(JSON-LD 探测 + Googlebot/Bingbot UA + AMP 页面 + archive.today + Google Cache) | — |
- | 任意网页 | **JSON-LD 前置** → Jina 兜底 | — |
- > \*小红书支持 **API 抓取**(xhshow,无需登录)和 **浏览器抓取**(需一次性登录:`feedgrab login xhs`)。单篇抓取优先走 API(完整元数据 + 评论),API 不可用时自动降级到 **Pinia Store 注入**(浏览器原生请求,无需第三方签名库)→ Jina → Playwright。**关键词搜索**(`feedgrab xhs-so`)和**作者主页批量**、**搜索结果批量**同样支持 Pinia 兜底层。`XHS_PINIA_ENABLED=true`(默认开启)。
- >
- > YouTube Whisper 转录需要 `GROQ_API_KEY` — 从 [Groq](https://console.groq.com/keys) 免费获取
- ### X/Twitter 六级兜底策略
- feedgrab 对 X/Twitter 内容采用先进的六级兜底策略:
- | 层级 | 方式 | 是否需要认证 | 能力 |
- |------|------|-------------|------|
- | 0 | **GraphQL API** | 需要 Cookie(`auth_token` + `ct0`) | 完整线程、图片、视频、引用推文、长文章 |
- | 0.3 | **FxTwitter API** | 不需要 | 文本、图片、视频、完整互动数据(含 views/bookmarks)、Article Draft.js、作者画像 |
- | 0.5 | **Syndication API** | 不需要 | 文本、图片、视频、互动数据(likes/replies)、article 检测 |
- | 1 | oEmbed API | 不需要 | 单条推文文本(仅公开推文) |
- | 2 | Jina Reader | 不需要 | 个人主页、非推文页面 |
- | 3 | Playwright | 可选 session | 需要登录的内容,最后兜底 |
- > **FxTwitter API 的价值**:第三方公共 API,无需认证即可获取接近 GraphQL 的数据完整度(含 views、bookmarks、Article 全文)。缺少 blue_verified、listed_count 和线程展开。批量模式下连续 3 次失败自动触发 circuit breaker 跳过。
- > **Syndication API 的价值**:有 Cookie 时 GraphQL 自动切换,正常使用基本不会降级到 Syndication。Syndication 的价值在于:当 Cookie 全部过期/失效时,用户不需要立刻重新登录,仍能拿到 80% 的数据(缺 retweets/bookmarks/views 三项),而不是降级到只有纯文本的 oEmbed。
- Tier 0(GraphQL)移植自 [baoyu-danger-x-to-markdown](https://github.com/JimLiu/baoyu-skills/tree/main/skills/baoyu-danger-x-to-markdown) 技能,特性包括:
- - 动态 `queryId` 解析(从 X 前端 JS bundle 中提取)
- - 完整线程重建(作者自回复链)
- - 多阶段分页(向上 + 向下 + 续页)
- - 完整媒体提取(图片、视频、引用推文)
- - 互动数据(likes / retweets / replies / bookmarks / views)
- - 作者回帖 + 评论区采集(可选开关)
- - **书签批量抓取**(全部书签 / 指定文件夹)
- - **用户推文批量抓取**(全部 / 按日期过滤,自动跳过 RT + 会话去重)
- - **列表推文批量抓取**(按天数过滤 1/2/3/7 天,会话去重,线程自动深度抓取)
- - **浏览器搜索补充**(突破 UserTweets ~800 条限制,自动按月分片搜索补充历史推文)
- - **全局去重索引**(跨模式统一去重)
- ### X/Twitter Cookie 配置
- Tier 0(GraphQL)需要 Twitter Cookie 才能获取完整数据。**未配置 Cookie 时会自动降级**,但将导致:
- - 无法获取 likes / views / bookmarks 等互动指标
- - 无法获取作者回帖和评论
- - 无法使用书签批量抓取和账号批量抓取
- - 仅能获取基础正文内容(oEmbed + Jina 兜底)
- **配置方法(任选其一):**
- #### 方式 1:浏览器登录(推荐)
- ```bash
- feedgrab login twitter
- ```
- 自动打开浏览器,登录 X 账号后 Cookie 会保存到 `sessions/twitter.json`,后续自动读取。
- #### 方式 2:`.env` 环境变量
- 从浏览器 DevTools 手动复制 Cookie 值:
- 1. 打开 https://x.com 并登录
- 2. 按 F12 打开开发者工具 → Application → Cookies → `https://x.com`
- 3. 找到 `auth_token` 和 `ct0` 两个值
- 4. 写入 `.env` 文件:
- ```env
- X_AUTH_TOKEN=你的auth_token值
- X_CT0=你的ct0值
- ```
- > 环境变量优先级最高,设置后会覆盖其他来源的 Cookie。
- #### 方式 3:手动创建 Cookie 文件
- 创建 `sessions/x.json`(路径受 `FEEDGRAB_DATA_DIR` 控制,默认 `sessions/`):
- ```json
- {
- "auth_token": "你的auth_token值",
- "ct0": "你的ct0值"
- }
- ```
- > 还支持方式 4:Chrome CDP 自动提取 — 在 Chrome 中开启 `chrome://inspect/#remote-debugging`,然后 `CHROME_CDP_LOGIN=true feedgrab login twitter` 即可从已登录的 Chrome 秒提取 Cookie。
- **Cookie 优先级**:环境变量 > Playwright session (`twitter.json`) > Cookie 文件 (`x.json`) > Chrome CDP
- #### 多账号 Cookie 轮换(防 429 限流)
- 批量抓取时 GraphQL 容易触发 429 限流。配置多个 X 账号的 Cookie 可自动轮换:
- ```
- sessions/
- ├── twitter.json ← 主账号(feedgrab login twitter 自动生成)
- ├── x_2.json ← 第二个账号(手动创建)
- ├── x_3.json ← 第三个账号...
- ```
- 额外账号的 Cookie 文件格式同方式 3。获取方法:
- 1. 用 Chrome/Edge 打开 https://x.com 并登录目标账号
- 2. 按 F12 → **Application** 标签 → 左侧展开 **Cookies** → 点击 `https://x.com`
- 3. 找到 `auth_token` 和 `ct0` 两行,复制值填入 `sessions/x_2.json`
- > Cookie 不绑定 IP/设备,可跨电脑使用。只要不在浏览器上退出登录,Cookie 就一直有效。
- >
- > 429 时自动切换到下一个未限流账号,15 分钟冷却后自动恢复。
- #### 主账号 vs 轮换:哪些渠道必须用主账号
- 轮换只对**公开**数据有意义。账号私有渠道只有唯一一个登录态读得到,轮换过去只会丢掉那个唯一可能成功的账号。以下边界由 2026-08-31 的真实抓取交叉实测确认(主号 `@iBigQiang` vs 备用号 `x_2.json`),不是推测:
- | 渠道 | 权限边界 | 行为 |
- |------|---------|------|
- | 书签(`/i/history`、`/i/history/bookmarks/<id>`) | 账号本人 | 钉死 `sessions/twitter.json`,缺主账号直接报错并给出登录指引 |
- | 用户喜欢(`/<用户>/likes`) | 账号本人 | 钉死主账号。备用号即使抓公开主页的 likes 也是空列表 |
- | 点赞者(`/status/<id>/likes`、`x-favoriters`) | **推文作者本人** | 钉死主账号。对第三方 12817 赞的推文实测,非作者账号一律空列表 |
- | 转推者(`/status/<id>/retweets`、`x-retweeters`) | 公开 | 正常多账号轮换 |
- | 单贴 / 长文 / 账号批量 / 回复 / 列表 / 列表成员 / 关注列表 / 关键词搜索 / 人物搜索 | 公开 | 正常多账号轮换 |
- 所以 likes / 点赞者抓到空结果,含义是「你不是本人 / 不是作者」,**不是**「对方隐藏了列表」——X 只把这两个列表暴露给唯一一个账号。
- ### TwitterAPI.io 付费 API(可选)
- 替代浏览器搜索补充的服务器友好方案,无推文数量限制,$0.15/千条。
- **使用场景**:
- - 推文超过 800 条时自动替代 Playwright 浏览器搜索(配置 API Key 即可)
- - 服务器部署:`X_API_PROVIDER=api` 全量走付费 API,无需 Cookie 和浏览器
- ```env
- # .env 配置
- TWITTERAPI_IO_KEY=your_api_key # 从 https://twitterapi.io 获取
- # X_API_PROVIDER=graphql # graphql(默认) | api(全量付费API)
- # X_API_SAVE_DIRECTLY=false # true=直接保存(快,无图片) | false=GraphQL补全(推荐)
- # X_API_MIN_LIKES= # 最低点赞数(留空=不过滤,三项为 OR 关系)
- # X_API_MIN_RETWEETS= # 最低转发数
- # X_API_MIN_VIEWS= # 最低阅读量
- ```
- **智能直保模式** (`X_API_SAVE_DIRECTLY=true`):普通推文用 API 数据直接保存(快速),长文(article)和线程(thread)仍走 GraphQL 获取完整媒体。
- **断点续传**:发现阶段实时写入缓存文件,中断后重新运行从断点继续,不重复消耗 API 额度。
- ### 输出格式
- 每条内容保存为独立的 Markdown 文件,按平台分目录存放:
- ```
- output/
- ├── X/ # Twitter/X
- │ ├── index/ # 去重索引 + 批量抓取记录
- │ ├── status/ # 单篇推文
- │ ├── status_xxx/ # 用户推文(按 display_name)
- │ ├── bookmarks/ # 全部书签
- │ ├── bookmarks_xxx/ # 书签文件夹(按名称)
- │ └── search/ # 关键词搜索结果(x-so 命令,.md + .csv)
- │ └── 1day_new/ # 按天数+排序分目录
- ├── XHS/ # 小红书
- │ ├── index/ # 去重索引 + 批量抓取记录
- │ ├── notes_xxx/ # 作者笔记(按作者名分目录)
- │ ├── search_xxx/ # 搜索笔记(按关键词分目录)
- │ └── search/ # 关键词搜索结果(xhs-so 命令,.md + .csv)
- ├── mpweixin/ # 微信公众号
- ├── YouTube/ # YouTube
- │ └── search_xxx/ # 搜索结果(按关键词分目录)
- ├── GitHub/ # GitHub 仓库
- │ └── index/ # 去重索引
- ├── Bilibili/ # B 站
- ├── Telegram/ # Telegram
- └── RSS/ # RSS
- ```
- 文件命名格式(Twitter):`作者名_YYYY-MM-DD:标题.md`(如 `强子手记_2026-02-24:最近看到好多新蓝V都成功✅认证了创作者身份。.md`)
- 文件命名格式(YouTube):`作者名_YYYY-MM-DD:标题.{md,mp4,mp3,srt}`(如 `影视飓风_2026-02-12:能卖上亿美金?国产短剧如何征服世界?.md`)
- 文件命名格式(小红书):`作者名_YYYY-MM-DD:标题.md`(如 `墨客老师资料库_2026-02-18:开学第一课还没思路的班主任看过来👀.md`)
- 文件命名格式(GitHub):`owner_repo:README摘要.md`(如 `nicepkg_aide:在 VSCode 中征服任何代码:一键注释、转换、UI 图生成代码、AI 批量处理文件!.md`)
- 文件使用 Obsidian 兼容的 YAML front matter:
- **Twitter 示例:**
- ```yaml
- ---
- title: "OpenClaw新手完整学习路径"
- source: "https://x.com/AI_Jasonyu/status/123"
- author:
- - "@AI_Jasonyu"
- author_name: "鱼总聊AI"
- published: 2026-02-25
- created: 2026-02-26
- cover_image: "https://pbs.twimg.com/media/xxx.jpg"
- likes: 1075
- retweets: 315
- replies: 41
- bookmarks: 2180
- views: 426321
- tags:
- - "clippings"
- - "twitter"
- ---
- ```
- **小红书示例:**
- ```yaml
- ---
- title: "开学第一课还没思路的班主任看过来👀"
- source: "https://www.xiaohongshu.com/explore/69948f62..."
- author:
- - "墨客老师资料库"
- author_url: "https://www.xiaohongshu.com/user/profile/5eb416f..."
- published: 2026-02-18
- created: 2026-02-27
- cover_image: "https://sns-webpic-qc.xhscdn.com/..."
- likes: 179
- collects: 242
- comments: 28
- location: "福建"
- tags:
- - "开学第一课ppt"
- - "开学第一课"
- - "教师开学第一课"
- item_id: db22cbe3d9c0
- ---
- ```
- **GitHub 示例:**
- ```yaml
- ---
- title: "在 VSCode 中征服任何代码:一键注释、转换、UI 图生成代码、AI 批量处理文件!💪"
- source: "https://github.com/nicepkg/aide"
- author:
- - "nicepkg"
- published: 2024-07-03
- created: 2026-03-07
- description: "Conquer Any Code in VSCode..."
- stars: 2684
- forks: 207
- language: "TypeScript"
- license: "MIT"
- default_branch: "master"
- repo_created: "2024-07-02"
- repo_updated: "2026-03-06"
- last_push: "2025-05-06"
- readme_file: "README_CN.md"
- tags:
- - "agent"
- - "ai"
- item_id: 8f3a1b2c4d5e
- ---
- ```
- > 设置 `OBSIDIAN_VAULT` 后,内容会直接写入 Obsidian 笔记库对应的平台子目录。
- ## 安装
- ```bash
- # 从 GitHub 安装(推荐)
- pip install git+https://github.com/iBigQiang/feedgrab.git
- # 带隐身浏览器 + TLS 指纹(patchright + browserforge + curl_cffi — 推荐,反检测能力最强)
- pip install "feedgrab[stealth] @ git+https://github.com/iBigQiang/feedgrab.git"
- patchright install chromium
- # Twitter 搜索增强(x-client-transaction-id 反检测签名,x-so 命令必需)
- pip install "feedgrab[twitter] @ git+https://github.com/iBigQiang/feedgrab.git"
- # 小红书 API 增强(xhshow API 抓取,xhs-so 命令必需)
- pip install "feedgrab[xhs] @ git+https://github.com/iBigQiang/feedgrab.git"
- # 或使用 Playwright 兜底
- pip install "feedgrab[browser] @ git+https://github.com/iBigQiang/feedgrab.git"
- # 安装所有可选依赖
- pip install "feedgrab[all] @ git+https://github.com/iBigQiang/feedgrab.git"
- ```
- ### 快速开始
- 安装完成后,运行一键部署引导:
- ```bash
- feedgrab setup
- ```
- 按提示完成 5 个步骤:环境检查 → 配置文件 → UA 检测 → 平台登录 → 功能启用,即可开始使用。每步可跳过,重复运行自动跳过已完成项。
- ```
- 或克隆后本地安装:
- ```bash
- git clone https://github.com/iBigQiang/feedgrab.git
- cd feedgrab
- pip install -e ".[all]"
- patchright install chromium # 推荐(反检测更强)
- # 或: playwright install chromium
- ```
- ### 视频/音频依赖(可选)
- ```bash
- # macOS
- brew install yt-dlp ffmpeg
- # Linux
- pip install yt-dlp
- apt install ffmpeg
- ```
- Whisper 转录需要从 [Groq](https://console.groq.com/keys) 免费获取 API 密钥并设置:
- ```bash
- export GROQ_API_KEY=your_key_here
- ```
- ## 作为库使用
- ```python
- import asyncio
- from feedgrab.reader import UniversalReader
- async def main():
- reader = UniversalReader()
- content = await reader.read("https://mp.weixin.qq.com/s/abc123")
- print(content.title)
- print(content.content[:200])
- asyncio.run(main())
- ```
- ### 结构化 Service API
- 新客户端优先使用 `feedgrab.service.FetchService`。它复用现有 `UniversalReader`、Markdown 保存、媒体本地化和去重逻辑,但返回结构化 `FetchResult`,其中 `content` 是原有 `UnifiedContent`,`artifacts` 会记录本次生成的 Markdown 路径。
- ```python
- import asyncio
- from feedgrab.service import FetchService
- async def main():
- service = FetchService()
- result = await service.fetch_url("https://github.com/iBigQiang/feedgrab")
- print(result.content.title)
- for artifact in result.artifacts:
- print(artifact.kind, artifact.path)
- asyncio.run(main())
- ```
- CLI 命令仍保持原有行为;MCP 服务器也通过同一 service 层调用抓取能力。批量抓取和 MCP 调用会返回结构化失败项,不再因为单个 URL 失败吞掉整批结果;`FEEDGRAB_PROXY_*` 代理配置也在 service 设置层统一暴露。
- ## 配置
- 复制 `.env.example` 为 `.env`:
- ```bash
- cp .env.example .env
- ```
- | 变量 | 必需 | 说明 |
- |------|------|------|
- | `FEEDGRAB_LOG_LEVEL` | 否 | 日志级别:`INFO`(默认)/ `DEBUG` / `WARNING` |
- | `FEEDGRAB_PROXY_ENABLED` | 否 | 启用全局代理注入(默认:`false`) |
- | `FEEDGRAB_PROXY_URL` | 否 | HTTP / SOCKS5 代理地址,如 `http://127.0.0.1:7890` |
- | `FEEDGRAB_NO_PROXY` | 否 | 逗号分隔的不走代理地址,默认 `127.0.0.1,localhost`,避免本地 CDP/内部服务被代理 |
- | `X_AUTH_TOKEN` | 仅 X GraphQL | Twitter/X 认证 Cookie |
- | `X_CT0` | 仅 X GraphQL | Twitter/X CSRF 令牌 Cookie |
- | `X_GRAPHQL_ENABLED` | 否 | 启用/禁用 GraphQL 层(默认:`true`) |
- | `X_THREAD_MAX_PAGES` | 否 | 线程最大分页数(默认:`20`) |
- | `X_REQUEST_DELAY` | 否 | GraphQL 请求间隔秒数(默认:`1.5`) |
- | `X_FETCH_AUTHOR_REPLIES` | 否 | 采集作者回帖(默认:`false`) |
- | `X_FETCH_ALL_COMMENTS` | 否 | 采集全部评论(默认:`false`) |
- | `X_MAX_COMMENTS` | 否 | 最大评论采集数(默认:`50`) |
- | `X_BOOKMARKS_ENABLED` | 否 | 启用书签批量抓取(默认:`false`) |
- | `X_BOOKMARK_MAX_PAGES` | 否 | 书签最大分页数(默认:`50`) |
- | `X_BOOKMARK_DELAY` | 否 | 书签处理间隔秒数(默认:`2.0`) |
- | `X_USER_TWEETS_ENABLED` | 否 | 启用用户推文批量抓取(默认:`false`) |
- | `X_USER_TWEET_MAX_PAGES` | 否 | 用户推文最大分页数(默认:`50`) |
- | `X_USER_TWEET_DELAY` | 否 | 用户推文处理间隔秒数(默认:`2.0`) |
- | `X_USER_TWEETS_SINCE` | 否 | 仅抓取该日期之后的推文(如 `2025-10-01`,留空=全部) |
- | `X_LIST_TWEETS_ENABLED` | 否 | 启用 Twitter List 列表批量抓取(默认:`false`) |
- | `X_LIST_TWEETS_DAYS` | 否 | 抓取最近 N 天的推文(默认:`1`,支持 1/2/3/7) |
- | `X_LIST_TWEET_MAX_PAGES` | 否 | 列表推文最大分页数(默认:`50`) |
- | `X_LIST_TWEET_DELAY` | 否 | 列表推文处理间隔秒数(默认:`2`) |
- | `X_LIST_TWEETS_SUMMARY` | 否 | 列表抓取后生成汇总表格 MD + CSV(默认:`false`) |
- | `X_SEARCH_SUPPLEMENTARY` | 否 | 搜索补充开关,UserTweets 不够时自动按月搜索补充(默认:`true`) |
- | `X_SEARCH_MAX_PAGES_PER_CHUNK` | 否 | 每个月度搜索分片最大分页数(默认:`50`) |
- | `TWITTERAPI_IO_KEY` | 否 | TwitterAPI.io 付费 API Key,从 https://twitterapi.io 获取 |
- | `X_API_PROVIDER` | 否 | `graphql`(默认)或 `api`(全量走付费 API) |
- | `X_API_SAVE_DIRECTLY` | 否 | `true`=直接保存 API 数据 / `false`=GraphQL 补全(默认) |
- | `X_API_MIN_LIKES` | 否 | 最低点赞数过滤(留空=不过滤,三项 OR 关系) |
- | `X_API_MIN_RETWEETS` | 否 | 最低转发数过滤(留空=不过滤) |
- | `X_API_MIN_VIEWS` | 否 | 最低阅读量过滤(留空=不过滤) |
- | `FORCE_REFETCH` | 否 | 强制重新抓取,跳过去重并覆盖已有文件(默认:`false`) |
- | `X_SEARCH_ENABLED` | 否 | 启用 Twitter 关键词搜索(默认:`true`) |
- | `X_SEARCH_LANG` | 否 | 搜索默认语言(默认:`zh`;`zh+zxx` 同时覆盖中文普通推文和 Article 长文;留空=不限语言) |
- | `X_SEARCH_DAYS` | 否 | 搜索默认天数(默认:`1`,最近24小时) |
- | `X_SEARCH_MIN_FAVES` | 否 | 搜索默认最低点赞数(默认:`0`=不过滤) |
- | `X_SEARCH_SORT` | 否 | 搜索排序模式:`live`=最新 / `top`=热门 / `all`=Live+Top 合并去重(默认:`live`) |
- | `X_SEARCH_MAX_RESULTS` | 否 | 每次搜索最大推文数(默认:`100`) |
- | `X_SEARCH_SAVE_TWEETS` | 否 | 是否同时保存单篇推文 .md(默认:`false`,仅汇总表格) |
- | `X_SEARCH_MERGE_KEYWORDS` | 否 | 多关键词搜索时合并结果到一个文件(默认:`false`,也可用 `--merge` 开启) |
- | `XHS_USER_NOTES_ENABLED` | 否 | 启用小红书作者批量抓取(默认:`false`) |
- | `XHS_USER_NOTE_MAX_SCROLLS` | 否 | 作者主页最大滚动次数(默认:`50`) |
- | `XHS_USER_NOTE_DELAY` | 否 | 笔记处理间隔秒数(默认:`3.0`) |
- | `XHS_USER_NOTES_SINCE` | 否 | 仅抓取该日期之后的笔记(如 `2026-02-01`,留空=全部) |
- | `XHS_SEARCH_ENABLED` | 否 | 启用小红书搜索批量抓取(默认:`false`) |
- | `XHS_SEARCH_MAX_SCROLLS` | 否 | 搜索页最大滚动次数(默认:`30`) |
- | `XHS_SEARCH_DELAY` | 否 | 搜索笔记处理间隔秒数(默认:`3.0`) |
- | `XHS_API_ENABLED` | 否 | 启用 xhshow API 抓取(默认:`true`,已安装 xhshow 时自动生效) |
- | `XHS_PINIA_ENABLED` | 否 | xhshow 签名失败时自动通过 Pinia Store 注入兜底(默认:`true`) |
- | `XHS_API_DELAY` | 否 | API 请求间隔秒数(默认:`1.5`) |
- | `XHS_FETCH_COMMENTS` | 否 | 抓取笔记评论(默认:`false`) |
- | `XHS_MAX_COMMENTS` | 否 | 最大评论采集数(默认:`50`) |
- | `XHS_SEARCH_SORT` | 否 | xhs-so 搜索排序:`general`=综合 / `popular`=最热 / `latest`=最新(默认:`general`) |
- | `XHS_SEARCH_NOTE_TYPE` | 否 | xhs-so 搜索类型:`0`=全部 / `1`=视频 / `2`=图文(默认:`0`) |
- | `XHS_SEARCH_MAX_PAGES` | 否 | xhs-so 搜索最大分页数(默认:`5`) |
- | `XHS_SEARCH_MERGE_KEYWORDS` | 否 | 多关键词搜索时合并结果到一个文件(默认:`false`,也可用 `--merge` 开启) |
- | `MPWEIXIN_SOGOU_ENABLED` | 否 | 启用搜狗微信文章搜索(默认:`false`) |
- | `MPWEIXIN_SOGOU_MAX_RESULTS` | 否 | 每次搜索最大文章数(默认:`10`,最多 `100`) |
- | `MPWEIXIN_SOGOU_DELAY` | 否 | 文章处理间隔秒数(默认:`3.0`) |
- | `MPWEIXIN_ID_SINCE` | 否 | 按账号批量:仅抓取该日期之后的文章(`YYYY-MM-DD`,留空=全部) |
- | `MPWEIXIN_ID_DELAY` | 否 | 按账号批量:文章处理间隔秒数(默认:`3.0`) |
- | `MPWEIXIN_ZHUANJI_SINCE` | 否 | 按专辑批量:仅抓取该日期之后的文章(`YYYY-MM-DD`,留空=全部) |
- | `MPWEIXIN_ZHUANJI_DELAY` | 否 | 按专辑批量:文章处理间隔秒数(默认:`3.0`) |
- | `MPWEIXIN_FETCH_COMMENTS` | 否 | 抓取文章评论(实验性,默认:`false`,需微信客户端 session) |
- | `MPWEIXIN_MAX_COMMENTS` | 否 | 最大评论采集数(默认:`100`) |
- | `GITHUB_TOKEN` | 否 | GitHub personal access token(无 token 60 次/小时,有 token 5000 次/小时) |
- | `FEISHU_APP_ID` | 仅飞书 API | 飞书开放平台 App ID([申请地址](https://open.feishu.cn/app)) |
- | `FEISHU_APP_SECRET` | 仅飞书 API | 飞书开放平台 App Secret |
- | `FEISHU_DOWNLOAD_IMAGES` | 否 | 下载图片到本地 `attachments/{item_id}/` 子目录,每篇文档独立存放(默认:`false`) |
- | `FEISHU_WIKI_DELAY` | 否 | 知识库批量抓取间隔秒数(默认:`1.0`) |
- | `FEISHU_WIKI_SINCE` | 否 | 仅抓取此日期后修改的文档(`YYYY-MM-DD`,留空=全部) |
- | `FEISHU_CUSTOM_DOMAINS` | 否 | 私有化部署域名(逗号分隔,如 `feishu.mycompany.cn`) |
- | `FEISHU_PAGE_LOAD_TIMEOUT` | 否 | Playwright 页面元素等待超时毫秒(默认:`5000`) |
- | `FEISHU_CDP_ENABLED` | 否 | CDP 直连已打开的 Chrome 抓取飞书(需 `--remote-debugging-port=9222`,默认:`false`) |
- | `LINUXDO_CDP_ENABLED` | 否 | LinuxDo 优先复用已运行 Chrome 的 Cookie / Cloudflare 会话抓取 JSON(默认:`true`) |
- | `LINUXDO_PAGE_LOAD_TIMEOUT` | 否 | LinuxDo 浏览器页面等待超时毫秒(默认:`15000`) |
- | `LINUXDO_REPLY_MODE` | 否 | LinuxDo 回复抓取模式:`author`(默认,仅主贴 + 楼主自回)/ `all`(完整楼层)/ `none`(仅主贴) |
- | `IDCFLARE_CDP_ENABLED` | 否 | IDCFlare 优先复用已运行 Chrome 的 Cookie / Cloudflare 会话抓取 JSON(默认:`true`) |
- | `IDCFLARE_PAGE_LOAD_TIMEOUT` | 否 | IDCFlare 浏览器页面等待超时毫秒(默认:`15000`) |
- | `IDCFLARE_REPLY_MODE` | 否 | IDCFlare 回复抓取模式:`author`(默认,仅主贴 + 楼主自回)/ `all`(完整楼层)/ `none`(仅主贴) |
- | `REDDIT_REPLY_MODE` | 否 | Reddit 评论模式:`top`(默认,仅顶层)/ `tree`(初始嵌套树)/ `all`(额外 morechildren 展开) |
- | `REDDIT_RETRY_ATTEMPTS` | 否 | Reddit direct `.json` 429/5xx/网络错误重试次数(默认:`3`) |
- | `REDDIT_MAX_PAGES` | 否 | `reddit-so` / `reddit-sub` after cursor 最大分页数(默认:`5`) |
- | `REDDIT_MORECHILDREN_ROUNDS` | 否 | `REDDIT_REPLY_MODE=all` 时 morechildren 展开轮数(默认:`2`) |
- | `REDDIT_SEARCH_ENABLED` | 否 | 启用 Reddit 关键词搜索 `reddit-so`(默认:`true`) |
- | `REDDIT_SEARCH_SORT` | 否 | `reddit-so` 排序:`relevance` / `hot` / `top` / `new` / `comments`(默认:`relevance`) |
- | `REDDIT_SEARCH_TIME_RANGE` | 否 | `reddit-so` 时间范围:`all` / `year` / `month` / `week` / `day` / `hour`(默认:`all`) |
- | `REDDIT_SEARCH_LIMIT` | 否 | `reddit-so` 默认结果数(默认:`10`) |
- | `REDDIT_SEARCH_SAVE_POSTS` | 否 | `reddit-so` 搜索后逐篇深抓单帖(默认:`false`) |
- | `REDDIT_SEARCH_SUBREDDIT` | 否 | `reddit-so` 默认限定子版块,留空=全站 |
- | `CHROME_CDP_LOGIN` | 否 | 启用 CDP Cookie 提取,`feedgrab login` 优先从运行中的 Chrome 提取(默认:`false`) |
- | `CHROME_CDP_PORT` | 否 | Chrome CDP 端口(默认:`9222`) |
- | `X_DOWNLOAD_MEDIA` | 否 | Twitter 图片/视频下载到本地 `attachments/` 子目录(默认:`false`) |
- | `XHS_DOWNLOAD_MEDIA` | 否 | 小红书图片下载到本地 `attachments/` 子目录(默认:`false`) |
- | `MPWEIXIN_DOWNLOAD_MEDIA` | 否 | 微信公众号视频下载到本地 `attachments/` 子目录(默认:`false`) |
- | `BROWSER_USER_AGENT` | 否 | 全局浏览器 UA(推荐 `feedgrab detect-ua` 自动检测) |
- | `TG_API_ID` | 仅 Telegram | 从 https://my.telegram.org 获取 |
- | `TG_API_HASH` | 仅 Telegram | 从 https://my.telegram.org 获取 |
- | `GROQ_API_KEY` | 仅 Whisper | 从 https://console.groq.com/keys 免费获取 |
- | `GEMINI_API_KEY` | 仅 AI 分析 | 从 Google AI Studio 获取 |
- | `FEEDGRAB_DATA_DIR` | 否 | Cookie/Session 存储目录(默认:`sessions`) |
- | `OUTPUT_DIR` | 否 | Markdown 输出目录(默认:`./output`) |
- | `OBSIDIAN_VAULT` | 否 | Obsidian 笔记库路径(内容写入对应平台子目录) |
- ## 架构
- ```
- feedgrab/
- ├── feedgrab/ # Python 包
- │ ├── cli.py # CLI 入口
- │ ├── config.py # 集中配置(路径、开关、stealth headers)
- │ ├── reader.py # URL 调度器(UniversalReader)
- │ ├── schema.py # 统一数据模型(UnifiedContent + Inbox)
- │ ├── login.py # 浏览器登录管理器(+ CDP Cookie 提取)
- │ ├── fetchers/
- │ │ ├── jina.py # Jina Reader(万能兜底)
- │ │ ├── browser.py # 隐身浏览器引擎(patchright Tier 1 → playwright Tier 3 + 52 stealth flags)
- │ │ ├── bilibili.py # B 站 API
- │ │ ├── youtube.py # yt-dlp 字幕提取
- │ │ ├── github.py # GitHub REST API(仓库元数据 + 中文 README 优先 + 子目录搜索 + 图片链接补全)
- │ │ ├── linuxdo.py # LinuxDo / Discourse 论坛抓取(JSON API → CDP → 浏览器 → Jina)
- │ │ ├── idcflare.py # IDCFlare / Discourse 论坛抓取(JSON API → CDP → 浏览器 → Jina)
- │ │ ├── rss.py # RSS 解析(feedparser)
- │ │ ├── telegram.py # Telegram 频道(Telethon)
- │ │ ├── twitter.py # X/Twitter 六级兜底调度器
- │ │ ├── twitter_cookies.py # Cookie 多源管理(环境变量/文件/Playwright/CDP)
- │ │ ├── twitter_fxtwitter.py # FxTwitter API 客户端(Tier 0.3 兜底 + circuit breaker)
- │ │ ├── twitter_graphql.py # X GraphQL API 客户端(TweetDetail, UserTweets, Bookmarks, SearchTimeline, 动态 queryId + x-client-transaction-id)
- │ │ ├── twitter_thread.py # 线程重建 + 评论分类(分页 + 去重 + 根推文追溯)
- │ │ ├── twitter_bookmarks.py# 书签批量抓取(全部/文件夹,分页+去重+分类)
- │ │ ├── twitter_user_tweets.py# 用户推文批量抓取(分页+日期过滤+会话去重+RT跳过)
- │ │ ├── twitter_list_tweets.py# List 列表批量抓取(按天数过滤+会话去重+线程深度抓取)
- │ │ ├── twitter_search_tweets.py# 浏览器搜索补充(突破 UserTweets 800 条限制,按月分片+响应拦截)
- │ │ ├── twitter_keyword_search.py# 关键词搜索(x-so 命令,纯 GraphQL + 互动排序汇总表格)
- │ │ ├── twitter_api.py # TwitterAPI.io 付费 API 客户端(搜索+用户推文)
- │ │ ├── twitter_api_user_tweets.py# 付费 API 补充/全量抓取(替代浏览器搜索)
- │ │ ├── twitter_markdown.py# 线程 Markdown 渲染器(YAML front matter + 媒体)
- │ │ ├── wechat.py # Jina → Playwright WeChat JS 提取
- │ │ ├── wechat_search.py # 搜狗微信搜索(markdownify 富文本转换)
- │ │ ├── mpweixin_account.py # 公众号按账号批量(MP 后台 API + 断点续传)
- │ │ ├── mpweixin_album.py # 公众号专辑批量(mpweixin-zhuanji + 断点续传)
- │ │ ├── xhs.py # API (xhshow) → Pinia Store 注入 → Jina → Playwright 四级兜底
- │ │ ├── xhs_api.py # 小红书 API 客户端(xhshow 签名 + 评论 + xsec_token 缓存)
- │ │ ├── xhs_pinia.py # 小红书 Pinia Store 注入(浏览器原生请求兜底,CDP 优先)
- │ │ ├── xhs_user_notes.py # 小红书作者批量抓取(API → Pinia → 浏览器三层策略)
- │ │ ├── xhs_search_notes.py# 小红书搜索批量抓取(xhs-so API/Pinia 搜索 + 搜索结果页滚动)
- │ │ ├── feishu.py # 飞书单篇(Open API → CDP 直连 → Playwright PageMain → Jina + Block→MD + 图片下载)
- │ │ ├── feishu_wiki.py # 飞书知识库批量(Open API 递归 + 虚拟目录树/CDP/Playwright 兜底 + 断点续传)
- │ │ └── kdocs.py # 金山文档单篇(Playwright ProseMirror DOM + 虚拟滚动 + CDP 直连)
- │ └── utils/
- │ ├── storage.py # 按平台分目录 Markdown + JSON 双重输出
- │ ├── dedup.py # 全局去重索引(跨模式统一 item_id 追踪)
- │ ├── http_client.py # 统一 HTTP 客户端(curl_cffi TLS 指纹 → requests fallback)
- │ └── media.py # 媒体文件下载(Twitter/XHS 图片视频本地化)
- ├── sessions/ # Cookie/Session 存储(自动创建,git 忽略)
- ├── skills/ # Claude Code 技能(npx skills add iBigQiang/feedgrab)
- │ ├── feedgrab/ # 核心抓取 — /feedgrab <URL>
- │ ├── feedgrab-batch/ # 批量抓取 — /feedgrab-batch
- │ ├── feedgrab-setup/ # 安装引导 — /feedgrab-setup
- │ ├── video/ # 视频/播客 → 转录 + 摘要
- │ └── analyzer/ # 内容 → 结构化分析
- ├── mcp_server.py # MCP 服务器入口
- └── pyproject.toml
- ```
- ## 各层级协作方式
- ```
- 用户发送 URL
- │
- ├─ 文本内容(文章、推文、微信)
- │ └─ Python 抓取器 → UnifiedContent → Markdown
- │
- ├─ X/Twitter 推文或线程
- │ └─ GraphQL(完整线程 + 媒体)→ FxTwitter → Syndication → oEmbed → Jina → Playwright
- │
- ├─ GitHub 仓库
- │ └─ REST API → 仓库元数据 + 中文 README 优先(根目录 + 子目录语言链接)→ 相对图片补全 → Markdown
- │
- ├─ 视频(YouTube、B站、X 视频)
- │ ├─ Python 抓取器 → 元数据(标题、描述)
- │ └─ Video 技能 → 通过字幕/Whisper 生成完整转录
- │
- ├─ 播客(小宇宙、Apple Podcasts)
- │ └─ Video 技能 → 通过 Whisper 生成完整转录
- │
- └─ 需要分析
- └─ Analyzer 技能 → 结构化报告 + 行动建议
- ```
- ## 致谢
- feedgrab 由以下两个项目融合为起点、一路迭代升级而来,继承了 x-reader 的多平台架构,并融合了 baoyu-danger-x-to-markdown 对 X/Twitter GraphQL 的深度抓取能力:
- - **[x-reader](https://github.com/runesleo/x-reader)**:由 [@runes_leo](https://x.com/runes_leo) 开发的多平台万能内容阅读器,提供了核心架构、CLI、MCP 服务器和 7+ 平台的抓取器。
- - **[baoyu-danger-x-to-markdown](https://github.com/JimLiu/baoyu-skills/tree/main/skills/baoyu-danger-x-to-markdown)**:由 [@dotey](https://x.com/dotey)(宝玉)开发的 X/Twitter 深度抓取技能,提供了逆向工程的 GraphQL API 访问、线程重建和 Markdown 渲染能力。
- ## 作者
- 由 [@iBigQiang](https://github.com/iBigQiang) 维护
- ## 捐赠打赏
- 如果 feedgrab 对你有帮助,欢迎请作者喝杯咖啡 :)
- <p align="center">
- <img src="docs/Payment_QR_code.png" alt="打赏码" width="600">
- </p>
- ## 许可证
- MIT
- ## Star History
- [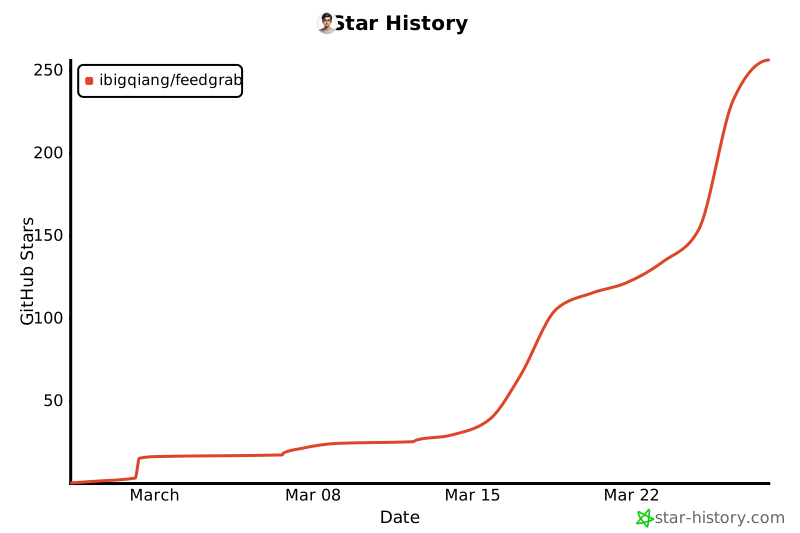](https://star-history.com/#iBigQiang/feedgrab&Date)
Ratings and comments
Sign in to rate this skill.
Sign inFree to use. If it’s helped, pass it on.