boss-zhipin-scraper
"Scrape BOSS直聘 (job listing site) via Chrome CDP. Searches jobs by keyword/city/filters, fetches JD details, outputs structured JSON/CSV with plaintext salary, and can summarize scraped results into a job-market prompt. Optional --company locally filters results by company name (boss_name substring) with no extra request. Use when user wants to search/analyze jobs on BOSS直聘 or zhipin.com."
Safety scan
A static text scan, not a guarantee. Select the badge to see what was scanned and every finding.
Badge for your README

Markdown
[](/listings/eatmoreduck-boss-zhipin-scraper)HTML
<a href="/listings/eatmoreduck-boss-zhipin-scraper"><img src="/api/listings/eatmoreduck-boss-zhipin-scraper/badge.svg" alt="findsafeskills safety rating" /></a>Install
Install instructions from the README
As written by the repo's author. findsafeskills has not verified these steps.
方式 1:克隆到本地再安装(推荐)
由于 `hermes skills install` 的网络请求在某些环境下可能无法直接访问 GitHub,推荐先克隆仓库再本地安装:
# 1. 克隆仓库
git clone https://github.com/eatmoreduck/boss-zhipin-scraper.git
cd boss-zhipin-scraper

# 2. 复制到 Hermes skills 目录
mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts
cp SKILL.md ~/.hermes/skills/data-science/boss-zhipin-scraper/
cp scripts/boss_cdp_raw.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
cp scripts/job_summary.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data
cp data/city_codes.json ~/.hermes/skills/data-science/boss-zhipin-scraper/data/
方式 2:curl 一键安装
不需要克隆整个仓库,直接下载必要文件:
mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts && \
curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/SKILL.md \
  -o ~/.hermes/skills/data-science/boss-zhipin-scraper/SKILL.md && \
curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/boss_cdp_raw.py \
  -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/boss_cdp_raw.py && \
curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/job_summary.py \
  -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/job_summary.py && \
mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data && \
curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/data/city_codes.json \
  -o ~/.hermes/skills/data-science/boss-zhipin-scraper/data/city_codes.json
方式 3:hermes skills install(需网络直连 GitHub)
hermes skills install https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/SKILL.md --category data-science
> 注意:此方式依赖 hermes 进程能直接访问 GitHub,如果遇到超时或连接失败,请使用方式 1 或 2。
方式 4:skills.sh 一键安装(Claude Code 等 Agent Skills 兼容 agent)
npx skills add eatmoreduck/boss-zhipin-scraper
[skills.sh](https://skills.sh) 已收录本技能。任何支持 Agent Skills 格式的 agent(Claude Code、Codex、Gemini CLI、Cursor 等)都可以用这条命令安装,SKILL.md、脚本和城市码表随技能一起分发,按提示选择要安装到哪个 agent 即可。
方式 5:ClawHub 安装(OpenClaw / clawhub CLI)
本技能已上架 [ClawHub](https://clawhub.ai)(OpenClaw 生态的技能注册表),OpenClaw 用户可一条命令安装:
npx clawhub@latest install @eatmoreduck/boss-zhipin-scraper
方式 6:作为 Python 包安装(pip / uv)
不装技能、当命令行工具用:直接从 Git tag 或 Release 页安装(不上 PyPI,依赖自动从 PyPI 解析),装完即有 `boss-scraper` / `boss-summary` 命令:
# 指定版本(git tag)
pip install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
# 永远装最新 Release(固定 URL,版本以 wheel 元数据为准)
pip install https://github.com/eatmoreduck/boss-zhipin-scraper/releases/latest/download/boss_zhipin_scraper-latest-py3-none-any.whl
# uv(推荐,全局命令)
uv tool install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
完整用法见下文[「作为命令行工具使用」](#作为命令行工具使用)。
验证安装
# 检查文件是否存在
ls ~/.hermes/skills/data-science/boss-zhipin-scraper/SKILL.md
ls ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/boss_cdp_raw.py
ls ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/job_summary.py
ls ~/.hermes/skills/data-science/boss-zhipin-scraper/data/city_codes.json
安装后直接在 Hermes 对话中说"帮我搜一下 BOSS直聘 上上海的 AI Agent 岗位"。
What was scanned
The files the safety scan read, as written by the repository's author and shown as plain text. Lines with a finding are marked.
SKILL.md · Manifest · 303 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
- ---
- name: boss-zhipin-scraper
- description: "Scrape BOSS直聘 (job listing site) via Chrome CDP. Searches jobs by keyword/city/filters, fetches JD details, outputs structured JSON/CSV with plaintext salary, and can summarize scraped results into a job-market prompt. Optional --company locally filters results by company name (boss_name substring) with no extra request. Use when user wants to search/analyze jobs on BOSS直聘 or zhipin.com."
- version: 2.4.0
- author: eatmoreduck
- license: MIT
- platforms: [macos, linux]
- metadata:
- hermes:
- tags: [scraper, jobs, career, cdp, chrome, zhipin, boss直聘]
- ---
- # BOSS直聘职位抓取工具 v2.3
- 通过 Chrome CDP 协议抓取 BOSS直聘 (zhipin.com) 职位数据,输出结构化 JSON/CSV(含明文薪资),并可对已抓取结果生成聚合摘要和求职材料优化提示词。
- ## 前置条件
- - Chrome 浏览器已安装
- - Python 3.10+
- - 用户已登录 zhipin.com(或愿意手动登录)
- ## 脚本位置
- 本 skill 的脚本在 skill 目录下:
- - `scripts/boss_cdp_raw.py`:抓取主脚本
- - `scripts/job_summary.py`:抓取后摘要和提示词脚本
- **运行任何命令前,必须先确定脚本的绝对路径。**
- 用以下方式找到脚本(macOS 自带的 `readlink` 不支持 `-f`,用 Python 解析路径更通用):
- ```bash
- # 方法 1:已知 skill 安装目录(推荐,macOS/Linux 通用)
- SKILL_DIR="$(python3 -c "import os,sys;print(os.path.dirname(os.path.realpath(sys.argv[1])))" "$0")"
- SCRIPT_PATH="$SKILL_DIR/scripts/boss_cdp_raw.py"
- SUMMARY_PATH="$SKILL_DIR/scripts/job_summary.py"
- # 方法 2:搜索 hermes skills 目录
- SCRIPT_PATH=$(find ~/.hermes/skills -name "boss_cdp_raw.py" -type f 2>/dev/null | head -1)
- SUMMARY_PATH=$(find ~/.hermes/skills -name "job_summary.py" -type f 2>/dev/null | head -1)
- ```
- 如果找不到脚本,说明 skill 未正确安装,需要重新安装。
- ## 依赖安装(首次使用必须执行)
- 脚本依赖 `websocket-client` 和 `requests`。在用户项目的 venv 中安装:
- ```bash
- uv add websocket-client requests
- # 或
- pip install websocket-client requests
- ```
- ## 自动化流程
- 当用户要求搜索/抓取 BOSS直聘 职位时,**严格按以下顺序执行**:
- ### 第 1 步:检查环境
- ```bash
- python3 "$SCRIPT_PATH" --check --cdp-port 9222
- ```
- 检查三项:Python 依赖 → CDP 连通性 → 登录态。
- - **全部通过** → 跳到第 3 步
- - **CDP 不通** → 继续第 2 步
- - **依赖缺失** → 先装依赖(见上方依赖安装),再重新 --check
- - **未登录** → 告诉用户打开 Chrome 登录 zhipin.com,然后重新 --check
- ### 第 2 步:启动专用浏览器 CDP(仅在 --check CDP 不通时)
- ```bash
- python3 "$SCRIPT_PATH" --setup-chrome --cdp-port 9222
- ```
- 这会自动完成:
- 1. 创建或复用持久隔离 Chrome profile
- - `~/.boss-zhipin-scraper/chrome-profile`
- 2. 只关闭使用该隔离 profile 的旧 BOSS CDP Chrome,不关闭用户主 Chrome
- 3. 以 CDP 模式启动 Chrome(`--remote-debugging-port=9222`)
- 4. 等待 CDP 端口就绪(最多 30 秒)
- 5. 打开 BOSS 登录页并等待登录完成,直到搜索接口返回明文 `salaryDesc`
- 默认不复制主 Chrome 的 Cookie、密码、历史记录或扩展;首次启动和后续重复启动都只是创建或复用该专用 profile。首次使用时告诉用户:请在弹出的 BOSS 专用 Chrome 浏览器中访问 zhipin.com 并登录。脚本会等待登录完成并确认接口能返回明文薪资。该专用 profile 是持久目录,机器重启后登录态仍保留,重复运行 `--setup-chrome` 不会清空它。
- 仅装 Microsoft Edge(未装 Chrome)的机器,可改用 Edge 启动(与 `--setup-chrome` 共用同一隔离 profile):
- ```bash
- python3 "$SCRIPT_PATH" --setup-edge --cdp-port 9222
- ```
- 仅当用户明确要求从主浏览器手动导入 BOSS 登录态时,可使用:
- ```bash
- python3 "$SCRIPT_PATH" --setup-chrome --copy-login-state --cdp-port 9222
- ```
- `--copy-login-state` 在 `--setup-chrome` 下从主 Chrome 导入、在 `--setup-edge` 下从主 Edge 导入,每次运行都会覆盖隔离 profile 内对应的 Cookie 相关文件;日常启动不要加这个参数。它只复制 `Local State` 和 `Default/Cookies*`、`Default/Network/Cookies*` 这类 Cookie 数据库相关文件,不复制密码库或完整 profile。不要默认使用该参数,也不要告诉用户首次启动会自动导入主浏览器登录态。
- 等用户确认后,重新运行 `--check` 验证。
- ### 第 3 步:运行抓取
- ```bash
- # 基础搜索
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 城市 --pages 3 --output ~/.boss-zhipin-scraper/job-result/jobs.json
- # 带 CSV 输出
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 城市 --pages 3 --format csv --output ~/.boss-zhipin-scraper/job-result/jobs.json
- # 带详情 + 分析报告
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 城市 --pages 3 --detail --max-details 8 --analysis --format csv --output ~/.boss-zhipin-scraper/job-result/jobs.json
- # 抓取后摘要 + 求职材料优化提示词(默认读取最新抓取结果)
- python3 "$SUMMARY_PATH" --top 15
- # 真实浏览器/API smoke test(不写结果文件)
- python3 "$SCRIPT_PATH" --smoke-test --cdp-port 9222
- # 合并多次抓取(去重)
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 北京 --pages 3 --merge ~/.boss-zhipin-scraper/job-result/jobs.json --output ~/.boss-zhipin-scraper/job-result/jobs_merged.json
- # 按公司名本地过滤(boss_name 子串,不额外请求;多家用逗号分隔)
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 上海 --pages 3 --company "字节跳动,阿里巴巴" --analysis
- # 对已有结果按公司做摘要
- python3 "$SUMMARY_PATH" --company "字节跳动,SHEIN" --top 15
- ```
- 默认输出到 `~/.boss-zhipin-scraper/job-result/` 目录,`--format csv` 会给列表和详情都额外生成 `.csv` 文件。`--smoke-test` 只验证真实 Chrome/CDP 能否拿到 API 明文薪资,不写结果文件。
- 抓取结束后专用 Chrome 不会自动关闭(默认保留登录态,方便连跑多条)。确认不再使用时收尾:
- ```bash
- # 关闭 BOSS 专用 Chrome(只关隔离 profile,不碰主 Chrome)
- python3 "$SCRIPT_PATH" --stop-chrome --cdp-port 9222
- # 或:让本次抓取正常结束就自动关闭
- python3 "$SCRIPT_PATH" --keyword "关键词" --city 城市 --pages 3 --close-chrome
- ```
- `--stop-chrome` 按 `--user-data-dir` 精准匹配,绝不按端口/进程名 kill,因此不会误伤用户主 Chrome。`--close-chrome` 默认关闭,且只在抓取成功路径触发,异常/登录失败不关闭以保留登录态。
- 摘要脚本只读取 `boss_jobs_*.json` 和 `boss_details_*.json`,不读取本地简历文件,不引入 PDF 依赖,也不给个人与岗位做分数判断。需要指定文件时使用:
- ```bash
- python3 "$SUMMARY_PATH" \
- --input ~/.boss-zhipin-scraper/job-result/boss_jobs_20260625_1200.json \
- --details ~/.boss-zhipin-scraper/job-result/boss_details_20260625_1200.json \
- --top 15
- ```
- ## 参数速查
- | 参数 | 默认值 | 说明 |
- |------|--------|------|
- | `--keyword` | AI Agent | 搜索关键词 |
- | `--city` | 上海 | 城市名(中文)或 9 位代码;没传时默认上海,无法识别的城市名会报错退出 |
- | `--company` | - | 按公司名本地过滤(`boss_name` 子串,逗号或顿号分隔多家,不区分大小写)。不改搜索请求;过滤在 `--merge` 之后、详情与分析之前。`is_new` 自动基准同时要求公司过滤条件一致。`job_summary.py` 接受同一参数 |
- | `--pages` | 3 | 抓取页数(上限 20,每页 15 条) |
- | `--output` | ~/.boss-zhipin-scraper/job-result/... | 列表输出路径 |
- | `--detail-output` | ~/.boss-zhipin-scraper/job-result/... | 详情输出路径 |
- | `--format` | json | 输出格式: json / csv;csv 同时导出列表和详情 CSV |
- | `--detail` | 开启(默认) | 抓取详情页 JD |
- | `--no-detail` | - | 不抓取详情页(关闭默认行为) |
- | `--max-details` | 全部 | 详情页数量上限 |
- | `--analysis` | 关闭 | 输出分析报告 |
- | `--allow-dom-fallback` | 关闭 | API 无数据时允许降级 DOM 提取;默认关闭,薪资可能不可信 |
- | `--merge FILE` | - | 合并已有 JSON(按 job_id 去重) |
- | `--cdp-port` | 9222 | CDP 端口 |
- | `--setup-chrome` | 关闭 | 一键启动 Chrome CDP(持久隔离 profile) |
- | `--setup-edge` | 关闭 | 一键启动 Microsoft Edge CDP(与 `--setup-chrome` 共用隔离 profile) |
- | `--browser` | chrome | 搭配 `--setup-chrome` 选择浏览器(chrome/edge);与 `--setup-edge` 显式冲突时以 `--setup-edge` 为准并提示 |
- | `--copy-login-state` | 关闭 | 手动导入主浏览器(`--setup-chrome` 取主 Chrome、`--setup-edge` 取主 Edge)的 Local State + Cookie 相关文件到隔离 profile;默认、首次启动、重复启动都不复制 |
- | `--reset-chrome-profile` | 关闭 | 重建 BOSS 专用 profile,会清除此专用浏览器登录态 |
- | `--no-wait-login` | 关闭 | `--setup-chrome` 启动后不等待 BOSS 登录完成 |
- | `--login-timeout` | 300 | `--setup-chrome` 等待登录完成的秒数 |
- | `--stop-chrome` | 关闭 | 关闭 BOSS 专用 CDP Chrome(按隔离 profile 精准匹配,不碰主 Chrome) |
- | `--stop-edge` | 关闭 | 关闭 BOSS 专用浏览器 CDP(与 `--stop-chrome` 共用隔离 profile) |
- | `--close-chrome` | 关闭 | 抓取正常结束后自动关闭专用 Chrome(默认不关;异常退出不触发,保留登录态) |
- | `--check` | 关闭 | 环境检查 |
- | `--smoke-test` | 关闭 | 真实 Chrome/CDP 搜索 API smoke test,不写结果文件 |
- | `--version` | - | 查看版本号 |
- ### 筛选参数
- | 参数 | 值 |
- |------|-----|
- | `--scale` | 301=0-20人 302=20-99 303=100-499 304=500-999 305=1000-9999 306=10000+ |
- | `--salary` | 402=3K以下 403=3-5K 404=5-10K 405=10-20K 406=20-50K 407=50K+ |
- | `--experience` | 108=在校生 102=应届生 101=经验不限 103=1年内 104=1-3年 105=3-5年 106=5-10年 107=10年+ |
- | `--degree` | 209=初中及以下 208=中专/中技 206=高中 202=大专 203=本科 204=硕士 205=博士 |
- ### 城市代码
- 全国 100010000 | 北京 101010100 | 上海 101020100 | 广州 101280100 | 深圳 101280600 | 杭州 101210100 | 成都 101270100 | 武汉 101200100 | 南京 101190100 | 厦门 101230200
- ## 输出格式
- ### JSON
- ```json
- {
- "keyword": "AI Agent",
- "city": "上海",
- "total": 60,
- "jobs": [
- {
- "job_id": "c4420e8bce3a6e25",
- "title": "AI Agent工程师",
- "salary": "30-60K·15薪",
- "location": "上海·闵行区·虹桥",
- "tags": "5-10年 | 本科",
- "boss_name": "SHEIN",
- "boss_title": "招聘者",
- "company_scale": "10000人以上",
- "company_stage": "D轮及以上",
- "company_industry": "电子商务",
- "skills": "Java | Spring | AI",
- "job_link": "https://www.zhipin.com/job_detail/xxx.html",
- "company_link": "https://www.zhipin.com/gongsi/xxx.html",
- "welfare": "节日福利 | 零食下午茶 | 定期体检"
- }
- ]
- }
- ```
- ### CSV
- `--format csv` 时自动在同目录生成 `.csv` 文件:列表 CSV 跟随 `--output`,详情 CSV 跟随 `--detail-output` 或默认详情 JSON 路径。CSV 使用 UTF-8 BOM 编码,Excel 直接打开无乱码。
- ## 工作原理
- 1. 通过 Chrome DevTools Protocol (CDP) 连接到已打开的 Chrome 浏览器
- 2. 在 BOSS直聘页面内注入 JS,用同步 XHR 调用 `/wapi/zpgeek/search/joblist.json` API
- 3. API 返回明文 `salaryDesc`(如 `30-60K·15薪`),绕过前端字体反爬
- 4. 列表 API 保留 `securityId` / `lid` 等上下文,进入详情页时带上这些参数
- 5. 默认禁用 DOM fallback,避免把字体反爬后的薪资写入结果;只有显式 `--allow-dom-fallback` 才降级
- 6. 每页 30 条,每页抓完立即写入文件,异常退出不丢数据
- 7. 按 `job_id`(job_link 的 MD5 哈希前 16 位)去重
- ## 数据安全策略
- `--setup-chrome` 默认使用持久隔离 profile,不软链接、不读取、不复制主 Chrome profile。首次启动和后续重复启动都只会创建或复用 `~/.boss-zhipin-scraper/chrome-profile`,不会清空其中的 BOSS 登录态。setup 会等待登录完成,并用多组关键词/城市 probe,要求搜索接口返回明文薪资;如果一直拿不到 `salaryDesc`,不要继续抓取并把 DOM 薪资当成可信数据。这样 CDP 只暴露 BOSS 专用浏览器里的数据,不影响用户主 Chrome、Gmail、GitHub 等账号。
- `--input ... --analysis --no-detail` 会优先加载 `--detail-output`,其次加载与输入列表同目录、同时间戳的 `boss_details_*.json`,最后查找 `~/.boss-zhipin-scraper/job-result` 下最新详情文件。
- 需要清空 BOSS 专用浏览器登录态时使用:
- ```bash
- python3 "$SCRIPT_PATH" --setup-chrome --reset-chrome-profile --cdp-port 9222
- ```
- ## 常见问题
- 1. **--check CDP 不通** → 运行 `--setup-chrome`
- 2. **--check 未登录** → 在专用 Chrome 中访问 zhipin.com 登录,或重新运行 `--setup-chrome`
- 3. **薪资空白** → 通常是未登录、登录态失效或接口未返回 `salaryDesc`;先重新登录,不要优先做字体解密或 DOM fallback
- 4. **抓取中断** → 重新运行即可,增量写入 + 自动去重
- 5. **端口占用** → `--cdp-port 9223` 换端口
- 6. **Chrome 启动失败** → `--cdp-port 9223` 换端口,或用 `--reset-chrome-profile` 重建专用 profile
- ## 注意事项
- - 仅用于个人求职研究
- - 单次最多 20 页(300 条),防封号
- - 翻页间隔 12-22 秒随机延迟,3 页约 1 分钟
- - 详情页每条 10-25 秒,10 条约 3-5 分钟
- - BOSS直聘可能更新 API 路径,失效时需更新脚本中 `API_JOB_LIST_PATH` 常量
- ## 安装本 Skill
- 本 Skill 需手动安装到 Hermes skills 目录(`hermes skills install` 因网络问题可能失败):
- ```bash
- # 推荐:curl 一键安装
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/SKILL.md \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/SKILL.md && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/boss_cdp_raw.py \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/boss_cdp_raw.py && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/job_summary.py \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/job_summary.py && \
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/data/city_codes.json \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/data/city_codes.json
- ```
- 或克隆后手动复制:
- ```bash
- git clone https://github.com/eatmoreduck/boss-zhipin-scraper.git
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts
- cp boss-zhipin-scraper/SKILL.md ~/.hermes/skills/data-science/boss-zhipin-scraper/
- cp boss-zhipin-scraper/scripts/boss_cdp_raw.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
- cp boss-zhipin-scraper/scripts/job_summary.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data
- cp boss-zhipin-scraper/data/city_codes.json ~/.hermes/skills/data-science/boss-zhipin-scraper/data/
- ```
README.md · README · 392 lines
View this file on GitHub (read at the repository's current version: the scan did not record which commit it read)
- # BOSS直聘爬虫 · 职位抓取工具 v2.4(Chrome/Edge CDP / 明文薪资)
- > 🌐 English documentation: [README.en.md](./README.en.md)
- 
- 
- 
- 
- 一个轻量的 **BOSS直聘爬虫(spider / crawler / scraper)**:通过 Chrome DevTools Protocol 连接本地已登录的 Chrome 或 Microsoft Edge,复用真实登录态调用 zhipin.com 搜索 API,绕过前端字体反爬,输出含**明文薪资**的职位数据(JSON / CSV),并生成薪资分布、技能词频和求职材料优化提示词。同时作为 Hermes Agent Skill 提供。
- > 📌 **一句话介绍**:不用 Selenium/Playwright,直接通过 Chrome DevTools Protocol 连接本地已登录的 Chrome,复用真实登录态调搜索 API,输出含明文薪资的 JSON/CSV,并生成薪资分布、技能词频和求职材料优化提示词。
- 
- ---
- ## ⚠️ 免责声明
- 本项目仅供学习和技术研究参考,旨在探讨 Chrome DevTools Protocol、前端反爬机制与数据采集技术。请勿用于任何违反 [BOSS直聘用户协议](https://www.zhipin.com/about/protocol.html) 或相关法律法规的用途,不得用于商业转售、恶意爬取或对目标网站造成负担的行为。使用本项目所产生的一切后果由使用者自行承担,作者不对任何滥用行为负责。
- ---
- ## 🚀 30 秒快速开始
- ```bash
- # 1. 克隆 + 装依赖
- git clone https://github.com/eatmoreduck/boss-zhipin-scraper.git
- cd boss-zhipin-scraper
- pip install -r requirements.txt # 或 uv sync
- # 2. 启动隔离 Chrome 并登录(只需一次,登录态持久保存)
- python3 scripts/boss_cdp_raw.py --setup-chrome
- # 也可以显式使用 Microsoft Edge:
- # python3 scripts/boss_cdp_raw.py --setup-edge
- # 3. 抓取 + 分析
- python3 scripts/boss_cdp_raw.py --keyword "AI Agent" --city 上海 --pages 3 --analysis
- # 支持全国城市(含三四五线),例如:
- python3 scripts/boss_cdp_raw.py --keyword "前端" --city 赣州 --pages 3
- # 查看支持的城市:--list-cities [关键词]
- python3 scripts/boss_cdp_raw.py --list-cities 江
- # 4. 抓取后生成聚合摘要 + 提示词(默认读取最新结果)
- python3 scripts/job_summary.py
- ```
- 抓完直接拿到:薪资分布、经验要求、高频技能词、求职材料优化提示词。提示词只基于岗位数据,不读取本地简历文件,也不给岗位算个人匹配分。
- ## ✨ 特性
- - 明文薪资(API 模式,绕过字体反爬)
- - Boss 活跃状态独立字段(`boss_active_status`):列表兼容 `bossOnline`→「在线」,详情可得到「刚刚活跃」等更细状态
- - 跨轮新增标记(`is_new`):每条岗位带布尔字段标识「是否为本次新增」(终端同步以 🆕 显示),基准自动取同关键词同城市、公司过滤条件一致、日期早于本轮的最近一份结果;未使用 `--company` 时仍与旧结果(无公司过滤)对比;同一天多轮抓取折叠为一轮,`--diff-base` 可显式指定
- - 按公司名本地过滤(`--company`):抓取完成后按 `boss_name` 做子串匹配,只保留目标公司;不改搜索请求、不额外发请求
- - JSON / CSV 双格式输出
- - 详情页 JD 抓取 + 技能分析
- - 抓取后聚合摘要 + 可复制提示词
- - 增量写入(异常退出不丢数据)
- - 一键环境检查 + 持久隔离 Chrome/Chromium CDP profile
- - 多维筛选(规模、融资、薪资、经验、学历、行业)
- - macOS + Linux + Windows 支持;macOS 会自动探测 Google Chrome 或 Chromium;Windows 已通过单元测试与基础 CLI 验证(GBK 控制台崩溃已修复),并支持 Chrome 或 Microsoft Edge CDP;真实抓取链路仍欢迎反馈
- <details>
- <summary>🔍 为什么不选 Selenium / Playwright 类爬虫?</summary>
- - Selenium/Playwright 会启动完整的受控浏览器,体积大、指纹明显,容易触发 BOSS 的风控和验证码。
- - 本工具直接连接你已经登录的真实 Chrome(CDP),复用真实指纹和登录态,调用的也是页面内合法的搜索 API,返回的 `salaryDesc` 本就是明文——不需要解析被字体反爬加密的 DOM 薪资。
- - 因此比传统 DOM 抓取类爬虫更稳定,也更难被识别为自动化流量。
- </details>
- ## 安装
- ### 方式 1:克隆到本地再安装(推荐)
- 由于 `hermes skills install` 的网络请求在某些环境下可能无法直接访问 GitHub,推荐先克隆仓库再本地安装:
- ```bash
- # 1. 克隆仓库
- git clone https://github.com/eatmoreduck/boss-zhipin-scraper.git
- cd boss-zhipin-scraper
- # 2. 复制到 Hermes skills 目录
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts
- cp SKILL.md ~/.hermes/skills/data-science/boss-zhipin-scraper/
- cp scripts/boss_cdp_raw.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
- cp scripts/job_summary.py ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data
- cp data/city_codes.json ~/.hermes/skills/data-science/boss-zhipin-scraper/data/
- ```
- ### 方式 2:curl 一键安装
- 不需要克隆整个仓库,直接下载必要文件:
- ```bash
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/SKILL.md \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/SKILL.md && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/boss_cdp_raw.py \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/boss_cdp_raw.py && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/scripts/job_summary.py \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/job_summary.py && \
- mkdir -p ~/.hermes/skills/data-science/boss-zhipin-scraper/data && \
- curl -sL https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/data/city_codes.json \
- -o ~/.hermes/skills/data-science/boss-zhipin-scraper/data/city_codes.json
- ```
- ### 方式 3:hermes skills install(需网络直连 GitHub)
- ```bash
- hermes skills install https://raw.githubusercontent.com/eatmoreduck/boss-zhipin-scraper/master/SKILL.md --category data-science
- ```
- > 注意:此方式依赖 hermes 进程能直接访问 GitHub,如果遇到超时或连接失败,请使用方式 1 或 2。
- ### 方式 4:skills.sh 一键安装(Claude Code 等 Agent Skills 兼容 agent)
- ```bash
- npx skills add eatmoreduck/boss-zhipin-scraper
- ```
- [skills.sh](https://skills.sh) 已收录本技能。任何支持 Agent Skills 格式的 agent(Claude Code、Codex、Gemini CLI、Cursor 等)都可以用这条命令安装,SKILL.md、脚本和城市码表随技能一起分发,按提示选择要安装到哪个 agent 即可。
- ### 方式 5:ClawHub 安装(OpenClaw / clawhub CLI)
- 本技能已上架 [ClawHub](https://clawhub.ai)(OpenClaw 生态的技能注册表),OpenClaw 用户可一条命令安装:
- ```bash
- npx clawhub@latest install @eatmoreduck/boss-zhipin-scraper
- ```
- ### 方式 6:作为 Python 包安装(pip / uv)
- 不装技能、当命令行工具用:直接从 Git tag 或 Release 页安装(不上 PyPI,依赖自动从 PyPI 解析),装完即有 `boss-scraper` / `boss-summary` 命令:
- ```bash
- # 指定版本(git tag)
- pip install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
- # 永远装最新 Release(固定 URL,版本以 wheel 元数据为准)
- pip install https://github.com/eatmoreduck/boss-zhipin-scraper/releases/latest/download/boss_zhipin_scraper-latest-py3-none-any.whl
- # uv(推荐,全局命令)
- uv tool install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
- ```
- 完整用法见下文[「作为命令行工具使用」](#作为命令行工具使用)。
- ### 验证安装
- ```bash
- # 检查文件是否存在
- ls ~/.hermes/skills/data-science/boss-zhipin-scraper/SKILL.md
- ls ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/boss_cdp_raw.py
- ls ~/.hermes/skills/data-science/boss-zhipin-scraper/scripts/job_summary.py
- ls ~/.hermes/skills/data-science/boss-zhipin-scraper/data/city_codes.json
- ```
- 安装后直接在 Hermes 对话中说"帮我搜一下 BOSS直聘 上上海的 AI Agent 岗位"。
- ## 作为命令行工具使用
- 不想装成 Skill 也可以直接当 CLI 用。自 v2.4.0 起每个版本都会发布 [GitHub Release](https://github.com/eatmoreduck/boss-zhipin-scraper/releases)(附可直接安装的 whl),无需上 PyPI:
- ```bash
- # 方式 A:从 Git 安装指定版本(无需手动下载文件;依赖会自动从 PyPI 解析)
- pip install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
- # uv 用户(推荐,装完即有 boss-scraper / boss-summary 全局命令):
- uv tool install "git+https://github.com/eatmoreduck/boss-zhipin-scraper.git@v2.4.0"
- # 方式 B:从 Release 页下载 whl 直装
- pip install https://github.com/eatmoreduck/boss-zhipin-scraper/releases/download/v2.4.0/boss_zhipin_scraper-2.4.0-py3-none-any.whl
- # 或固定 URL 永远装最新 Release:
- pip install https://github.com/eatmoreduck/boss-zhipin-scraper/releases/latest/download/boss_zhipin_scraper-latest-py3-none-any.whl
- # 安装后直接使用入口命令
- boss-scraper --setup-chrome
- boss-scraper --check
- # 方式 C:克隆源码运行(不安装)
- git clone https://github.com/eatmoreduck/boss-zhipin-scraper.git
- cd boss-zhipin-scraper
- pip install -r requirements.txt
- ```
- 源码方式后续步骤相同:
- ```bash
- # 启动 Chrome CDP(也可改用 --setup-edge)
- python3 scripts/boss_cdp_raw.py --setup-chrome
- # macOS 会自动选择已安装的 Google Chrome 或 /Applications/Chromium.app
- # 首次使用也不会复制主 Chrome 登录态;请在弹出的 BOSS 专用浏览器中登录 zhipin.com
- # setup 会等待登录完成,并确认接口能返回明文薪资
- # 检查环境
- python3 scripts/boss_cdp_raw.py --check
- # 可选:真实浏览器/API smoke test(不写结果文件)
- python3 scripts/boss_cdp_raw.py --smoke-test
- # 抓取
- python3 scripts/boss_cdp_raw.py --keyword "AI Agent" --city 上海 --pages 3 --format csv --analysis
- # 抓取后摘要和提示词
- python3 scripts/job_summary.py --top 15
- ```
- ## 参数
- | 参数 | 说明 |
- |------|------|
- | `--keyword` | 搜索关键词(默认 "AI Agent") |
- | `--company` | 按公司名本地过滤已抓取结果(匹配 `boss_name` 子串,英文逗号、中文逗号或顿号分隔多家,不区分大小写)。不改搜索 URL,零额外请求。见下方说明 |
- | `--city` | 城市(中文或 9 位代码,默认上海)。**支持全国城市**(一二三四五线全覆盖,共 300+ 个),运行时自动从 BOSS 同步最新城市码;码表见 [`data/city_codes.json`](data/city_codes.json),或用 `--list-cities` 查看。本地及在线码表均无法识别的城市名会报错退出,避免静默得到 0 条结果 |
- | `--list-cities [关键词]` | 打印支持的城市列表,可选关键词过滤,如 `--list-cities 江` |
- | `--pages` | 页数(上限 20) |
- | `--format` | json / csv;csv 会同时导出列表和详情 CSV |
- | `--detail` | 抓取详情页 JD(默认开启) |
- | `--no-detail` | 不抓取详情页 |
- | `--analysis` | 分析报告 |
- | `--merge FILE` | 合并已有数据(按 job_id 去重) |
- | `--diff-base FILE` | 指定 `is_new` 对比基准文件(默认自动取同关键词同城市、公司过滤条件一致、文件名日期早于本轮的最近一份结果;无基准时全体视为新增;文件缺失或损坏时直接报错终止,不会静默按空基准对比) |
- | `--allow-dom-fallback` | API 无数据时允许降级 DOM 提取;默认关闭,薪资可能不可信 |
- | `--check` | 环境检查(CDP + 依赖 + 登录态) |
- | `--smoke-test` | 用真实 Chrome/CDP 跑一次 BOSS 搜索 API smoke test,不写结果文件 |
- | `--setup-chrome` | 一键启动 Chrome CDP(持久隔离 profile) |
- | `--setup-edge` | 一键启动 Microsoft Edge CDP(持久隔离 profile) |
- | `--browser` | 配合 `--setup-chrome` 选择 `chrome` 或 `edge`(默认 `chrome`);`--setup-edge` 固定 Edge,显式传 `--browser chrome` 会以 `--setup-edge` 为准并提示 |
- | `--copy-login-state` | 手动导入主浏览器(`--setup-chrome` 取主 Chrome、`--setup-edge` 取主 Edge)的 Local State + Cookie 相关文件到隔离 profile(默认、首次启动、重复启动都不复制) |
- | `--reset-chrome-profile` | 重建 BOSS 专用 Chrome profile,会清除此专用浏览器内的登录态 |
- | `--no-wait-login` | `--setup-chrome` 启动后不等待登录完成 |
- | `--login-timeout` | `--setup-chrome` 等待登录完成的秒数(默认 300) |
- | `--stop-chrome` | 关闭 BOSS 专用 CDP Chrome(按隔离 profile 精准匹配,不碰主 Chrome) |
- | `--stop-edge` | 关闭 BOSS 专用浏览器 CDP(与 `--stop-chrome` 共用隔离 profile) |
- | `--close-chrome` | 抓取正常结束后自动关闭专用 Chrome(默认不关;异常退出不触发,保留登录态) |
- | `--output` | 列表输出路径(默认 `~/.boss-zhipin-scraper/job-result/`) |
- | `--detail-output` | 详情输出路径(默认 `~/.boss-zhipin-scraper/job-result/`) |
- | `--cdp-port` | CDP 端口(默认 9222) |
- | `--scale/--salary/--experience/--degree` | 筛选条件 |
- `--company` 是本地后处理,不进入搜索 URL,也不新增网络请求。匹配字段是列表里的 `boss_name`(来自 joblist 响应的 `brandName`;详情记录回退到 `company`),规则是**不区分大小写的子串包含**。多家公司用 `,`、`,` 或 `、` 分隔,命中任一即保留;重复片段按大小写不敏感去重。
- 过滤发生在 `--merge` 之后、详情抓取和 `--analysis` 之前:合并进来的旧数据按同一公司范围收窄,详情只抓保留下来的岗位,分析报告只统计这些岗位。`--input` 且未加 `--output` 时只在内存中过滤,不改写原文件;抓取产生的结果文件,或显式 `--output`,会整文件替换为过滤后的集合(不会把已丢掉的公司再合并回来),并写入 `company_filter`。`is_new` 的自动基准除了同关键词、同城市,还要求 `company_filter` 归一化后一致(大小写、顺序、分隔符不敏感)。升级前没有该字段的旧文件视为「未过滤」,不带 `--company` 的抓取仍按原来的方式对比。`--diff-base` 显式指定基准时跳过这套自动匹配。终端里的逐条抓取日志仍是捕获到的全量列表,过滤条数在抓取结束后打印。
- ```bash
- # 抓取后只保留目标公司
- python3 scripts/boss_cdp_raw.py --keyword "Java" --city 上海 --pages 3 --company "字节跳动,阿里巴巴" --analysis
- # 对已有 JSON 按公司重新分析,不改写原文件
- python3 scripts/boss_cdp_raw.py --input ~/.boss-zhipin-scraper/job-result/boss_jobs_20260609_1200.json --company SHEIN --analysis --no-detail
- ```
- ## 抓取后摘要与提示词
- `scripts/job_summary.py` 只读取已抓取的 `boss_jobs_*.json` 和 `boss_details_*.json`,做简单聚合分析并生成一段可复制提示词。它不读取本地简历文件,不引入 PDF 依赖,也不给个人与岗位做分数判断。
- ```bash
- # 读取默认结果目录下最新的 boss_jobs_*.json,并自动匹配同时间戳或最新详情文件
- python3 scripts/job_summary.py
- # 指定列表和详情文件
- python3 scripts/job_summary.py \
- --input ~/.boss-zhipin-scraper/job-result/boss_jobs_20260625_1200.json \
- --details ~/.boss-zhipin-scraper/job-result/boss_details_20260625_1200.json \
- --top 15
- # 只输出提示词
- python3 scripts/job_summary.py --prompt-only
- # 摘要前按公司名过滤(与抓取命令的 --company 规则相同,纯本地)
- python3 scripts/job_summary.py --company "字节跳动,SHEIN"
- ```
- 打包安装后也可以使用入口命令:
- ```bash
- uv run boss-summary --top 15
- ```
- 摘要会覆盖这些维度:薪资区间、经验要求、学历要求、地区分布、高频公司、技能标签、JD 高频词。提示词会要求模型基于这些统计去做简历关键词补齐、项目经历改写方向和面试准备清单,但明确要求不要虚构经历。
- ## 文件结构
- ```
- boss-zhipin-scraper/
- ├── SKILL.md # Hermes Skill 定义
- ├── README.md
- ├── CHANGELOG.md
- ├── LICENSE
- ├── pyproject.toml
- ├── data/
- │ └── city_codes.json # 全量城市码表
- ├── scripts/
- │ ├── boss_cdp_raw.py # 抓取主脚本
- │ └── job_summary.py # 抓取后摘要 + 提示词
- └── requirements.txt
- ```
- ## 工作原理
- 这是一个基于 Chrome CDP 的 BOSS直聘爬虫,核心流程:
- 1. 通过 Chrome DevTools Protocol (CDP) 连接到已打开的 Chrome
- 2. 导航到真实搜索页,通过 CDP `Network` 域**被动捕获页面自身发出的搜索 API 响应**(不发任何注入请求,规避 BOSS 对注入 XHR 的风控识别)
- 3. 翻页通过滚动触发页面自身的无限滚动加载,继续旁听其请求;API 返回明文 `salaryDesc`,绕过前端字体反爬
- 4. 列表 API 保留 `securityId` / `lid` 等上下文,进入详情页时带上这些参数
- 5. 每页抓完立即写入文件,按 `job_id` 去重
- 默认不会使用 DOM 提取列表,因为 DOM 薪资可能受字体反爬影响。只有明确传 `--allow-dom-fallback` 时,API 无数据才会降级 DOM。
- 详情页只从包含“职位描述”的详情区提取 JD,整页 `body` 仅用于识别登录墙和导航页,不会直接写入结果。若页面出现“登录查看完整内容”,抓取会明确报错并停止,避免把截断正文、招聘者信息、公司介绍和推荐职位当成完整 JD 保存。
- `--input ... --analysis --no-detail` 会优先加载 `--detail-output`,其次加载与输入列表同目录、同时间戳的 `boss_details_*.json`,最后查找 `~/.boss-zhipin-scraper/job-result` 下最新详情文件。
- ## 浏览器 profile 安全策略
- `--setup-chrome` 默认使用持久隔离 profile,不软链接、不复制你的主 Chrome 数据。首次启动和后续重复启动都只是创建或复用这个专用 profile:
- - `~/.boss-zhipin-scraper/chrome-profile`
- 未显式指定 `--output` 或 `--detail-output` 时,抓取结果默认保存到:
- - `~/.boss-zhipin-scraper/job-result`
- 首次使用需要在这个专用浏览器中手动登录 BOSS直聘。`--setup-chrome` 和 `--setup-edge` 都会等待登录完成并确认接口能返回明文 `salaryDesc`;登录态保存在专用 profile 内,重启机器后仍然保留,也不会影响主 Chrome、Edge、Gmail、GitHub 等账号。
- 登录探测不向页面注入任何请求:`--setup-chrome` 等待登录时会在不同关键词/城市之间轮换导航真实搜索页,被动捕获页面自身发出的搜索响应,等待间隔从 3 秒逐步退避到最多 15 秒;这些页面请求同样计入单次 500 次的全局请求预算。正式抓取不再单独发送固定关键词的探测请求,登录/风控判定直接用第一次真实搜索的响应完成。未登录、探测样本为空、接口限制和响应异常会分别提示。遇到已确认的限制状态(例如 `code: 31`、`code: 37`「您的环境存在异常」)会立即停止探测,不会继续提示重复登录或密集重试;对未知风控码还会按 message 关键字(环境存在异常、访问频繁、安全校验等)兜底识别为限制状态,避免把「已登录但被风控」误判为登录失败。
- `--setup-chrome` 的交互式登录页是唯一会主动置前的临时页面;环境检查、列表/详情抓取和 smoke test 创建的临时标签页都会在后台运行,避免自动流程反复抢占当前窗口。这里的“后台”仅表示不激活标签页,专用 Chrome 仍以有界面模式运行,必要时可以手动打开检查。
- 如确实需要从主 Chrome 手动导入 BOSS 登录态,可以显式运行:
- ```bash
- python3 scripts/boss_cdp_raw.py --setup-chrome --copy-login-state
- ```
- `--copy-login-state` 每次运行都会覆盖隔离 profile 内对应的 Cookie 相关文件;日常启动不要加这个参数。它只复制 `Local State` 和 `Default/Cookies*`、`Default/Network/Cookies*` 这类 Cookie 数据库相关文件,不复制密码库、历史记录、扩展或完整 profile。
- macOS 上的导入源会与自动选中的浏览器保持一致:Google Chrome 使用 `~/Library/Application Support/Google/Chrome`,Chromium 使用 `~/Library/Application Support/Chromium`。
- 需要清空专用浏览器登录态时使用:
- ```bash
- python3 scripts/boss_cdp_raw.py --setup-chrome --reset-chrome-profile
- ```
- ### 用完如何收尾
- 抓取/分析结束后,专用 Chrome 不会自动关闭(默认保留登录态,方便你接着跑下一条抓取)。确认不再使用时,可以手动收尾:
- ```bash
- python3 scripts/boss_cdp_raw.py --stop-chrome
- ```
- `--stop-chrome`/`--stop-edge` 只关闭 scraper 隔离 profile(`--user-data-dir`)对应的 Chrome 或 Edge 进程,**绝不**按端口或进程名去 kill,因此不会误伤你正在用的主 Chrome、Edge、Gmail、GitHub 等账号。
- 如果你希望某次抓取正常结束后就顺手关掉 Chrome,可以加 `--close-chrome`:
- ```bash
- python3 scripts/boss_cdp_raw.py --keyword "AI Agent" --city 上海 --pages 3 --close-chrome
- ```
- `--close-chrome` 默认不开启;且只在抓取走完的**成功路径**上触发,登录失败、异常退出等情况不会关闭 Chrome,登录态得以保留。
- ## 📌 TODO
- - [ ] 详情页抓取补强 Referer 与请求指纹,进一步降低风控触发概率
- ## License
- MIT
- ## ☕ 请作者喝杯咖啡
- 这个项目的每一行代码都是 AI agent 烧 token 写出来的——所以打赏不会变成咖啡,而是变成下一轮对话的 token。如果它帮到了你的求职,欢迎续一杯:
- <p align="center"><img src="assets/reward-qr.png" width="220" alt="微信赞赏码"></p>
- ## 友情链接
- - [LINUX DO](https://linux.do/) — 真诚、友善、充满活力的技术社区,本项目认可并推荐。
- ## 作者
- eatmoreduck 多吃鸭 — 上海风控架构师,10 年全栈、7 年风控研发。
- [主页](https://www.eatmoreduck.com) · [博客](https://blog.xiaohuangyu.space) · [X](https://x.com/eatmoreduck98)
- ## Star History
- [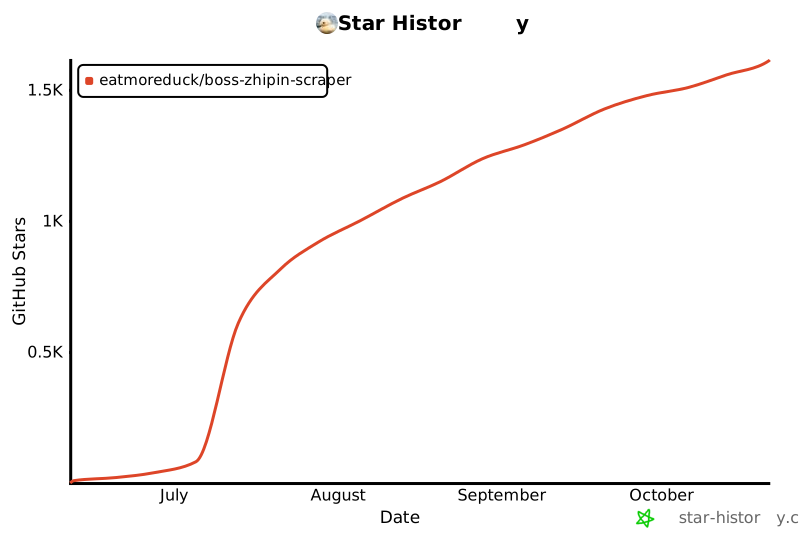](https://www.star-history.com/?type=date&repos=eatmoreduck%2Fboss-zhipin-scraper)
Ratings and comments
Sign in to rate this skill.
Sign inFree to use. If it’s helped, pass it on.